
Oltre l'IA integrata: Ottimizzazione della pipeline di percezione termica dai dati del sensore all'implementazione Edge
ABSTRACT
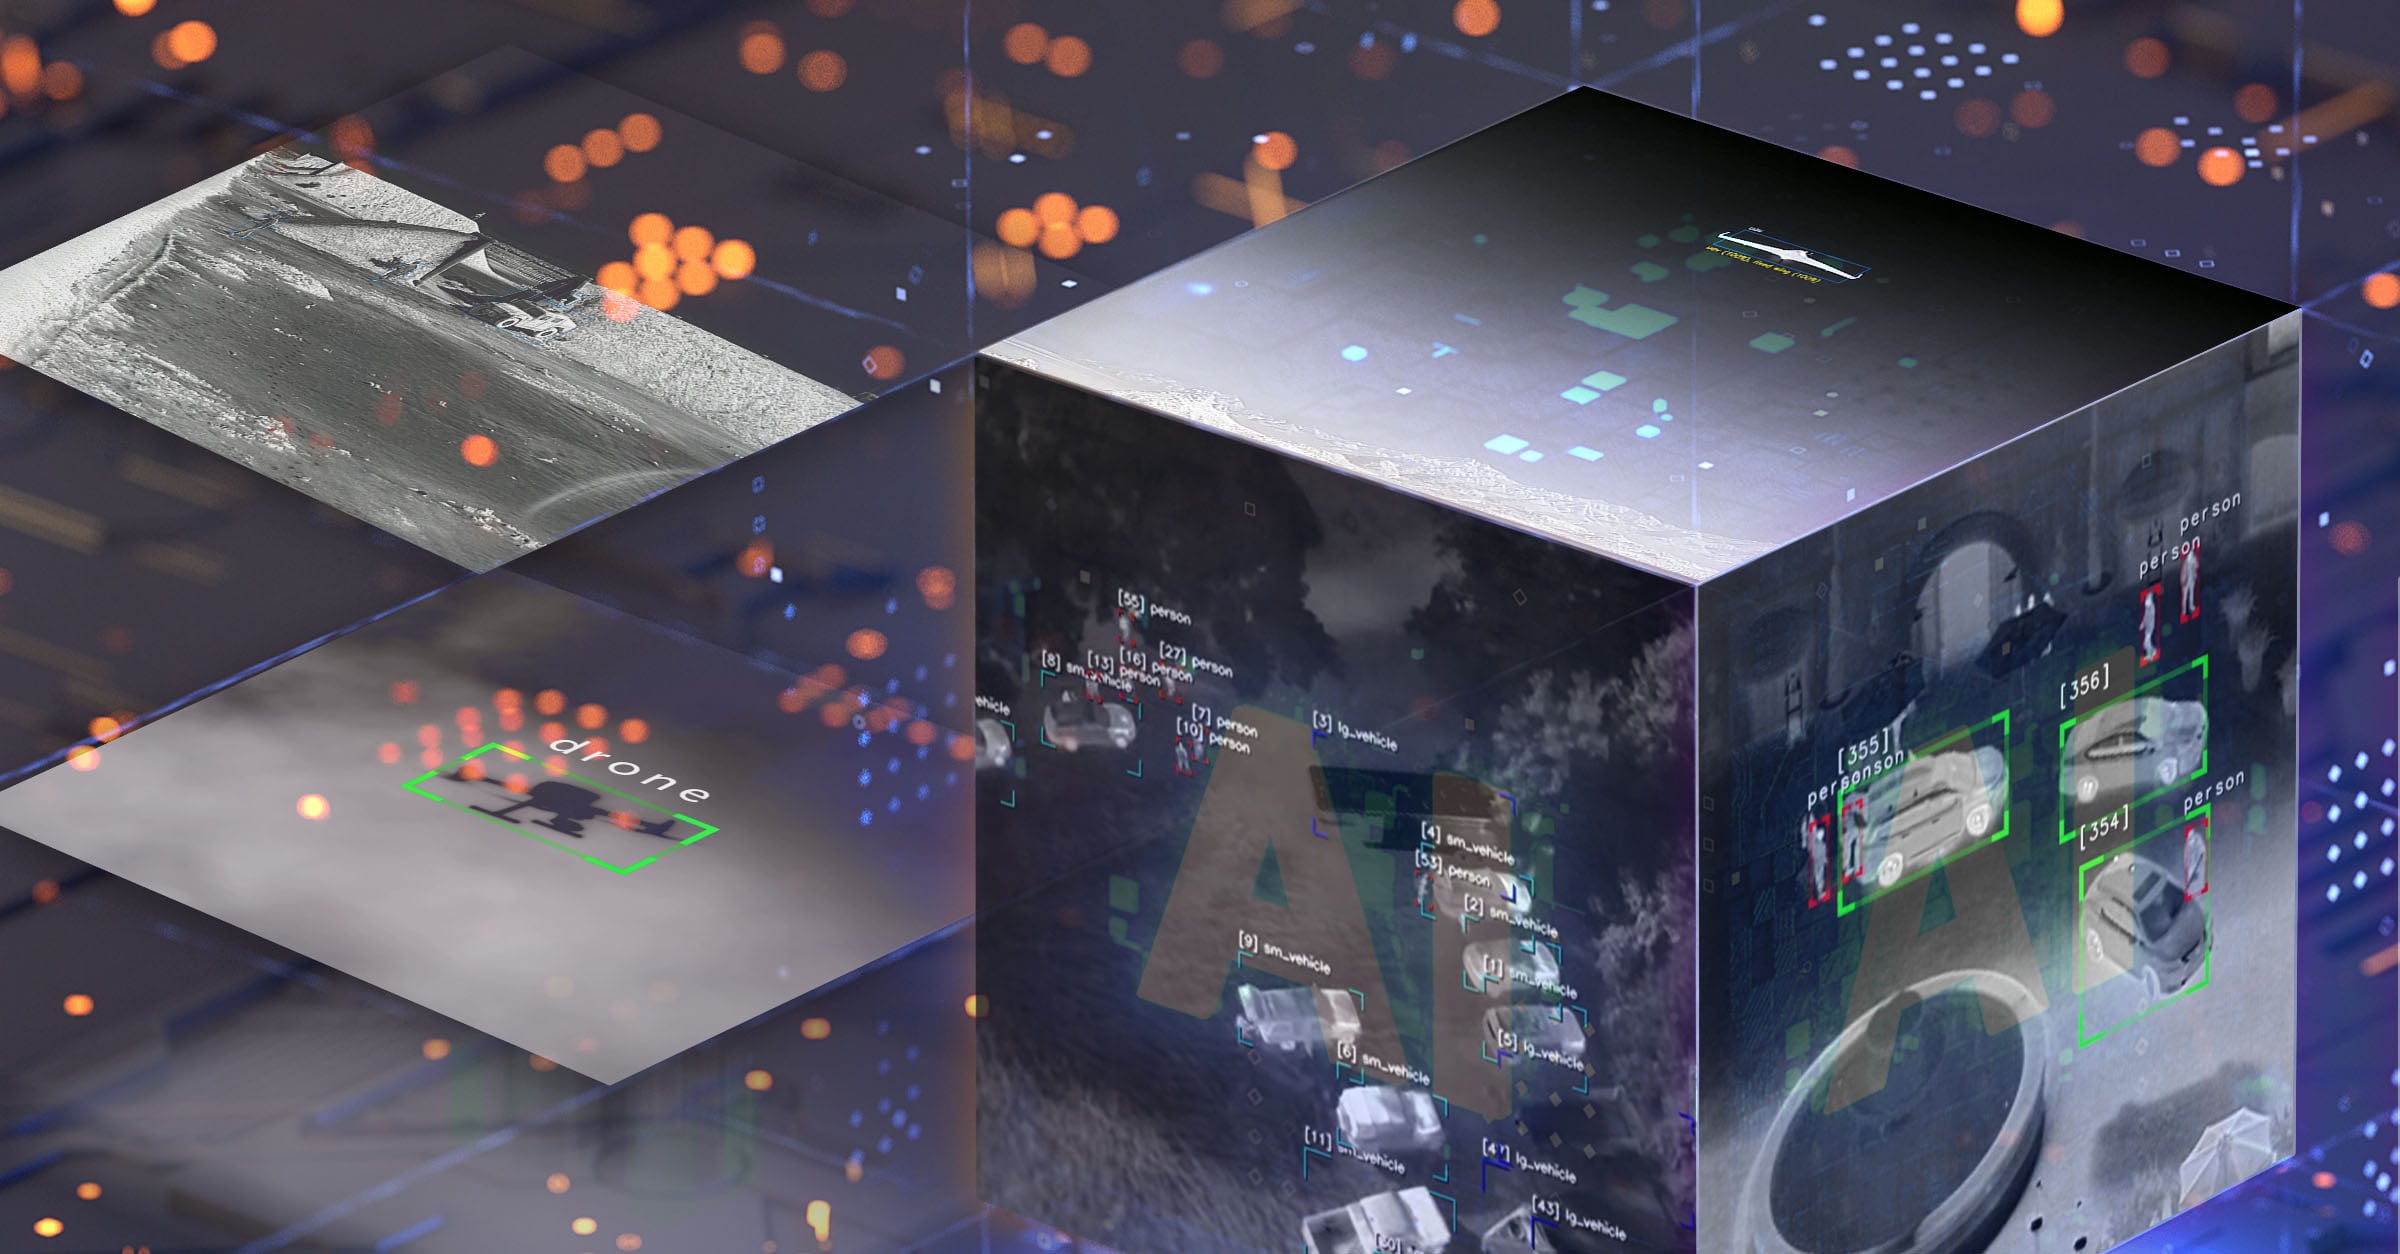
I rapidi progressi nel deep learning, nell'imaging computazionale e nei processori integrati hanno consentito di eseguire sofisticati carichi di lavoro di percezione ai margini. Per i sistemi termici e multispettrali, il vantaggio competitivo va oltre il posizionamento di un modello di intelligenza artificiale (IA) su un processore integrato. Il vantaggio maggiore deriva dall’ottimizzazione dell’intera pipeline di percezione, dall’elaborazione dei dati dei sensori e del segnale delle immagini al rilevamento degli oggetti, al tracciamento, all’ottimizzazione del runtime, alla gestione termica e all’implementazione sul campo, in condizioni reali di dimensioni, peso, potenza, latenza, larghezza di banda e condizioni ambientali.
Questo documento descrive come Teledyne FLIR OEM integra l'elaborazione del segnale termico e multispettrale di Prism™, le librerie di rilevamento e tracciamento specifiche per l'applicazione e le moderne piattaforme IA integrate per aiutare i clienti a costruire sistemi di imaging intelligenti che forniscono informazioni fruibili nel punto di rilevamento.
.
SOMMARIO
- Acroincini
- Introduzione
- Progressi nei modelli leggeri e nei processori mobili
- Progettazione di una rete neurale per piattaforme integrate - Presentazione di PeleeTM
- Ottimizzazione
- La potenza dello sviluppo rapido dei processori mobili
- Framework
- Pipeline di elaborazione video
- Funzioni Prism ISP
- Conclusioni
1. Acrioni
| Acronimo | Definizione |
|---|---|
| ADAS | Sistemi avanzati di assistenza alla guida |
| AGC | Controllo automatico del guadagno |
| IA | Intelligenza artificiale |
| BRACCIO | Architettura avanzata del processore RISC Machine |
| ASIC | Circuito integrato specifico per l'applicazione |
| ATR | Riconoscimento automatico del bersaglio |
| CI | Imaging computazionale |
| CNN | Rete neurale convoluzionale |
| CPU | Unità di elaborazione centrale |
| DSP | Processore segnale digitale |
| FFB | Blocco fusione funzioni |
| FPGA | Array di porte programmabile sul campo |
| GPU | Unità di elaborazione grafica |
| HTP | Processore tensore esagonale |
| ILSVRC | La sfida del riconoscimento visivo su larga scala ImageNet |
| INT | Formato di precisione intero, come in INT8 o INT4 |
| IP | Proprietà intellettuale |
| IR | Infrarossi |
| ISR | Intelligenza, sorveglianza e ricognizione |
| ISP | Elaborazione segnale immagine / Processore segnale immagine |
| LCE | Miglioramento del contrasto locale |
| MSX | Multi-Spectral Dynamic Imaging |
| NMS | Soppressione non massima |
| NPU | Unità di elaborazione neurale |
| ONNX | Apri scambio rete neurale |
| PANTALONE | Funzione di aggregazione percorso Rete a piramide |
| RAM | Memoria ad accesso casuale |
| RISC | Computer con set di istruzioni ridotto |
| SDK | Kit di sviluppo software |
| SLAM | Localizzazione e mappatura simultanee |
| SoC | Sistema su chip |
| SoM | Sistema sul modulo |
| SSD | Rilevatore a scatto singolo |
| SWaP | Dimensioni, peso e potenza |
| TOP | Trilioni di operazioni al secondo |
| YOLO | Guarda solo una volta |
2. Introduzione
Nell'ultimo decennio, i progressi nel deep learning hanno trasformato la visione artificiale da sistemi costruiti intorno all'estrazione di funzionalità artigianali in modelli basati sui dati addestrati su grandi set di dati e ottimizzati per attività di percezione specializzate. Questo cambiamento ha cambiato radicalmente le sfide del rilevamento di oggetti: invece di progettare a mano funzioni visive fisse, gli sviluppatori ora si concentrano sulla raccolta di dati di addestramento rappresentativi, sulla selezione di architetture di modello appropriate e sull’adattamento di reti neurali sempre più sofisticate alle condizioni di implementazione del mondo reale. Come spesso accade nei primi sviluppi tecnologici, inizialmente è stata prestata meno attenzione alla potenza di calcolo necessaria per addestrare ed eseguire questi modelli.
Questa mancanza di preoccupazione ha limitato il modo in cui la nuova tecnologia poteva essere utilizzata nei sistemi basati sulla visione, in particolare nelle applicazioni video-centriche in cui la necessità di classificazione degli oggetti in tempo reale, generazione di metadati e avvisi è fondamentale. Allo stesso tempo, nel settore dei telefoni cellulari era in corso una gara sulle armi per quanto riguarda le prestazioni delle termocamere. Ciò ha portato al rapido sviluppo di processori di segnale di immagine (ISP) altamente avanzati che hanno consentito prestazioni della termocamera in continuo miglioramento utilizzando algoritmi e ciò che ora viene chiamato imaging computazionale (CI). Più recentemente, la rapida adozione di modelli linguistici di grandi dimensioni, modelli di linguaggio visivo e IA multimodale ha aumentato la domanda di processori eterogenei in grado di eseguire sia pipeline di visione tradizionali che carichi di lavoro più recenti ispirati ai modelli di base più vicini al sensore.
I processori odierni sono dotati di architetture eterogenee con più unità di elaborazione centrale (CPU), unità di elaborazione grafica (GPU), processori di segnale digitale (DSP), unità di elaborazione neurale (NPU) e blocchi di calcolo ISP. Inoltre, la community open source ha contribuito a molti dei componenti fondamentali utilizzati per creare sistemi di percezione, tra cui rilevatori di oggetti della famiglia YOLO, modelli di rilevamento basati su trasformatori, formati di file indipendenti dalla piattaforma come Open Neural Network Exchange (ONNX), framework di sviluppo tra cui PyTorch e TensorFlow e runtime di produzione come TensorRT, ONNX Runtime, OpenVINO, LiteRT/TensorFlow Lite e kit di sviluppo software (SDK) specifici per hardware. È diventato un flusso di lavoro comune per addestrarsi in PyTorch o TensorFlow, esportare in ONNX, ottimizzare e quantificare per il runtime di destinazione, e quindi convalidare latenza, potenza, utilizzo della memoria e accuratezza direttamente sull'hardware distribuito.
Teledyne FLIR OEM si concentra sull'integrazione della percezione e dell'imaging computazionale o dell'elaborazione del segnale di immagine su processori ottimizzati per dimensioni, peso e potenza (SWaP) per un'ampia gamma di applicazioni. Sfruttare i nuovi design in silicio realizzati sui nodi più avanzati consente agli sviluppatori di sistemi di aumentare la durata della batteria e semplificare la gestione termica del sistema.
Questa è la sfida di progettazione centrale per i sistemi termici intelligenti. Le tecniche di intelligenza artificiale con telecamera visibile non possono essere semplicemente trasferite alla termografia senza tenere conto della fisica del sensore, del contenuto di texture inferiore, della variabilità ambientale, degli effetti atmosferici, della dimensione del bersaglio, dell'ottica, della frequenza dei fotogrammi, della calibrazione e delle fasi di elaborazione delle immagini che modellano ciò che il sensore vede. In pratica, le prestazioni di rilevamento e tracciamento dipendono dall’intera catena: dati grezzi del sensore, elaborazione radiometrica o non radiometrica, mappatura dei toni, denoising, stabilizzazione, super risoluzione, architettura del modello, quantizzazione, mappatura del runtime, larghezza di banda della memoria e gestione dell’alimentazione. Il vantaggio di Teledyne FLIR OEM risiede nella sua capacità di ottimizzare l'intera catena, piuttosto che trattare l'inferenza IA come una funzione autonoma.
3. Progressi nei modelli leggeri
e processori mobili
Una volta riconosciuto l'impatto del deep learning sulla computer vision, è iniziato il lavoro sullo sviluppo di reti neurali e modelli che potevano essere eseguiti ai margini su processori mobili a basso costo, consentendo il rilevamento di oggetti per applicazioni video in tempo reale, tra cui il riconoscimento automatico del bersaglio (ATR), l'autonomia dei veicoli, i sistemi avanzati di assistenza alla guida (ADAS), la sicurezza e per l'intelligenza, la sorveglianza e la ricognizione terrestri e aerei (ISR). Altri pacchetti software incorporati nei prodotti basati sulla visione includono localizzazione e mappatura simultanee (SLAM), prevenzione delle collisioni, fusione dei sensori, flusso ottico e tracciamento degli oggetti. Queste funzionalità computazionalmente impegnative, quando compilate per una specifica architettura hardware, sono mappate tra CPU, GPU, DSP, NPU, ISP e sottosistemi di memoria all'interno del sistema target su chip (SoC). La gestione di queste attività attraverso i moderni processori eterogenei è una sfida ingegneristica significativa, ma offre importanti vantaggi in termini di potenza, latenza e gestione termica rispetto alle architetture dipendenti dal cloud. In poche generazioni di processori, i SoC avanzati si sono spostati da nodi di classe 10 nm a design di classe 7 nm, 5 nm e 4 nm, ottenendo prestazioni per watt notevolmente migliorate.
Tabella 1 - Moduli e processori IA Edge integrati rappresentativi
| PIATTAFORMA | NODO DI PROCESSO | PRESTAZIONI AI | INTERVALLO DI POTENZA | CASI DI UTILIZZO MIGLIORI |
|---|---|---|---|---|
| Kit per super sviluppatori NVIDIA Jetson Orin Nano | Classe 8 nm | Fino a 67 TOPS INT8 | Da 7 W a 25 W configurabili | Prototipazione, robotica, IA di visione, IA edge multimodale ed ecosistemi di sviluppatori con supporto CUDA e TensorRT. |
| NVIDIA Jetson AGX Orin | Classe 8 nm | Fino a 275 TOPS | Da 15 W a 60 W configurabili | Robotica ad alte prestazioni, percezione multi-camera, sistemi autonomi e carichi di lavoro IA edge più grandi. |
| Qualcomm Dragonwing QCS8550 | 4 nm | Fino a 48 TOPS INT8, a seconda dell'implementazione del modulo | Dipende dall'applicazione | Telecamere intelligenti, droni industriali, robot mobili autonomi, scatole IA edge e piattaforme IoT a basso consumo altamente integrate. |
| Acceleratori Hailo-8 / Hailo-10-class | A seconda dell'acceleratore | Da decine a centinaia di TOPS, a seconda del dispositivo | Classe acceleratore a bassa potenza | Accelerazione della visione in telecamere, gateway, sistemi industriali e implementazioni sensibili ai costi o all'alimentazione. |
L'elaborazione del segnale di immagine e gli algoritmi di rilevamento degli oggetti IA sono costosi dal punto di vista computazionale. Ad esempio, gli algoritmi avanzati di denoising e super risoluzione degli OEM di Teledyne FLIR eseguono fino a 100.000 operazioni al pixel al secondo (circa 2 trilioni di operazioni al secondo (TOPS) per un ingresso di risoluzione 640x512 a 60 frame al secondo (fps)) ed eseguono su un core GPU. L'esecuzione di modelli di rilevamento di oggetti di grandi dimensioni consuma anche molta potenza di elaborazione e funziona sul sottosistema DSP (Qualcomm®) o GPU (NVIDIA®).
Per i sistemi termici, il TOPS grezzo è una metrica utile ma incompleta. Le prestazioni reali dipendono dall'efficienza con cui ogni fase della pipeline viene mappata alla risorsa di calcolo appropriata, dal numero di volte in cui i dati video devono spostarsi attraverso la memoria, dal fatto che il miglioramento dell'immagine migliori o degradi la fiducia del sensore e se l'intero sistema può sostenere i frame rate richiesti senza superare i limiti di potenza o termici. I progetti IA integrati più efficaci iniziano quindi con il problema del rilevamento e l'ambiente di implementazione, non solo con le specifiche del processore.
Ci sono molte variabili da considerare quando si sviluppa e si implementa un rilevatore di oggetti, tra cui architettura del processore, accuratezza desiderata, latenza o frame rate accettabile, larghezza di banda della memoria, runtime del software, dimensione del modello e budget di potenza/termico. In risposta alla richiesta di eseguire rilevatori di oggetti su processori integrati, sono state sviluppate diverse reti neurali a bassa potenza, tra cui You Only Look Once (YOLO) di Joseph Redmon dell’Università di Washington nel 2015 e MobileNet by Google nel 2017. Da allora, il panorama dei rilevatori si è ampliato notevolmente per includere i nuovi modelli della famiglia YOLO, i rilevatori basati su trasformatori, le architetture senza soppressione massima (NMS) e i modelli progettati per la percezione multi-attività e il rilevamento a voce aperta. Per i sistemi termici e multispettrali integrati, la domanda più importante non è semplicemente quale rete è più recente, ma quale modello offre le prestazioni di rilevamento richieste, la latenza, il consumo energetico e l’affidabilità dell’integrazione sul processore selezionato.
YOLO ha rivoluzionato il rilevamento degli oggetti con il suo approccio single-pass. A differenza delle reti neurali convoluzionali basate sulla regione (RCNN) che coinvolgono più fasi, come le proposte regionali seguite dalla classificazione, YOLO realizza il rilevamento e la localizzazione in un unico passaggio avanti della rete. Dividendo un'immagine in ingresso in una griglia e prevedendo contemporaneamente più riquadri di delimitazione e probabilità di classe per ogni cella della griglia, l'algoritmo YOLO offre velocità e accuratezza. I rilevatori monofase utilizzano una singola rete feed-forward per prevedere direttamente classi e posizioni di oggetti. Single Shot Detector (SSD) migliora YOLO in diversi aspetti, tra cui l'uso di più scale di funzioni per la previsione e l'uso di riquadri e proporzioni predefiniti per la regolazione a diverse forme di oggetto. Mentre gli approcci a due fasi generalmente producono una maggiore accuratezza, gli approcci a uno stadio spesso operano a una maggiore efficienza. I rilevatori più recenti continuano a migliorare questo spazio commerciale attraverso una migliore aggregazione delle funzionalità, un design consapevole della quantizzazione, meccanismi di attenzione ispirati ai trasformatori e architetture facili da implementare che riducono i costi di post-elaborazione.
4. Progettazione di una rete neurale per piattaforme integrate - Presentazione di Pelee

Figura 1 - Architettura del rilevatore di oggetti (Juan R. Terven, 2023)
La progettazione del rilevamento di oggetti per le termocamere richiede un punto di partenza diverso rispetto alla scelta di un modello di visione generico. Le immagini termiche spesso contengono meno texture visive rispetto alle immagini visibili; i bersagli possono occupare solo un piccolo numero di pixel; e le condizioni ambientali possono cambiare contrasto, forma apparente e disordine dello sfondo. Questi fattori rendono importante la co-progettazione del rilevatore con il sensore, l'ottica, la pipeline di elaborazione delle immagini e l'hardware di implementazione.
Teledyne FLIR OEM ha esteso l'approccio single-pass con lo sviluppo della sua rete Pelee (in attesa di brevetto). Le reti neurali convoluzionali (CNN) sono costituite da tre blocchi principali: l’estrattore di funzionalità o la dorsale; un aggregatore di funzionalità o collo; e il rilevatore di testa o oggetto. Pelee è dotato di un nuovo design backbone costruito con un denso schema di connettività per incoraggiare il riutilizzo delle funzionalità e di uno strato denso bidirezionale per ottenere diverse scale di campi ricettivi. Pelee incorpora un nuovo blocco di fusione delle funzioni (FFB) basato sulla Path Aggregation Feature Pyramid Network (PANet). Progettata pensando al rilevamento di piccoli bersagli, la nuova FFB adotta una strategia di fusione tardiva, che mira a garantire che ogni mappa delle caratteristiche dell’output conservi le informazioni dettagliate apprese dagli strati poco profondi e acquisisca caratteristiche semantiche di alto livello.
| QUADRO | DORSALE | COSTO COMPUTAZIONALE (FLOP) | ||
|---|---|---|---|---|
| Struttura portante | Totali | Porzione di dorsale | ||
| SSD | VGG | 31,9 | 34,2 | 93,3% |
| Affinaet | VGG | 31,9 | 37,38 | 85,3% |
| YOLOv3 | DarkNet 53 | 14,51 | 19,54 | 74,2% |
| RetinaNet | ResNet101 | 15,48 | 34,51 | 53,4% |
La rete dorsale influisce direttamente sulla memoria, la velocità e le prestazioni del rilevatore di oggetti. In SSD CNN, oltre il 90% del costo di calcolo viene consumato dalla rete backbone. La CNN OEM di Teledyne FLIR incorpora un nuovo design backbone che evita l’uso di un blocco di compressione ed eccitazione, seleziona attentamente le funzioni di attivazione in base all’hardware e regola la larghezza e la profondità della rete in base all’hardware.
Pelee deve quindi essere inteso come un'architettura di rilevamento specifica per l'applicazione e orientata all'implementazione, piuttosto che come un benchmark di riferimento generico per ogni nuova famiglia di modelli. Il suo valore è nel settore dell'ingegneria che conta per le termocamere intelligenti: prestazioni di piccoli bersagli, latenza prevedibile, efficienza della memoria, scelte di attivazione basate sull'hardware e la capacità di funzionare insieme alle funzioni ISP Prism, stabilizzazione video, tracciamento e altri carichi di lavoro di percezione all'interno di una busta SWaP vincolata.

Figura 2 - Prestazioni del modello Pelee Backbone

Figura 3 – Confronto prestazioni tra reti Pelee e YOLO
5. Ottimizzazione
Quantizzazione
La quantificazione è la compressione di valori a virgola mobile nei parametri della rete neurale per migliorare la latenza del modello, ridurre l’ingombro della memoria e ridurre il consumo energetico durante l’inferenza. L'addestramento dei modelli viene generalmente eseguito utilizzando dati a virgola mobile a 32 bit su potenti sistemi basati su GPU. L'inferenza sui processori integrati viene quindi ottimizzata utilizzando FP16, FP8, INT8, INT4 o altre precisioni supportate dal runtime a seconda del processore, dell'architettura del modello, dei dati di calibrazione e dei compromessi di accuratezza accettabili.
Teledyne FLIR OEM utilizza INT8 per ridurre l’ingombro della memoria, i tempi di calcolo e il consumo energetico, perché rimane un compromesso pratico tra precisione e velocità per molti carichi di lavoro di visione integrati. Tuttavia, la distribuzione ora dipende sempre più da flussi di lavoro di quantizzazione espliciti, dati di calibrazione rappresentativi, formazione consapevole della quantizzazione quando necessario e generazione di motori specifici per il target. Gli sviluppatori devono convalidare le opzioni FP16, INT8 e di minore precisione sull'hardware effettivo, perché le prestazioni, l'accuratezza, l'uso della memoria e il comportamento termico possono variare significativamente tra le implementazioni GPU, DSP, NPU e runtime specifiche del fornitore. Il recupero delle risorse di calcolo offre agli sviluppatori la flessibilità di aggiungere ulteriori funzionalità, tra cui l'inferenza in tempo reale su due o più feed di telecamere.
Sfoltimento
La potatura è un metodo utilizzato per ridurre i percorsi dei dati inutilizzati nella rete neurale, determinando l'importanza di ciascuna unità e rimuovendo i percorsi passivi. Dopo l’addestramento, molti neuroni della rete hanno un valore di peso di 0, quindi questi neuroni possono essere eliminati attraverso un processo di addestramento secondario della rete dopo la quantizzazione. Gli attuali metodi di potatura includono la potatura del peso, la potatura dei canali e la potatura dei neuroni, ciascuno con i suoi vantaggi e svantaggi.
I criteri per determinare l’importanza dell’unità possono influire sull’accuratezza. L’uso di metodi di apprendimento per i vincoli può migliorarlo, sebbene l’implementazione sia complessa. Il metodo di ricerca casuale della potatura è semplice da implementare, ma le prestazioni del modello di rete sono limitate rispetto ad altri metodi che lo migliorano. Pertanto, ogni metodo deve essere selezionato insieme allo scenario applicativo effettivo. Non esiste un unico metodo in grado di sintetizzare la complessità e l’efficienza della compressione del modello.[i]
Gestione termica
Per molte categorie di prodotti, tra cui droni e mirini per armi, il consumo energetico è un vincolo fondamentale nella progettazione. L'elevato consumo limita i tempi operativi, aggiunge sfide logistiche di supporto e aggiunge complessità e costi per la gestione termica. Per alcuni dispositivi alimentati a batteria, la scelta è utilizzare un array di gate programmabili sul campo (FPGA) o un processore a circuito integrato (ASIC) specifico per l’applicazione per mantenere la potenza al minimo assoluto, ma non sono disponibili analisi di terze parti e software ISP, poiché queste librerie sono tipicamente compilate per l’esecuzione su processori Advanced RISC Machine (ARM) e altri core utilizzando componenti e framework open source come OpenCV. Anche se questo non è il caso dei prodotti più vincolati dalla potenza, i requisiti di potenza dei processori integrati di nuova generazione fabbricati su nodi da 4 nm a 7 nm offrono ai progettisti di sistemi molte opzioni per aggiungere funzionalità di alto valore ai prodotti.
Per un sistema che esegue più telecamere ed esegue più routine di funzionalità come un rilevatore di oggetti, un target tracker e il miglioramento del contrasto locale, lo sviluppatore raggiungerà il limite superiore del throughput del processore e genererà molto calore. Per aiutare a gestire questo problema, gli sviluppatori di software possono integrare parametri di configurazione che possono essere impostati o regolati dinamicamente. Ad esempio, per molte applicazioni non è necessario eseguire l'inferenza a frame rate. Riducendo l'uscita di inferenza a 10 fps o meno, è possibile gestire il profilo di potenza dell'intero stack software per adattarlo al budget di potenza.
6. Il potere dello sviluppo rapido
di processori mobili
L'esecuzione di modelli CNN e algoritmi CI è estremamente impegnativa dal punto di vista computazionale. Fino a poco tempo fa, i processori integrati non avevano la potenza per soddisfare i carichi di lavoro IA e CI. L'IA richiede un parallelismo massiccio delle funzioni moltiplicate. Le GPU tradizionali sono state in grado di eseguire il parallelismo in modo simile per la grafica, quindi sono state riutilizzate per applicazioni IA, in particolare per l'addestramento dei modelli. Di conseguenza, NVIDIA si è affermata come protagonista dell'addestramento dei modelli.
I processori mobili e integrati di oggi sono incredibili progetti. Ad esempio, Dragonwing QCS8550 SoC di Qualcomm è un design da 4 nm che include CPU, GPU, DSP, NPU, computer vision e risorse ISP dedicate per applicazioni IoT ed IA Edge impegnative. Le risorse ISP e di visione artificiale integrate supportano funzioni quali denoising video, stabilizzazione, correzione dell'immagine, bilanciamento del bianco, elaborazione del colore, controllo automatico del guadagno, messa a fuoco e altre funzioni della telecamera. Questa classe di chip richiede un enorme investimento nello sviluppo e dipende dalle capacità avanzate della fonderia, dagli strumenti software e dal supporto a lungo termine dell’ecosistema.

Figura 5 - Core del processore QCS 8550
Teledyne FLIR OEM desiderava creare una piattaforma su cui i clienti potessero costruire i propri prodotti e consentire la creazione di stack software altamente integrati e ridurre al minimo costi, latenza e potenza utilizzando un singolo processore, ove possibile. Questo è stato l’obiettivo di diverse generazioni di piattaforme, tra cui la selezione del processore Intel® Myriad™ per il modulo termocamera (IR) Boson® OEM Teledyne FLIR. L'architettura del chip Myriad non è stata in grado di soddisfare le esigenze di calcolo più pesanti per l'imaging computazionale o i rilevatori di oggetti basati su CNN. Con l'introduzione di NVIDIA Xavier, moduli NVIDIA Jetson di classe Orin, Qualcomm RB5/QCS5165 e processori Qualcomm QCS8550-class, è diventato pratico eseguire più stack software distribuiti su core e acceleratori di processori specifici.
Panoramica del sistema su chip (SoC)
I processori integrati di oggi sfruttano i più recenti nodi di fonderia, consentendo di progettare multi-core con una memoria unificata. I fornitori di processori offrono un supporto di sviluppo molto completo e gli sviluppatori possono implementare il proprio codice su questi processori multicore per massimizzare le prestazioni, rispettando al contempo i budget di potenza e termici.
CPU
La funzionalità principale della CPU è recuperare le istruzioni dalla memoria ad accesso casuale (RAM) e decodificarle ed eseguirle. Le CPU sono processori generalisti progettati per eseguire routine che gestiscono carichi di lavoro sequenziali. Molte CPU sono dotate di processori vettoriali integrati per accelerare alcune operazioni (ad es. NEON su CPU basate su ARM). Molte delle funzionalità dei prodotti digitali degli OEM di Teledyne FLIR vengono eseguite su core CPU, tra cui il tracker video di correlazione Prism ISP e la stabilizzazione video elettronica. Dato il gran numero di core CPU disponibili sui SoC di generazione corrente, gli sviluppatori hanno una flessibilità enorme per ottimizzare prestazioni e potenza. Le CPU non sono adatte per attività che richiedono un gran numero di operazioni matematiche per pixel. Le CPU hanno limiti di throughput e consumano una potenza relativamente elevata per operazione.
GPU
I carichi di lavoro IA e CI sono enormi, e richiedono una quantità significativa di larghezza di banda e potenza di elaborazione. I progettisti di processori hanno creato potenti architetture chip che integrano memoria, sicurezza e connettività dati in tempo reale. Le CPU tradizionali in genere non hanno le prestazioni di elaborazione necessarie, ma sono ideali per eseguire attività sequenziali. Le GPU sono in grado di gestire il parallelismo delle funzioni di moltiplicazione e di applicarle alle applicazioni IA. Infatti, le GPU possono fungere da acceleratori IA, migliorando le prestazioni per reti neurali e carichi di lavoro simili. Le GPU possono avere migliaia di core di calcolo e vengono utilizzate per molte attività di elaborazione parallela. Le GPU sono particolarmente utili per l'addestramento dei modelli. Tuttavia, le GPU consumano una potenza significativa e hanno requisiti di memoria su chip più elevati. Per questo motivo, i moderni processori mobili impiegano co-processori IA dedicati che utilizzano processori di segnale digitale (DSP) per eseguire l'inferenza sul perimetro.
DSP
I DSP sono sottosistemi SoC specializzati ed efficienti dal punto di vista energetico, ottimizzati per eseguire operazioni matematiche. Utilizzano ampie parole di istruzione per massimizzare l’elaborazione per ciclo di clock. Tuttavia, non sono facili da programmare e richiedono familiarità con le caratteristiche dell'hardware DSP, l'ambiente di programmazione e l'ottimizzazione del software DSP per ottenere le migliori prestazioni. Qualcomm Hexagon™ Tensor Processor (HTP) è un acceleratore IA adatto per l'esecuzione di carichi di lavoro IA ad alta intensità di calcolo. Per ottenere prestazioni migliori ed eseguire un modello IA su HTP, un modello deve essere quantificato in base a una delle precisioni supportate: INT4, INT8, INT16 o FP16.
ISP
Poiché la fotografia digitale è la prima linea della battaglia competitiva nel settore dei telefoni cellulari, i fornitori di processori mobili incorporano blocchi di proprietà intellettuale (IP) dedicati al silicio per eseguire funzioni di miglioramento dell'immagine, tra cui riduzione del rumore, correzione della distorsione dell'obiettivo, bilanciamento del bianco, esposizione automatica, messa a fuoco automatica, de-mosaico e compressione dell'immagine. A livello di sistema, la messa a punto ISP è tipicamente necessaria per ottimizzare i parametri e i vari filtri per uno specifico sensore di immagine e obiettivo. La messa a punto di ISP è un settore di per sé. Molti fornitori di SoC offrono librerie ISP per i sensori di immagine più diffusi, consentendo agli sviluppatori di sistemi di risparmiare un investimento significativo.
I fornitori di processori mobili possono progettare e fabbricare una termocamera ISP con poche giustificazioni. Tuttavia, i vantaggi dell’elaborazione del segnale delle immagini sono preziosi, quindi Teledyne FLIR OEM ha sviluppato un set completo di funzionalità ISP, tra cui mappatura dei toni da 16 a 8 bit (controllo automatico del guadagno), de-rumore spaziotemporale, super risoluzione, mitigazione delle turbolenze e stabilizzazione elettronica delle immagini. La maggior parte di questi algoritmi viene eseguita su GPU date le significative esigenze di elaborazione.
Memoria
Data l'elevata velocità di trasmissione dei dati nei flussi video digitali e il fatto che i dati possono essere letti ripetutamente da più algoritmi, la capacità di memoria e la larghezza di banda della memoria sono fondamentali per un'elaborazione efficiente del segnale. Grazie a una combinazione di velocità di clock maggiori, larghezza di banda di memoria maggiore, accelerazione IA dedicata e ottimizzazione software migliorata, il più grande modello di IA esistente di Teledyne FLIR OEM (risoluzione di ingresso 768x768 pixel) viene eseguito in 6 ms su Qualcomm QCS8550 rispetto a 33 ms su QRB5165. Ciò rappresenta un aumento di oltre 5X della velocità di inferenza e offre un margine di sicurezza per ottenere l'inferenza alla frequenza fotogrammi per le telecamere con risoluzione SXGA (1280x1024) di nuova generazione.
7. Framework
I framework IA sono elementi fondamentali che modellano il modo in cui i sistemi intelligenti vengono creati, ottimizzati e implementati. Questi framework, dotati di librerie e funzioni pre-costruite, consentono agli sviluppatori di creare sofisticati algoritmi IA senza dover progettare da zero ogni funzione. Nei sistemi IA di produzione edge, la discussione sul framework si estende ora oltre la formazione dei modelli, per includere formati di esportazione, ottimizzazione del runtime, strumenti di quantizzazione, compilatori specifici per hardware, test di regressione, strategie di aggiornamento in volo e monitoraggio delle prestazioni a livello di flotta.
PyTorch rimane ampiamente utilizzato per la ricerca, la sperimentazione e lo sviluppo di modelli grazie alla sua flessibilità e al suo modello di esecuzione intuitivo. Il suo grafico di calcolo dinamico consente agli sviluppatori di cambiare il comportamento dei modelli al volo e di utilizzare le operazioni di flusso di controllo Python, rendendolo adatto per architetture di modelli complessi, prototipazione rapida e sperimentazione iterativa.
TensorFlow rimane importante negli ambienti di produzione e nei flussi di lavoro di implementazione mobile, in particolare quando TensorFlow Lite o LiteRT è già integrato. Tuttavia, la moderna implementazione integrata è raramente una semplice scelta PyTorch-rispetto a TensorFlow. Un percorso di produzione comune è quello di addestrarsi in PyTorch o TensorFlow, esportare in ONNX o in un'altra rappresentazione portatile, ottimizzare il grafico, quantificare il modello, compilare in un runtime come TensorRT, ONNX Runtime, OpenVINO, LiteRT/TensorFlow Lite o Qualcomm AI Engine Direct, e quindi convalidare latenza, accuratezza, potenza e comportamento termico sul dispositivo di destinazione. Il framework migliore è quindi quello che supporta l'intera pipeline di distribuzione per il processore e l'applicazione selezionati, non solo quello più comodo durante la formazione.
8. Pipeline di elaborazione video
La pipeline di elaborazione video è il punto in cui l’approccio degli OEM di Teledyne FLIR si differenzia maggiormente. Anziché trattare la termocamera, ISP, il rilevatore, il tracker e il processore integrato come componenti indipendenti, la pipeline è progettata come un sistema connesso. Ogni fase influisce sulla successiva: il denoising cambia la texture del bersaglio, il miglioramento del contrasto cambia la distribuzione dell’input del modello, la stabilizzazione migliora la coerenza temporale, la super risoluzione può migliorare i dettagli efficaci e il tracciamento converte i rilevamenti fotogramma per fotogramma in informazioni persistenti. L’ottimizzazione di queste interazioni è essenziale per una percezione affidabile dei bordi.
Teledyne FLIR OEM ha sviluppato Prism ISP, una raccolta di librerie software per l'elaborazione delle immagini termiche che includono il miglioramento del contrasto locale (LCE), la riduzione del rumore spaziale e temporale, la stabilizzazione elettronica delle immagini, la mitigazione delle turbolenze, la super risoluzione e diverse tecniche di fusione video. Queste funzioni migliorano la qualità dell'immagine per l'interpretazione umana, modellando al contempo le informazioni presentate agli algoritmi di rilevamento e tracciamento a valle. L'obiettivo è sia migliorare l'aspetto del video, sia migliorare l'affidabilità, l'efficienza e la distribuibilità dell'intera pipeline di percezione termica, riducendo al minimo i requisiti di alimentazione e i costi. I moduli termocamera di Teledyne FLIR OEM non includono processori integrati per eseguire Prism ISP. Grazie alla disponibilità di moderni processori mobili e integrati, è ora pratico aggiungere un modulo elettronico accessorio con la potenza necessaria per eseguire algoritmi ISP, di rilevamento e di tracciamento a frame rate video utili, rispettando al contempo i vincoli di potenza e termici del mondo reale.

Figura 6 - Pipeline di elaborazione video Prism
La termografia viene utilizzata in molti casi d'uso per visualizzare gli oggetti: a metri di distanza per l'ispezione e la lotta contro gli incendi; a più chilometri in intelligence, sorveglianza e ricognizione (ISR); e dal punto di vista aereo, delle torri e del terreno. La combinazione di portata, prospettiva e condizioni ambientali di giorno, notte e meteo crea sfide di imaging reali che possono essere mitigate con le funzioni dell’algoritmo Prism ISP.
9. Funzioni Prism ISP
Mitigazione delle turbolenze

Figura 7 - confronto senza (sinistra) e con (destra) mitigazione della turbolenza
La turbolenza atmosferica si riferisce al movimento irregolare e caotico del fluido o dell’aria caratterizzato da fluttuazioni di velocità, pressione e densità. La turbolenza influisce sulla trasmissione dei fotoni perché il guadagno solare della superficie causa la miscelazione dell'atmosfera. Abbassa l'aria e causa il vapore acqueo, il fumo e altre sostanze che alterano la rifrazione del segnale infrarosso. Le tecniche avanzate eliminano gli effetti di distorsione mantenendo una buona qualità dell’elemento dell’immagine temporale, il che significa che gli oggetti in movimento non vengono trasformati in chiazze o striature indistinguibili. Questo è fondamentale quando si rilevano bersagli, comprese persone e veicoli, utilizzando l'IA.
Per il rilevamento e il tracciamento dell'IA, la mitigazione delle turbolenze è molto più di una funzione di qualità dell'immagine. Distorsione, brillantezza e movimento apparente possono ridurre la fiducia del rilevatore e rendere i binari meno stabili. Migliorando la coerenza temporale prima dell’inferenza e del tracciamento, la pipeline può fornire informazioni target più affidabili senza dipendere solo da modelli più grandi o da budget di calcolo più elevati.
Gli obiettivi primari degli algoritmi di mitigazione delle turbolenze sono migliorare la qualità del segnale, ridurre il rumore e ripristinare chiarezza e stabilità in condizioni turbolente. L'algoritmo Prism ISP utilizza varie tecniche matematiche e di elaborazione del segnale per analizzare ed elaborare i dati interessati dalle turbolenze.
- Acquisizione dati: Il primo passo è acquisire i dati interessati dalle turbolenze. Questo viene presentato sotto forma di frame immagine.
- Pre-elaborazione: I dati acquisiti vengono pre-elaborati per rimuovere il rumore o gli artefatti che non sono direttamente correlati alla turbolenza. Ciò comporta tecniche di filtraggio, riduzione del rumore e calibrazione per migliorare la qualità del segnale.
- Stima delle turbolenze: È essenziale stimare le caratteristiche di turbolenza presenti nei dati. Ciò comporta l’analisi delle proprietà statistiche delle fluttuazioni e l’identificazione di parametri rilevanti come l’intensità della turbolenza, la lunghezza della correlazione e le scale temporali.
- Deconvoluzione o ricostruzione: Le tecniche di deconvoluzione tentano di invertire gli effetti di sfocatura causati dalle turbolenze. Gli algoritmi di deconvoluzione spesso utilizzano modelli matematici di turbolenza o conoscenza empirica per ripristinare il segnale originale.
- Filtraggio adattivo: Le condizioni di turbolenza possono variare nel tempo e nello spazio, quindi molti algoritmi di mitigazione delle turbolenze utilizzano tecniche di filtraggio adattivo. Questi metodi regolano dinamicamente i parametri di filtraggio in base ai parametri di turbolenza stimati per ottimizzare il compromesso tra la riduzione del rumore e la conservazione delle caratteristiche essenziali del segnale.
- Post-elaborazione: Dopo le fasi di mitigazione delle turbolenze, è possibile eseguire ulteriori operazioni di post-elaborazione per migliorare ulteriormente la qualità e ridurre gli artefatti nell’output finale. A seconda dell’applicazione specifica, ciò può comportare tecniche come denoising, affilatura, miglioramento del contrasto o estrazione di caratteristiche.
Super risoluzione

Figura 8 – confronto senza (sinistra) e con (destra) Super Resolution
La super-risoluzione multi-frame è una tecnica potente che mira a ricostruire un'immagine ad alta risoluzione da una o più immagini a bassa risoluzione. La risoluzione ottica di un sistema è limitata dal limite di diffrazione impostato dall'apertura del sistema e dalla risoluzione di campionamento del rilevatore. Una piccola apertura e un sensore a bassa risoluzione si tradurranno in un sistema più economico e più piccolo che si tradurrà in immagini di scarsa qualità con bordi altamente aliasizzati e/o sfocati. Ciò è particolarmente vero quando i bersagli a lungo raggio vengono catturati utilizzando un’ottica a lunghezza focale lunga che scala gli effetti della diffrazione se combinata con una dimensione dell’apertura limitata. Utilizzando algoritmi sofisticati, la super risoluzione ricostruisce le immagini ad alta risoluzione utilizzando i dati provenienti dagli ingressi degradati. Sebbene i metodi tradizionali si siano concentrati prevalentemente sullo sfruttamento delle correlazioni spaziali intrinseche all’interno di immagini a bassa risoluzione, i recenti progressi hanno dimostrato l’efficacia di sfruttare le tecniche di aliasing per ottenere risultati superiori.
In una pipeline di percezione, la super-risoluzione può anche influenzare la portata di rilevamento, la classificazione di piccoli bersagli e la fiducia degli operatori. Il beneficio deve essere valutato a livello di sistema perché gli artefatti di affilatura o ricostruzione possono aiutare l’interpretazione visiva, ma possono anche cambiare la distribuzione degli input osservata da un modello IA. Ciò rafforza la necessità di mettere a punto ISP e rilevamento insieme, piuttosto che come funzioni isolate.
Stabilizzazione immagine

Figura 9 - Applicazioni tipiche per la stabilizzazione elettronica
Le termocamere sono spesso montate su piattaforme mobili come veicoli terrestri, imbarcazioni, aeromobili, droni o torri. Il movimento della piattaforma si trasferisce direttamente sull'immagine video, il che può portare a un affaticamento dello spettatore e a una scarsa qualità dell'immagine, influenzando la consapevolezza situazionale e la fedeltà delle prove. La stabilizzazione elettronica elimina la maggior parte della distorsione dell'immagine indotta dal movimento, in particolare quando l'immagine viene acquisita attraverso un campo visivo ristretto, utilizzato per l'imaging a lungo raggio.
Per la percezione automatizzata, la stabilizzazione migliora la coerenza temporale e può ridurre l’avvio di false tracce, i mancati rilevamenti e l’affaticamento dell’operatore. Aiuta inoltre gli algoritmi a valle a utilizzare i segnali di movimento in modo più efficace, perché il movimento dell'immagine causato dalla piattaforma viene ridotto prima che vengano eseguiti il rilevamento e il tracciamento.
MSX - Imaging dinamico multispettrale

Figura 10 - MSX goffra i bordi visibili sulle immagini termiche in tempo reale
Esistono molti approcci diversi alla fusione delle immagini o alla fusione di immagini termiche e visibili in un unico flusso video fuso. L’obiettivo è far emergere le informazioni uniche e preziose di ogni spettro, senza richiedere la trasmissione di due o più flussi per l’analisi da parte di operatori o sistemi umani a valle. Ciò può essere complesso nella pratica a causa della necessità di una registrazione perfetta delle immagini (allineamento) di due o più canali e dei problemi dovuti ai diversi tempi di integrazione per ciascun sensore.
Teledyne FLIR OEM ha brevettato una tecnologia unica chiamata MSX (Multi-Spectral Dynamic Imaging). A differenza della combinazione di immagini (miscelazione di luce visibile e immagine termica), MSX non rimuove i dettagli termici né riduce la trasparenza termica. Al contrario, applica un filtro ad alta frequenza per estrarre dettagli visibili nitidi come la simbologia, tra cui contorni, parole, numeri e altri dettagli dei bordi ad alto contrasto, e li sovrappone sull'immagine termica. Questo aiuta a fornire la definizione dell'immagine e si è dimostrato una tecnologia vantaggiosa in campi come la manutenzione predittiva, la sicurezza e le applicazioni ISR aeree.
AGC – Controllo automatico del guadagno

Figura 11 - Miglioramento del contrasto locale (video sorgente Boson® 640)
Nel contesto delle immagini, il contrasto si riferisce alla differenza di intensità tra le regioni più luminose e più scure. Svolge un ruolo fondamentale nella definizione dell'impatto visivo complessivo di un'immagine. Il miglioramento del contrasto locale, noto anche come allungamento del contrasto locale, opera sul principio di espandere la gamma dinamica di contrasto all'interno di regioni specifiche di un'immagine piuttosto che alterare globalmente il contrasto dell'intera immagine.
Il miglioramento del contrasto locale evidenzia dettagli intricati, migliora la texture e accentua le caratteristiche. La conversione dei dati grezzi del sensore monocromatico a 16 bit nella profondità di colore a 8 bit che vediamo sui display si basa su algoritmi per mappare l’ampia distribuzione dei valori dei pixel in 1 delle 256 sfumature di colore o grigio. Poiché la distribuzione dei valori di pixel in un'immagine è raramente lineare, massimizzare il contrasto è altamente complesso e dinamico da uno scenario all'altro. A differenza del miglioramento del contrasto globale, che regola il contrasto sull'intera immagine in modo uniforme, il miglioramento del contrasto locale si concentra sulla conservazione dei dettagli locali e delle texture fini. Mira a regioni più piccole all’interno dell’immagine e amplifica il contrasto all’interno di tali regioni, mantenendo al contempo le relazioni di contrasto relative tra regioni vicine.
Per le condutture IA, la mappatura dei toni e il miglioramento del contrasto locale devono essere gestiti attentamente perché modellano l'ingresso numerico al rilevatore. Un’impostazione che appare visivamente piacevole potrebbe non sempre massimizzare la fiducia del modello, ridurre i falsi allarmi o preservare i dettagli dei piccoli bersagli. L’approccio a livello di pipeline di Teledyne FLIR OEM consente di valutare queste scelte di elaborazione delle immagini rispetto agli obiettivi finali del sistema di rilevamento, tracciamento e supporto decisionale affidabili all’interno della busta SWaP disponibile.
10. Conclusione
Ci sono stati notevoli progressi nel deep learning, nei processori integrati e negli strumenti di implementazione IA di produzione. Per i sistemi termici e multispettrali, questi progressi sono importanti, ma non sono sufficienti da soli. Il mercato si sta spingendo oltre la questione se l'IA può essere eseguita sull'edge. La domanda più importante è se la pipeline di percezione completa può essere progettata per fornire informazioni affidabili e fruibili sul campo, soddisfacendo al contempo i requisiti SWaP, latenza, larghezza di banda e vincoli termici.
Il vantaggio di Teledyne FLIR OEM va oltre la semplice esecuzione dell'IA su processori integrati. È la capacità di ottimizzare l’intera pipeline di percezione termica dei dati del sensore, l’elaborazione del segnale di immagine, la progettazione del modello, la quantizzazione, l’implementazione in runtime, il tracciamento, l’uso della memoria, la gestione dell’alimentazione e la robustezza ambientale come sistema integrato. Nelle applicazioni pratiche nei sistemi di difesa, autonomia, robotica, automazione industriale, sicurezza e automobilistico, la differenziazione proverrà da questa integrazione completa piuttosto che dalla sola selezione di modelli generici o TOPS.
La nuova generazione di termocamere intelligenti sarà quindi definita dalla capacità di rilevamento della fisica, dell'imaging computazionale, dell'intelligenza artificiale integrata e dell'ingegneria di implementazione. Combinando l’esperienza dei sensori termici, Prism ISP, le librerie di rilevamento e tracciamento specifiche per l’applicazione e l’esperienza nell’ottimizzazione del software su moderni processori eterogenei, Teledyne FLIR OEM aiuta i clienti a passare dalle dimostrazioni IA Edge ai sistemi di percezione implementati che funzionano in ambienti operativi reali.
[i] https://patentimages.storage.googleapis.com/f5/e3/05/021253fa9a6921/US20220019843A1.pdf
[ii] https://patents.google.com/patent/US20220019843A1/en?oq=17%2f374909
[iii] Una revisione dell'intelligenza artificiale nei sistemi integrati https://doi.org/10.3390/mi14050897
Articoli correlati
-
 Novità
New Qualcomm-Built Advanced Video Processor by Teledyne FLIR Powers AI at the Edge
Leggi la storia -
 Articolo
Simplify MWIR Development with Neutrino Featuring InVeo Electronics
Per saperne di più -
 Articolo
Comparing Sensitivity of Thermal Imaging Camera Modules
Per saperne di più