
Utilisation des données synthétiques pour accélérer le développement de modèles de perception de l’IA pour la détection d’objets
TÉLÉCHARGER LA VERSION PDF
Introduction
Le concept d’exploitation (CONOPS) pour les plateformes aériennes et les systèmes autonomes évolue rapidement. Le brouillage des radiofréquences (RF) peut désormais perturber les communications et la navigation dans le système mondial de navigation par satellite (GNSS), augmentant ainsi le besoin de détection et de suivi de cibles multiclasses, d’autonomie intégrée, de reconnaissance automatique de cibles basée sur la périphérie et de guidage de terminaux qui peuvent fonctionner dans des environnements contestés. Pour les OEM et les intégrateurs de systèmes, ce changement stimule la demande de produits de perception numérique qui détectent, classent et suivent les objets pertinents pour la mission à la périphérie à l’aide de caméras électro-optiques (OE) et infrarouges (IR).
Les détecteurs d’objets généralisés peuvent être suffisants pour de nombreuses applications de sensibilisation à la situation, mais de nombreuses applications de défense nécessitent une classification fine des cibles, des comportements et des points de visée. Les solutions de perception IA adoptent une ontologie similaire à la perception humaine après trois niveaux de perception : détection, reconnaissance et identification. Chaque niveau a un pixel sur le seuil cible, et il est souvent très difficile de collecter des données de champ couvrant tous les pixels sur les exigences cibles pour entraîner un modèle haute performance. Le facteur limitant est les données, car les données d’image sont souvent cloisonnées entre les organisations militaires, les agences gouvernementales, les institutions de recherche et les entrepreneurs de la défense, chacun ayant des politiques d’accès et de commercialisation différentes. Dans le même temps, les classes cibles continuent de se développer et les conditions réelles telles que le camouflage, l’usurpation d’identité, la modalité du capteur, la géométrie de visualisation et l’environnement doivent être représentées dans les données d’entraînement. Répondre à ces exigences exige la génération de données et la formation aux modèles en quelques jours plutôt qu’en plusieurs semaines ou mois. L’OEM de Teledyne FLIR a développé AIMMGenð pour relever ce défi en tant que capacité de génération de données synthétiques et d’entraînement de modèle d’IA qui prend en charge le portefeuille plus large de produits numériques PrismÆ.
Principaux points à retenir
- AIMMGen accélère le développement de modèles d’objets en générant de grands volumes de données synthétiques étiquetées OE, IR et multispectrales pour des scénarios riches en cibles.
- La chaîne d’outils réduit la dépendance à l’égard des ensembles de données rares, coûteuses ou restreintes du monde réel tout en préservant la capacité à augmenter les données mesurées lorsqu’elles sont disponibles.
- La gestion automatisée des métadonnées, la conservation des ensembles de données et l’optimisation des modèles prennent en charge le développement reproductible et traçable de modèles de perception spécifiques à la mission.
- Dans le cadre de l’écosystème de produits numériques Prism, AIMMGen aide à convertir les données synthétiques et les flux de travail de formation en capacités de perception numérique déployables pour les plateformes OEM.
- Des exemples de résultats montrent une amélioration mesurable des performances dans la détection air-sol et démontrent l’entraînement de modèle uniquement synthétique pour la classification maritime MWIR à grain fin.
Pourquoi les données synthétiques comptent-elles maintenant ?
La valeur stratégique des données synthétiques pour l’apprentissage des modèles ne se limite plus à combler les lacunes en matière de données d’apprentissage. Il devient un moyen pratique d’accélérer les capacités de détection définies par logiciel et de perception IA adaptables sur le terrain. À mesure que les exigences de la mission évoluent, les clients ont besoin de modèles qui peuvent être étendus à de nouvelles classes cibles, validés à travers les modalités de capteurs et déployés sur des processeurs intégrés sans redémarrer les campagnes de collecte de données et d’étiquetage d’une durée de plusieurs mois.
Pour l’OEM de Teledyne FLIR, AIMMGen est la base de la génération de modèles derrière cette stratégie de produits numériques. Il aide à transformer les images éparses, coûteuses ou difficiles à collecter en modèles d’IA validés qui prennent en charge les applications Prism pour la détection, le suivi, la reconnaissance de cible et la perception spécifique à la mission.
Génération de modèles de données synthétiques et d’IA
Les développeurs sur les marchés tels que la conduite autonome ont souvent accès à de grandes bibliothèques de formation. En revanche, les organisations développant des systèmes de détection militaires et spécifiques à la mission ont souvent un accès limité aux données cibles représentatives. Les données réelles restent importantes pour les classificateurs de précision, mais les données synthétiques offrent un moyen pratique d’augmenter les ensembles de données mesurés ou de développer des classificateurs à grain fin lorsque les données mesurées sont indisponibles, restreintes ou prohibitivement coûteuses à collecter.
L’AIMMGen (Modélisation et génération de modèles d’IA) OEM de Teledyne FLIR combine la génération automatisée de données à grande échelle, la récupération intelligente de données et l’optimisation du modèle d’IA dans un pipeline unique pour les développeurs d’algorithmes de reconnaissance automatique de cible (ATR) et les intégrateurs OEM. Au sein de l’écosystème de produits numériques Prism, AIMMGen fonctionne comme une usine de modèles : elle aide à créer, former, tester et fournir des modèles de perception IA pour les applications logicielles prêtes à la mission et les modules de perception intégrés. La chaîne d’outils génère rapidement des données synthétiques pour des scénarios réels, y compris les types d’objets cibles, les positions, les orientations, les modalités de capteur, les configurations, les trajectoires et les états environnementaux. Il peut produire des millions d’images étiquetées en quelques jours, plutôt que les semaines ou les mois généralement requis pour la collecte des données sur le terrain et l’étiquetage manuel.
AIMMGen génère automatiquement des étiquettes pour chaque image et stocke les métadonnées de la collection avec l’ensemble d’images. Pour prendre en charge la formation, la validation et le déploiement reproductible dans les cas d’utilisation, les métadonnées pour chaque image et cible sont stockées dans un lac de données pour une conservation rapide et la construction de l’ensemble de données. Ces métadonnées comprennent les paramètres de collecte, les informations sur la cible et les paramètres d’image. Le cadre de formation extensible et indépendant du modèle d’AIMMGen permet ensuite une formation et une optimisation à l’échelle du cloud dans une gamme de cas d’utilisation et de tâches. Ce flux de travail traçable aide les clients à comprendre non seulement comment un modèle fonctionne, mais également quelles données, conditions et hypothèses ont façonné son développement.
Des données synthétiques à la perception numérique déployable
Le flux de travail AIMMGen est le plus précieux lorsqu’il est considéré comme faisant partie d’un pipeline de perception numérique de bout en bout. La génération de données synthétiques crée des images étiquetées à grande échelle. La conservation des jeux de données et la gestion des métadonnées rendent les données consultables et réutilisables. La formation et l’optimisation automatisées convertissent les données organisées en modèles. Les tests de validation et de performance fournissent la preuve que le modèle peut prendre en charge une application sur le terrain. Dans l’écosystème Prism, ces sorties peuvent prendre en charge les produits logiciels et les modules qui effectuent la détection, le suivi, la classification, l’imagerie informatique et la reconnaissance de cible à la périphérie.
Pour les clients OEM, le défi est rarement de modéliser la formation seule. L’objectif plus large est de réduire les risques de développement, de raccourcir le délai de capacité et d’adapter le logiciel de perception à mesure que les cibles, les capteurs, les plateformes de déploiement et les exigences de mission changent.
Étape 1 : Processus de génération de données synthétiques AIMMGen
La première étape du processus AIMMGen est la génération de données, qui commence par les spécifications pour les types d’emplacement, la résolution du capteur, les types d’objets cibles, les conditions d’imagerie, les configurations du capteur et le nombre d’images souhaité. Les combinaisons randomisées de ces spécifications sont créées jusqu’à ce que le nombre total d’images atteigne ou dépasse le nombre souhaité. Le pipeline de génération de données engage un moteur de simulation géospécifique qui comprend un terrain précis pour le monde entier, définit les conditions environnementales, insère des cibles échantillonnées à partir de plus de 20 000 modèles uniques et commence à collecter des données. La vérité de base est générée automatiquement sous forme de métadonnées et stockée avec les métadonnées cibles.
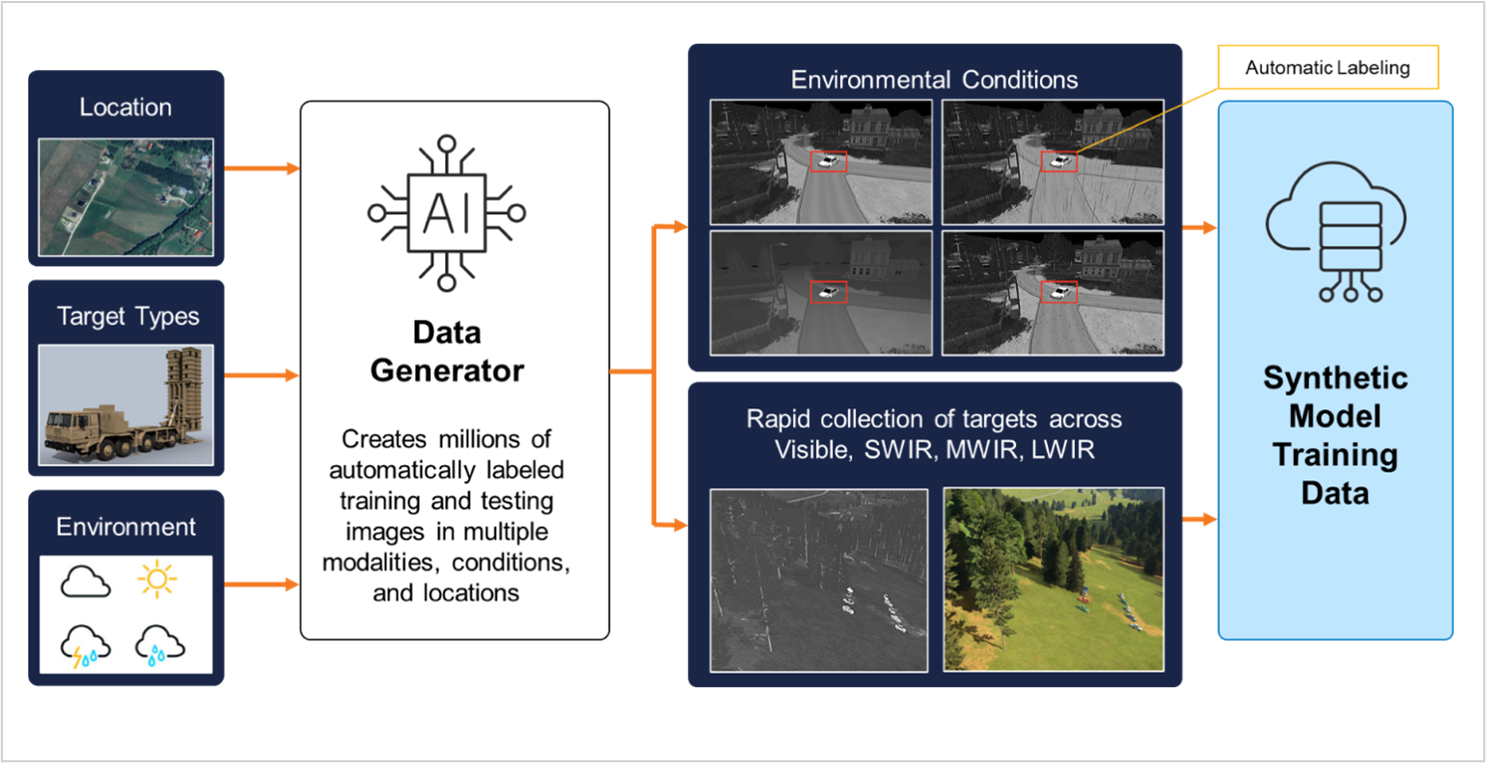
Figure 1. Les données d’entraînement synthétiques sont générées en quelques minutes et à faible coût
Les métadonnées d’image, y compris l’URI final de chaque emplacement d’image et les métadonnées cibles associées, sont capturées et stockées dans une base de données Elasticsearch. Ces métadonnées sont stockées dans des index distincts et liées par des identifiants uniques, permettant aux utilisateurs de visualiser, filtrer et rechercher dans les sous-ensembles de données. Après la génération, les données peuvent être organisées à l’aide d’outils de visualisation pour prendre en charge la conception d’expériences et le développement de jeux de données.
Étape 2 : Formation et optimisation du modèle AIMMGen
La deuxième étape est l’apprentissage et l’optimisation automatisés des modèles. Les utilisateurs spécifient les jeux de données, les caractéristiques de performance du modèle souhaitées et les mesures d’optimisation. AIMMGen orchestre un cluster de nœuds d’entraînement IA pour entraîner, évaluer et produire des modèles optimisés par rapport aux mesures de référence et définies par l’utilisateur. Étant donné que le cadre de formation est indépendant du modèle, les utilisateurs peuvent créer des pipelines de données personnalisés et des architectures de modèle au sein d’AIMMGen. Les modèles de sortie sont suivis et stockés dans une base de données pour soutenir la traçabilité, la reproductibilité et le perfectionnement futur à mesure que les missions des clients ou les ensembles de cibles évoluent.
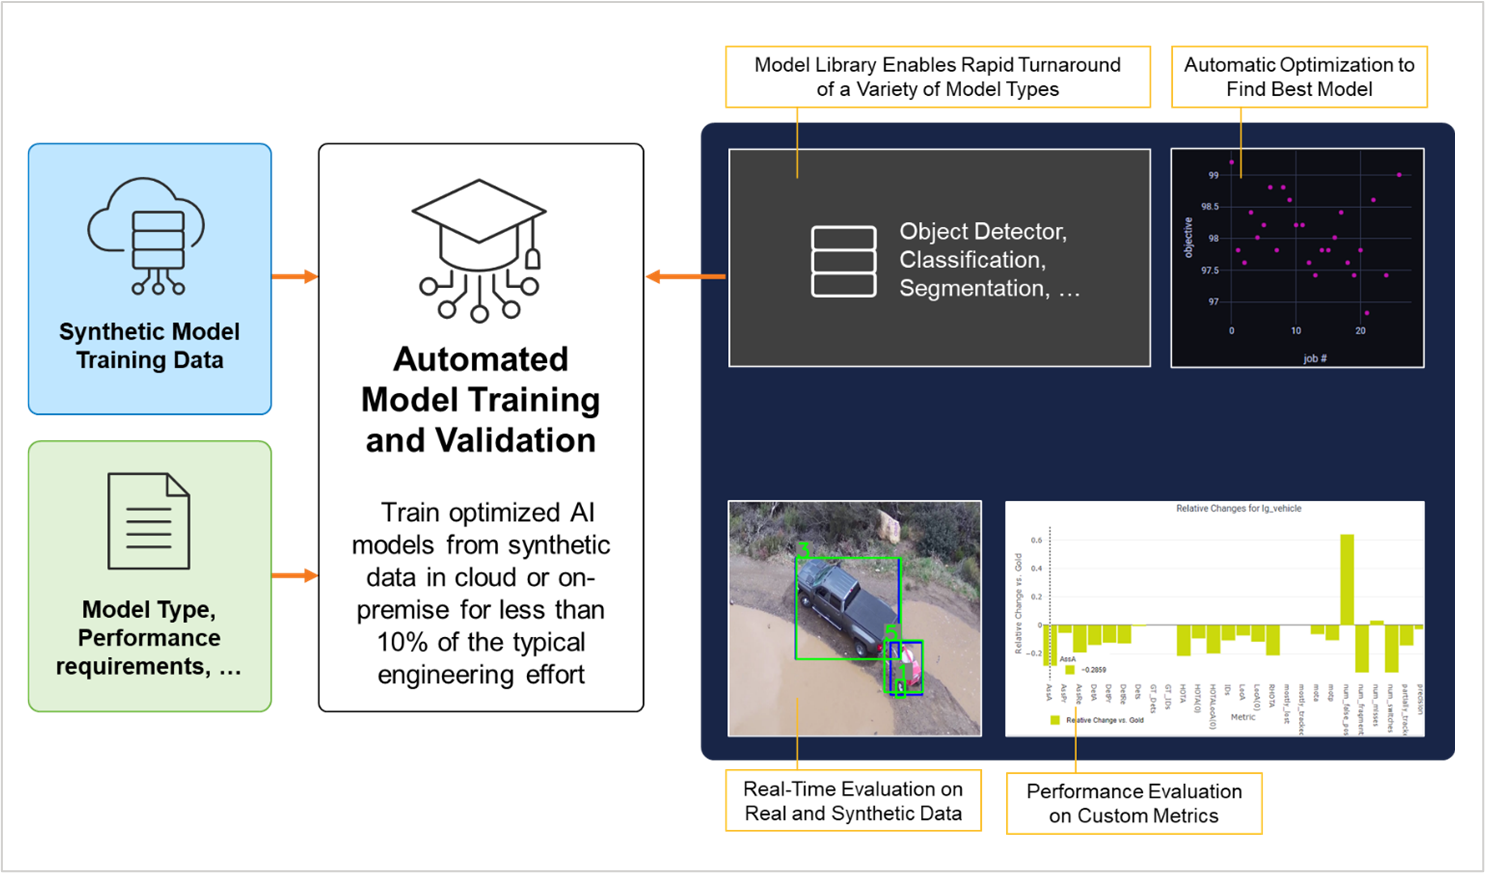
Figure 2. Formation et optimisation automatiques
Indicateurs de performance de référence pour l’optimisation du modèle de perception de l’IA
Dans le développement du modèle de perception de l’IA, la précision, le rappel et F1-score sont des mesures clés pour évaluer la manière dont un modèle identifie et classe les objets ou les instances.
La précision mesure la précision des prédictions positives faites par le modèle. Il est important lorsque le coût des faux positifs est élevé. Dans les applications militaires, le fait de mal identifier une non-menace comme une menace pourrait entraîner des actions inutiles.
Précision = vrais positifs/(vrais positifs + faux positifs)
Le rappel, également connu sous le nom de sensibilité ou taux de vrais positifs, mesure la capacité du modèle à identifier toutes les instances pertinentes. Cela est essentiel lorsqu’une instance positive est manquante a de graves conséquences, comme le danger de ne pas détecter une menace réelle.
Rappel = vrais positifs/(vrais positifs + faux négatifs)
F1-Score fournit une vue équilibrée de la performance du modèle, garantissant à la fois la précision et le rappel. Il s’agit d’une bonne mesure de la performance globale du modèle lorsqu’il s’agit de jeux de données déséquilibrés et elle est essentielle pour développer des systèmes de perception robustes.
F1 - Score = 2 x (Précision * Rappel)/(Précision + Rappel)
Exemples d’applications et de résultats AIMMGen
AIMMGen a été validé dans plusieurs domaines d’applications et de capteurs, y compris la détection air-sol et la classification maritime à grain fin.
Dans une expérience de détection air-sol, l’OEM de Teledyne FLIR a ajouté des données synthétiques électro-optiques (OE) et infrarouges à ondes longues (LWIR) à un ensemble de données d’entraînement à la détection d’objets qui comprenait déjà des données d’OE et IR mesurées. Avec seulement des changements limités au programme d’entraînement, les modèles formés par AIMMGen ont obtenu une amélioration mesurable du rappel. Cela est important sur le plan opérationnel, car les détections manquées peuvent être plus consécutives que les faux positifs supplémentaires dans de nombreux flux de travail de surveillance, de ciblage et de protection de la force. L’amélioration se reflète dans l’augmentation globale du F1-score.
Tableau 1. Modèles AIMMGen comparés aux modèles entraînés en temps réel uniquement
|
|
Modèles AIMMGen |
Modèle réel uniquement existant |
| Précision |
0,71 ± 0,01 |
0,71 |
|
Rappel |
0,52 ± 0,01 |
0,48 |
|
F1-Score |
0,60 ± 0,01 |
0,57 |
AIMMGen peut également prendre en charge la génération de modèles d’IA avec peu ou pas de données d’entraînement réelles, comme démontré dans un exemple maritime infrarouge à ondes moyennes (MWIR). L’identification fine des objets maritimes nécessite généralement des ensembles de données MWIR coûteux avec des étiquettes détaillées de type de navire. Avec des données réelles limitées, les modèles ne peuvent faire la distinction entre les grandes catégories telles que « petit vaisseau » et « grand vaisseau ». Cependant, à l’aide d’AIMMGen, un modèle a été formé exclusivement sur les données synthétiques et était capable de classer des sous-types de vaisseaux spécifiques. Les performances ont été validées dans plusieurs collections réelles, y compris l’eau douce et les environnements littorals, démontrant la robustesse de la formation synthétique uniquement et le potentiel d’élargir les classes cibles lorsque les images réelles sont rares ou difficiles à collecter.
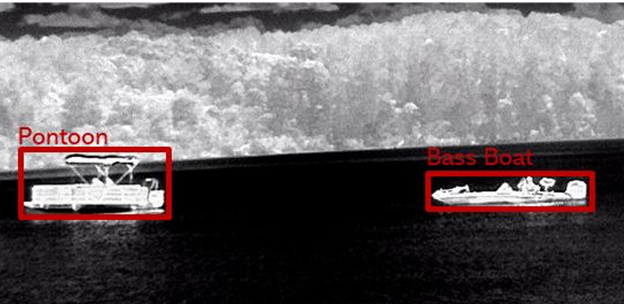
Figure 3: Identification fine dans le MWIR des navires maritimes à l’aide de modèles d’IA synthétiques formés aux données
Résumé
La création de vastes ensembles de données d’entraînement diversifiés pour les applications EO, IR et multispectrales reste un obstacle majeur au déploiement de systèmes de perception IA robustes. AIMMGen résout cet obstacle avec l’imagerie synthétique, la gestion automatisée des métadonnées, la conservation des jeux de données et l’optimisation des modèles. Dans le cadre de la stratégie plus large de produits numériques Prism de Teledyne FLIR OEM, AIMMGen est plus qu’une chaîne d’outils de génération de données. Il fournit une base de génération de modèle pour développer, valider et étendre les capacités de perception de l’IA spécifiques à la mission dans la défense, l’autonomie, les premiers intervenants et d’autres applications OEM.
Pour plus d’informations sur la famille de logiciels Prism et les produits numériques OEM Teledyne FLIR, veuillez consulter oem.flir.com/prism.
Articles connexes
-
 Article
Les progrès réalisés dans les systèmes d’imagerie MWIR prêts à l’emploi peuvent réduire le temps de développement de deux ans
En savoir plus -
 Article
Comparing Sensitivity of Thermal Imaging Camera Modules
En savoir plus -
 Livre blanc
Beyond Embedded AI: Optimizing the Thermal Perception Pipeline from Sensor Data to Edge Deployment
En savoir plus