合成データを利用して、物体検出のためのAI認識モデルの開発を迅速化
PDF版をダウンロード
はじめに
航空プラットフォームおよび自律型システムの運用概念(CONOPS)は、急速に進化しています。無線周波数 (RF) 妨害により、通信や全球測位衛星システム (GNSS) のナビゲーションが中断される可能性があり、マルチクラスのターゲット検出と追跡、オンボード自律性、エッジベースの自動ターゲット認識、および敵対的な環境でも動作可能な終末誘導の必要性が高まっています。OEMやシステムインテグレーターの立場では、この変化により、電気光学(EO)および赤外線(IR)カメラを使用してエッジでミッションに関連する物体を検出・分類・追跡するデジタル認識製品への需要が喚起されています。
多くの状況認識アプリケーションでは、汎用的な物体検出器で十分な場合もありますが、防衛関連のアプリケーションの多くは、ターゲット、挙動、照準点に関する詳細な分類が必要です。AIの認識ソリューションは、人間による認識と同様のオントロジーを採用し、検出・認識・識別という3つの認識レベルに従っています。レベルごとにターゲット上のピクセル数に関する閾値が設定されていますが、高性能なモデルを学習させるために、ターゲット上のピクセル数に関するすべての要件を網羅したフィールドデータを収集することは、往々にして非常に困難です。制約要因となるのは、データです。軍事組織、政府機関、研究機関、防衛関連企業といった組織の間で、画像データはサイロ状に分断されており、アクセスや商業化に関するポリシーもそれぞれ異なっているためです。それと同時に、ターゲットクラスは拡大を続けており、カモフラージュ、スプーフィング、センサーモダリティ、ビューイングジオメトリ、環境などといった実世界のさまざまな条件が、学習データで表現されている必要があります。こうした要件を満たすには、データの生成とモデルの学習を、数週間や数ヵ月ではなく数日で行う必要があります。Teledyne FLIR OEMは、この課題に対処するため、広範なPrism™デジタル製品ポートフォリオをサポートする合成データ生成およびAIモデル学習機能として、AIMMGen™を開発しました。
重要なポイント
- AIMMGenは、ターゲットが多数存在するシナリオ向けに、ラベル付きの合成EO、IR、およびマルチスペクトルデータを大量に生成することで、オブジェクトモデルの開発を迅速化します。
- このツールチェーンは、入手が困難、高価、または利用が制限されている実世界のデータセットへの依存度を減らすと同時に、実測データが利用可能な場合にはそれを補完する能力を維持します。
- 自動化されたメタデータ管理、データセットのキュレーション、およびモデル最適化により、ミッション固有の認識モデルの、再現可能かつ追跡可能な開発を支援します。
- AIMMGenは、Prismデジタル製品エコシステムの一部分として、合成データや学習ワークフローを、OEMプラットフォームに実装可能なデジタル認識機能に変換する役割を担います。
- 実証結果では、空対地検知における測定可能なパフォーマンスの向上が見られます。また、MWIRを用いた詳細な船級分類のための、合成データのみによるモデル学習の実証例も提示されています。
今、合成データが重要である理由
モデル学習における合成データの戦略的価値は、もはや学習データの不足を補うことだけではありません。ソフトウェア定義センシングや、フィールド適応可能なAI認識機能を迅速に開発するための実用的な手法になりつつあります。ミッション要件が高度化していく中で、顧客は数ヵ月に及ぶデータ収集やラベリングの作業をやり直すことなく、新たなターゲットクラスへの拡張や、異なるセンサーモダリティ間での検証、組み込みプロセッサへの実装が可能なモデルを必要としています。
Teledyne FLIR OEMにとって、AIMMGenは、自社のデジタル製品戦略を支えるモデル生成の基盤となっています。入手が困難、高価、あるいは収集が難しい画像データを、検出・追跡・ターゲット認識およびミッション固有の認識を行うPrismアプリケーション用の、検証済みのAIモデルに変換することが、AIMMGenによって可能になります。
合成データとAIモデルの生成
自動運転などの市場では、多くの場合、開発者が大規模な学習ライブラリにアクセス可能です。これと対照的に、軍事およびミッション固有の検知システムを開発している組織は、代表的なターゲットデータへのアクセスが制限されている場合が少なくありません。高精度な分類器を開発するには、実データが依然として重要ですが、実測データの入手が困難な場合、利用が制限されている場合、または収集に莫大なコストがかかる場合には、合成データが、実測データセットを拡張したり、きめ細かな分類器を開発したりするための実用的な手段となります。
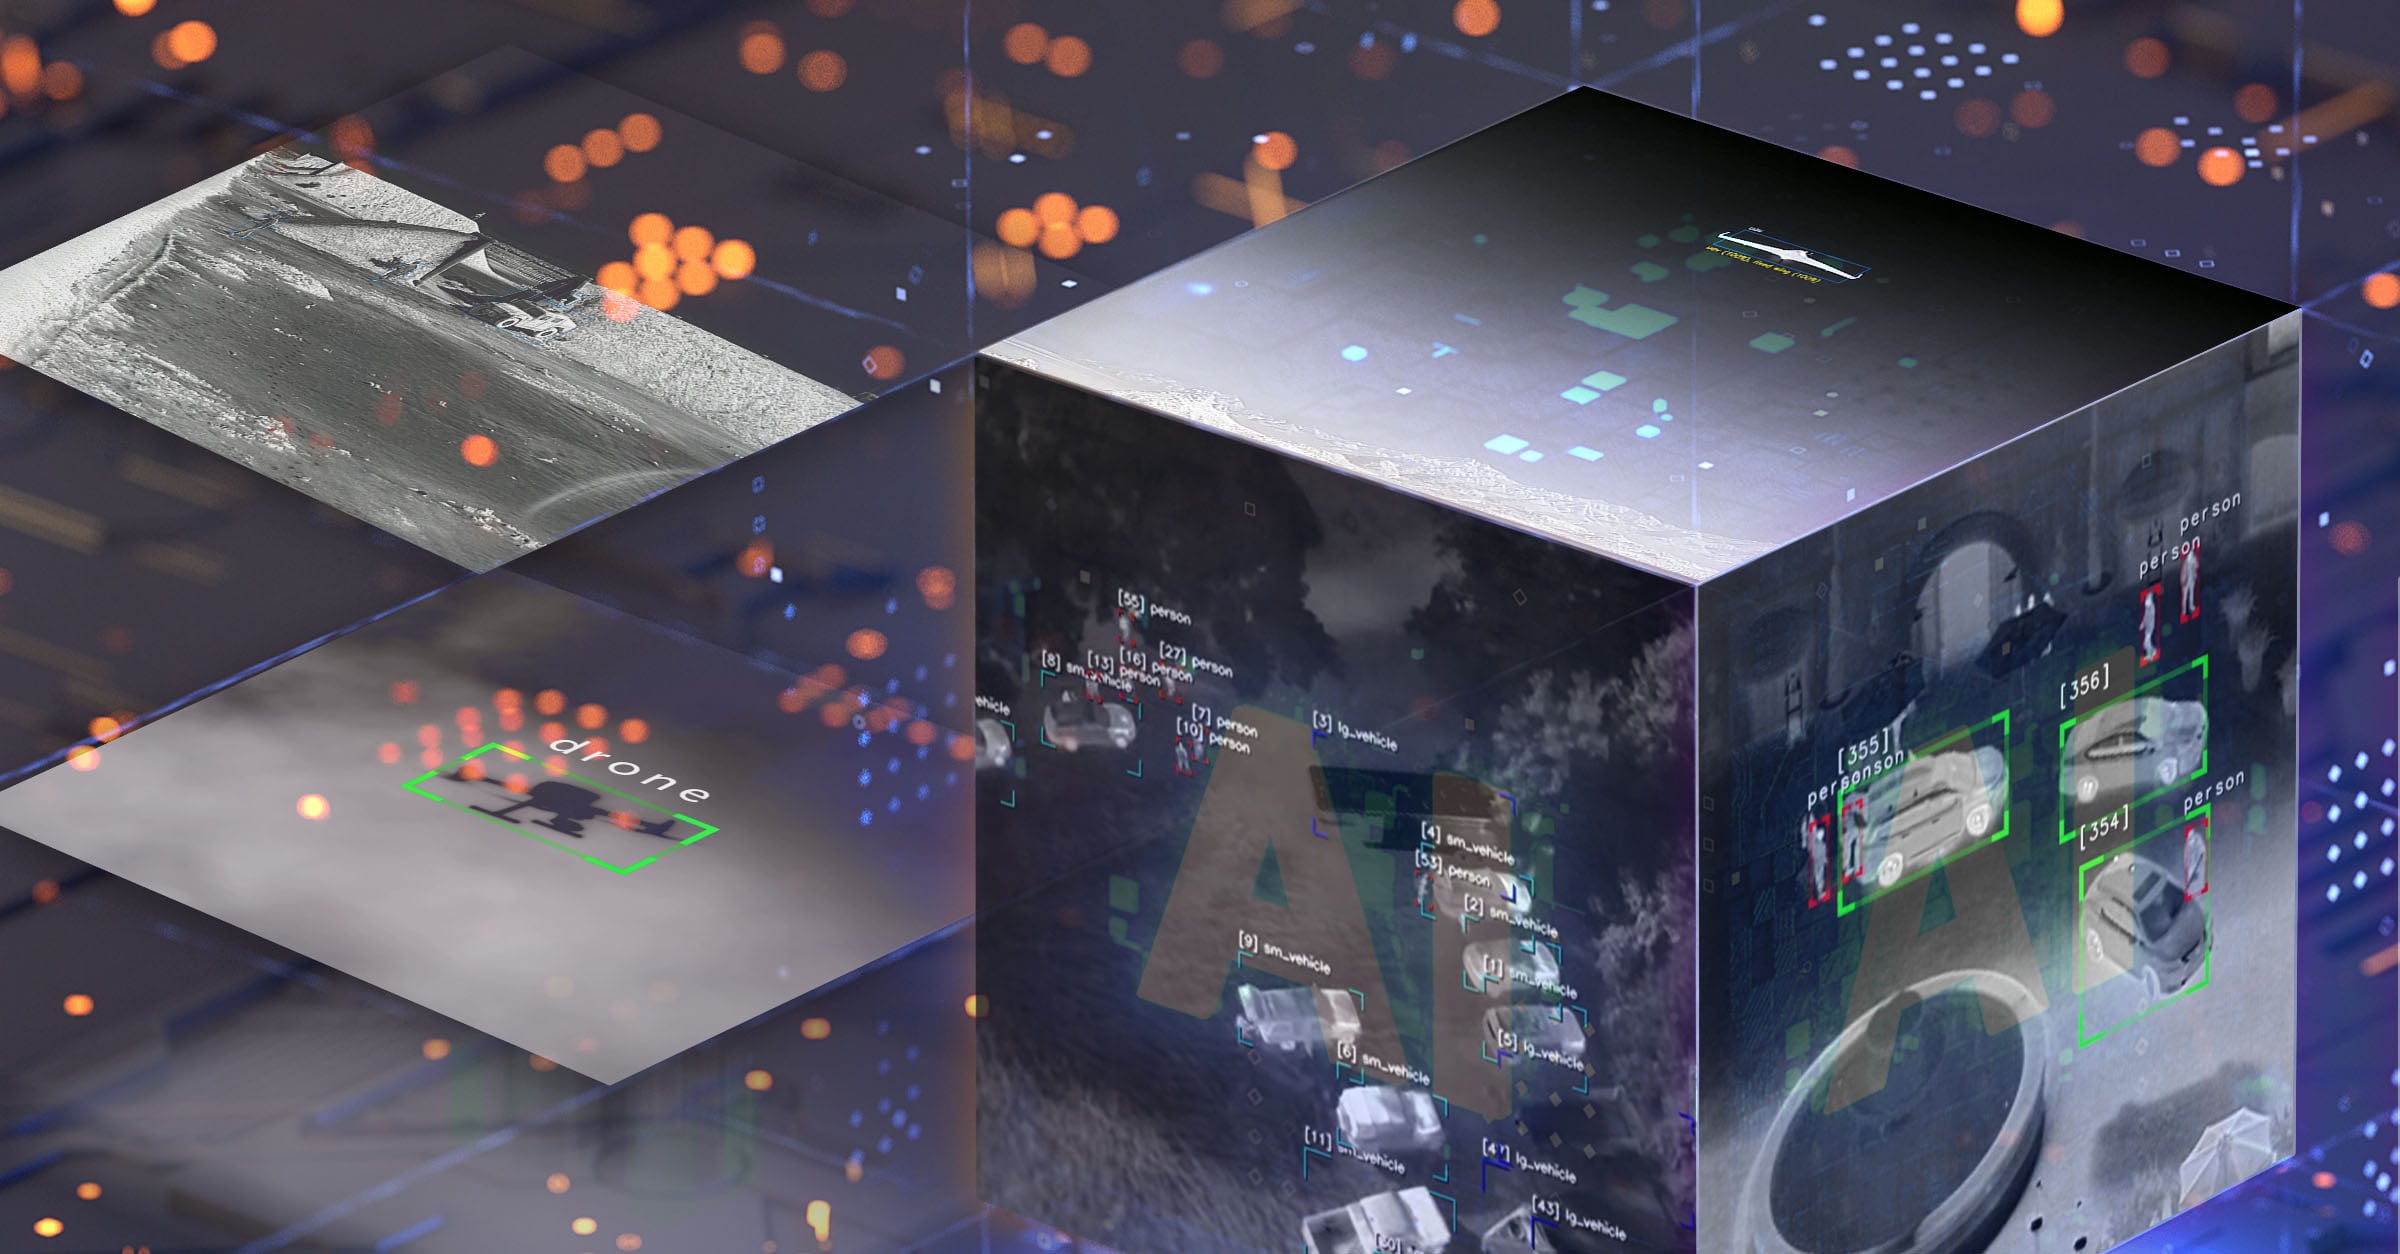
Teledyne FLIR OEMのAIMMGen(AI Modeling and Model Generation)は、自動ターゲット認識(ATR)アルゴリズムの開発者およびOEMインテグレーター向けに、大規模な自動データ生成、インテリジェントなデータ取得、AIモデルの最適化を単一のパイプラインに統合しています。Prismデジタル製品エコシステムの中で、AIMMGenはモデルファクトリーとして機能します。具体的には、ミッション対応ソフトウェアアプリケーションや組み込みの認識モジュール向けに、AI認識モデルの作成、学習、テスト、デリバリーを支援します。このツールチェーンは、ターゲット物体の種類、位置、向き、センサーモダリティ、構成、軌道、環境状態など、実際のシナリオに対応する合成データを迅速に生成します。これを使用すれば、数日で数百万のラベル付き画像を生成できます。一方、現場でのデータ収集や手作業によるラベル付けは、一般に数週間から数ヵ月を要します。
AIMMGenは、各画像のラベルを自動的に生成し、画像セットとともに収集メタデータを保存します。さまざまなユースケースに対応する学習、検証、反復可能な導入をサポートするため、各画像やターゲットのメタデータがデータレイクに保存され、迅速なキュレーションやデータセット構築が可能です。このメタデータには、収集パラメータ、ターゲット情報、および画像パラメータが含まれます。AIMMGenの拡張可能かつモデル非依存の学習フレームワークは、さまざまなユースケースやタスク向けに、クラウドスケールでの学習と最適化を可能にします。この追跡可能なワークフローは、モデルがどのように機能するかだけでなく、どのようなデータ、条件、前提に基づいてそのモデルが開発されたのかを顧客が理解するのに役立ちます。
合成データから実装可能なデジタル認識へ
AIMMGenのワークフローは、エンドツーエンドのデジタル認識パイプラインの一部分として見た場合に、最大の価値があります。合成データの生成により、ラベル付き画像が大規模に生成されます。データセットのキュレーションとメタデータ管理により、データの検索と再利用が可能になります。自動化された学習と最適化により、厳選されたデータがモデルに変換されます。検証およびパフォーマンステストにより、現場に投入されるアプリケーションをそのモデルがサポート可能であるという証拠が提供されます。Prismエコシステム内で、これらのアウトプットは、エッジでの検出、追跡、分類、計算イメージング、ターゲット認識を実行するソフトウェア製品やモジュールをサポートできます。
OEMの顧客にとって、モデル学習だけが課題であることは稀です。より大きな目標は、開発リスクを低減すること、機能実現までの期間を短縮すること、そしてターゲット、センサー、展開プラットフォーム、ミッション要件の変化に合わせて認識ソフトウェアを適応させることです。
ステップ1: AIMMGenによる合成データ生成プロセス
AIMMGenプロセスの最初の段階は、データの生成です。まず場所のタイプ、センサー解像度、ターゲット物体のタイプ、画像条件、センサー構成、および必要な画像枚数の指定を行います。画像の総数が目標数に達するかそれを超えるまで、これらの仕様をランダムに組み合わせたものが作成されます。データ生成パイプラインは、地球規模の正確な地形データを含む地理特化型のシミュレーションエンジンを稼働させ、環境条件を設定し、20,000種類以上の独自モデルからサンプリングされたターゲットを挿入して、データの収集を開始します。正解データがメタデータとして自動的に生成され、ターゲットメタデータとともに保存されます。
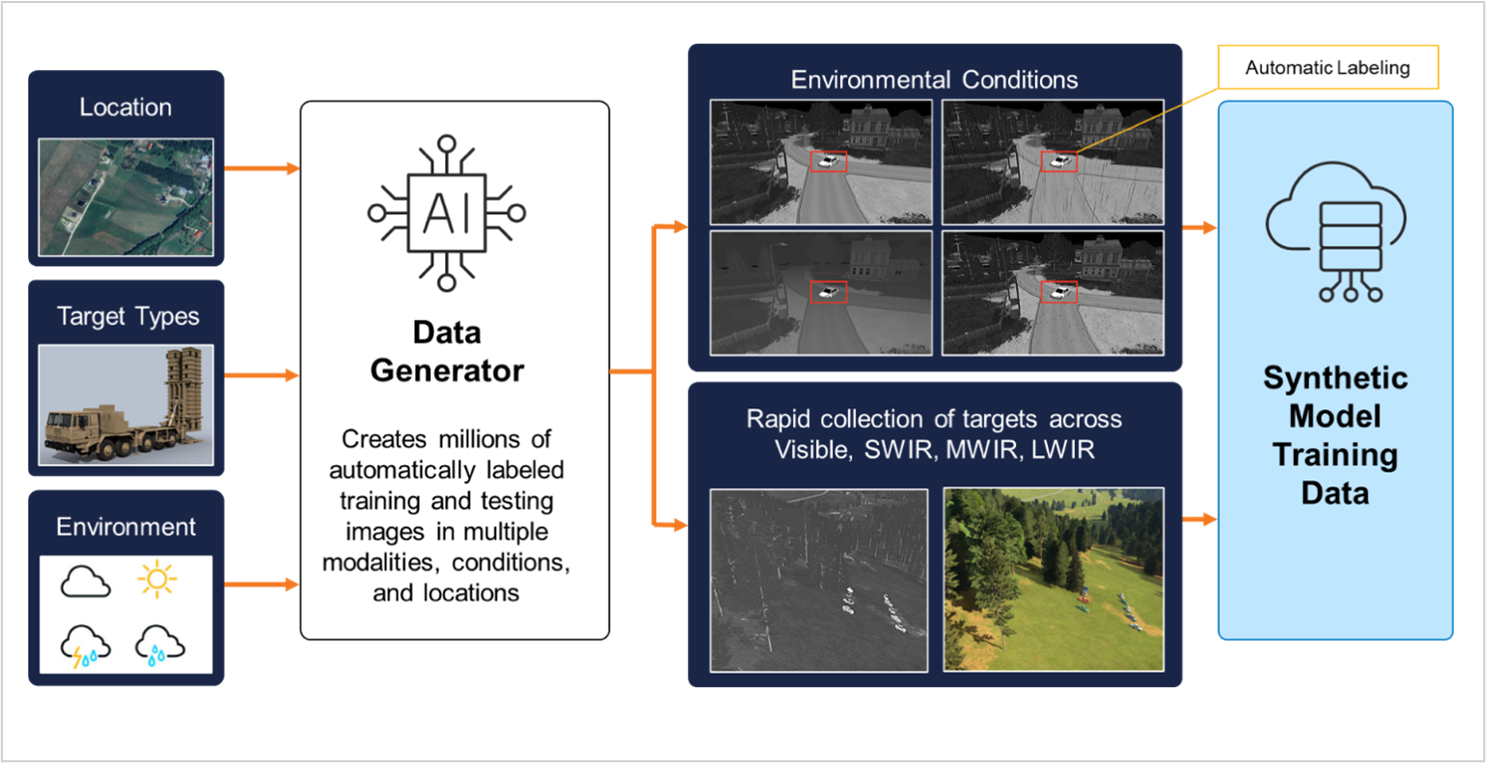
図1. 合成学習データをわずか数分で低コストに生成
各画像の場所を示す最終的なURIや関連するターゲットメタデータを含む画像メタデータが取得され、Elasticsearchデータベースに保存されます。これらのメタデータは個別のインデックスに保存され、一意の識別子を介してリンクされるので、ユーザーがデータサブセット全体を可視化、フィルタリング、検索することが可能です。生成されたデータは、実験計画やデータセットの開発を支援するため、可視化ツールを使用してキュレーションできます。
ステップ2: AIMMGenモデルの学習と最適化
第2段階は、モデルの自動学習と最適化です。データセット、目標とするモデルのパフォーマンス特性、および最適化指標をユーザーが指定します。AIMMGenは、AI学習ノードのクラスターをオーケストレーションし、ベースラインおよびユーザー定義の指標に基づいて最適化されたモデルの学習、評価、生成を行います。この学習フレームワークは特定のモデルに依存しないため、ユーザーはAIMMGen内で独自のデータパイプラインやモデルアーキテクチャを作成できます。トレーサビリティ、再現性、および顧客のミッションやターゲット群の変化に応じた将来的な改良を支援するため、出力モデルが追跡され、データベースに保存されます。
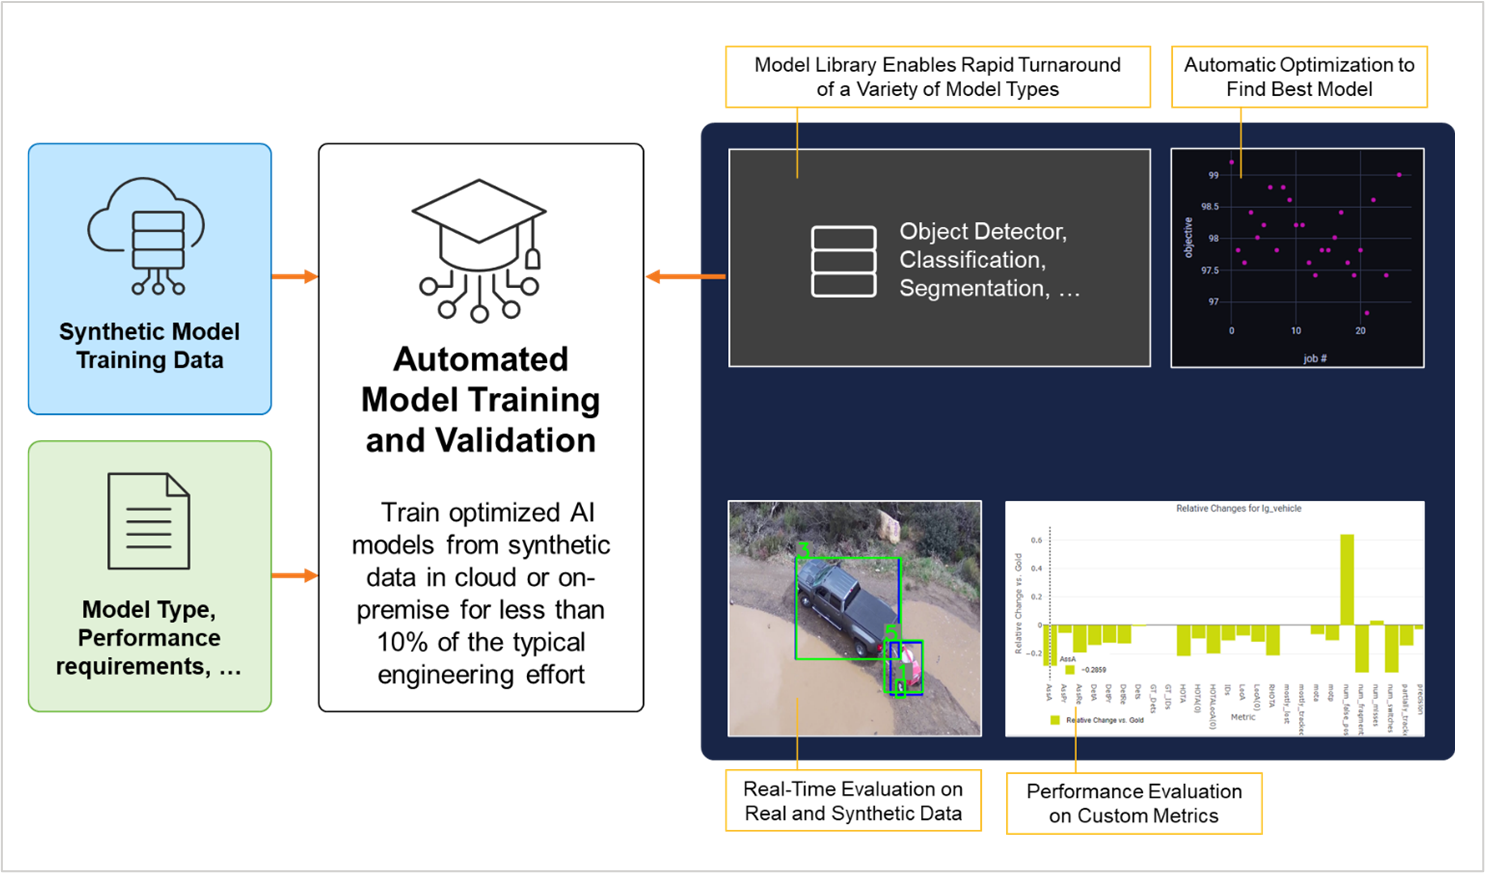
図2. 自動学習と最適化
AI認識モデル最適化のためのベースラインパフォーマンス指標
AI認識モデルの開発において、適合率、再現率、F1スコアは、モデルが物体やインスタンスをどれほど正確に識別・分類しているかを評価するための重要な指標です。
適合率は、モデルによって行われた陽性の予測の正確さを測る値です。偽陽性のコストが高い場合には、これが重要となります。軍事用途では、脅威でないものを脅威と誤認すると、不要な行動につながるおそれがあります。
適合率 = 真陽性/(真陽性 + 偽陽性)
再現率(感度または真陽性率とも呼ばれる)は、関連するすべてのインスタンスを識別するモデルの能力を表します。これは、陽性のインスタンスを見落とせば重大な結果につながる場合に極めて重要です(たとえば、実際の脅威を検出できない場合の危険性など)。
再現率 = 真陽性/(真陽性 + 偽陰性)
F1スコアは、適合率と再現率の両方を考慮し、モデルのパフォーマンスをバランスよく評価する指標となります。これは、不均衡なデータセットを扱う際のモデルの全体的なパフォーマンスを測る優れた指標であり、堅牢な認識システムを開発する上で不可欠です。
F1スコア = 2 x(適合率 * 再現率)/(適合率 + 再現率)
AIMMGenの応用例と結果
AIMMGenは、空対地検知やきめ細かい船級分類など、複数のアプリケーションやセンサー領域で検証済みです。
空対地検知の実験で、Teledyne FLIR OEMは、実測のEO(電気光学)およびIR(赤外線)データを含む物体検知用学習データセットに、合成EOおよびLWIR(長波長赤外線)データを追加しました。学習スキームをわずかに変更しただけで、AIMMGenで学習したモデルは、再現率に関して測定可能な改善を達成しました。これは運用上の観点から重要です。なぜなら、監視、ターゲット捕捉、部隊防護にかかわる多くのワークフローで、検出漏れは、偽陽性の増加よりも重大な結果を招く可能性があるからです。この改善は、F1スコアの全体的な向上に反映されています。
表1. AIMMGenモデルと実データのみで学習したモデルの比較
|
|
AIMMGenモデル |
既存の実テータのみのモデル |
| 精度 |
0.71 ± 0.01 |
0.71 |
|
再現率 |
0.52 ± 0.01 |
0.48 |
|
F1スコア |
0.60 ± 0.01 |
0.57 |
AIMMGenは、中波赤外線(MWIR)を使用した海洋環境での事例が示すように、実際の学習データがほとんど、または全くない状態でも、AIモデルの生成をサポートすることが可能です。海上物体のきめ細かい識別には、通常、船舶の種類に関する詳細なラベル付きの高価なMWIRデータセットが必要です。実際のデータが限られている場合、「小型船舶」や「大型船舶」といった大まかな分類しか識別できないモデルになる可能性があります。しかし、AIMMGenを使用することで、合成データのみで学習させたモデルが、特定の船舶サブタイプを分類できるようになりました。淡水域や沿岸環境を含む複数の実環境のデータ集合を使用してパフォーマンスを検証した結果、合成データのみを用いた学習の堅牢性が実証され、実際の画像が希少または入手困難な場合でもターゲットクラスを拡大できる可能性が示されました。
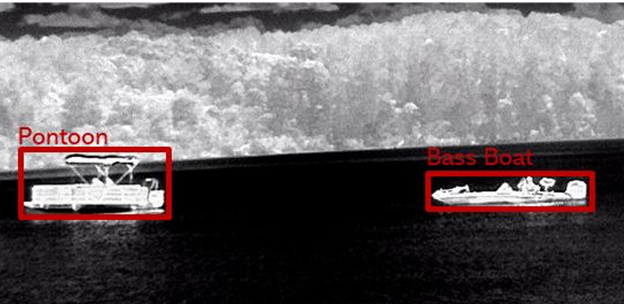
図3:合成データで学習済みのAIモデルを使用して、MWIR画像の船舶を詳細に識別
結語
堅牢なAI認識システムを導入する上で、EO、IR、マルチスペクトル用途向けの大規模かつ多様な学習用データセットの構築は、依然として大きな課題です。AIMMGenは、合成画像、自動化されたメタデータ管理、データセットのキュレーション、モデルの最適化によって、この課題に対処します。Teledyne FLIR OEMの広範なPrismデジタル製品戦略の一環として、AIMMGenは単なるデータ生成ツールチェーンにとどまらない存在です。防衛、自律システム、緊急対応などのOEMアプリケーションで、ミッション固有のAI認識機能を開発・検証・拡張するためのモデル生成基盤を提供します。
PrismソフトウェアファミリーとTeledyne FLIR OEMデジタル製品の詳細については、oem.flir.com/prismをご覧ください。