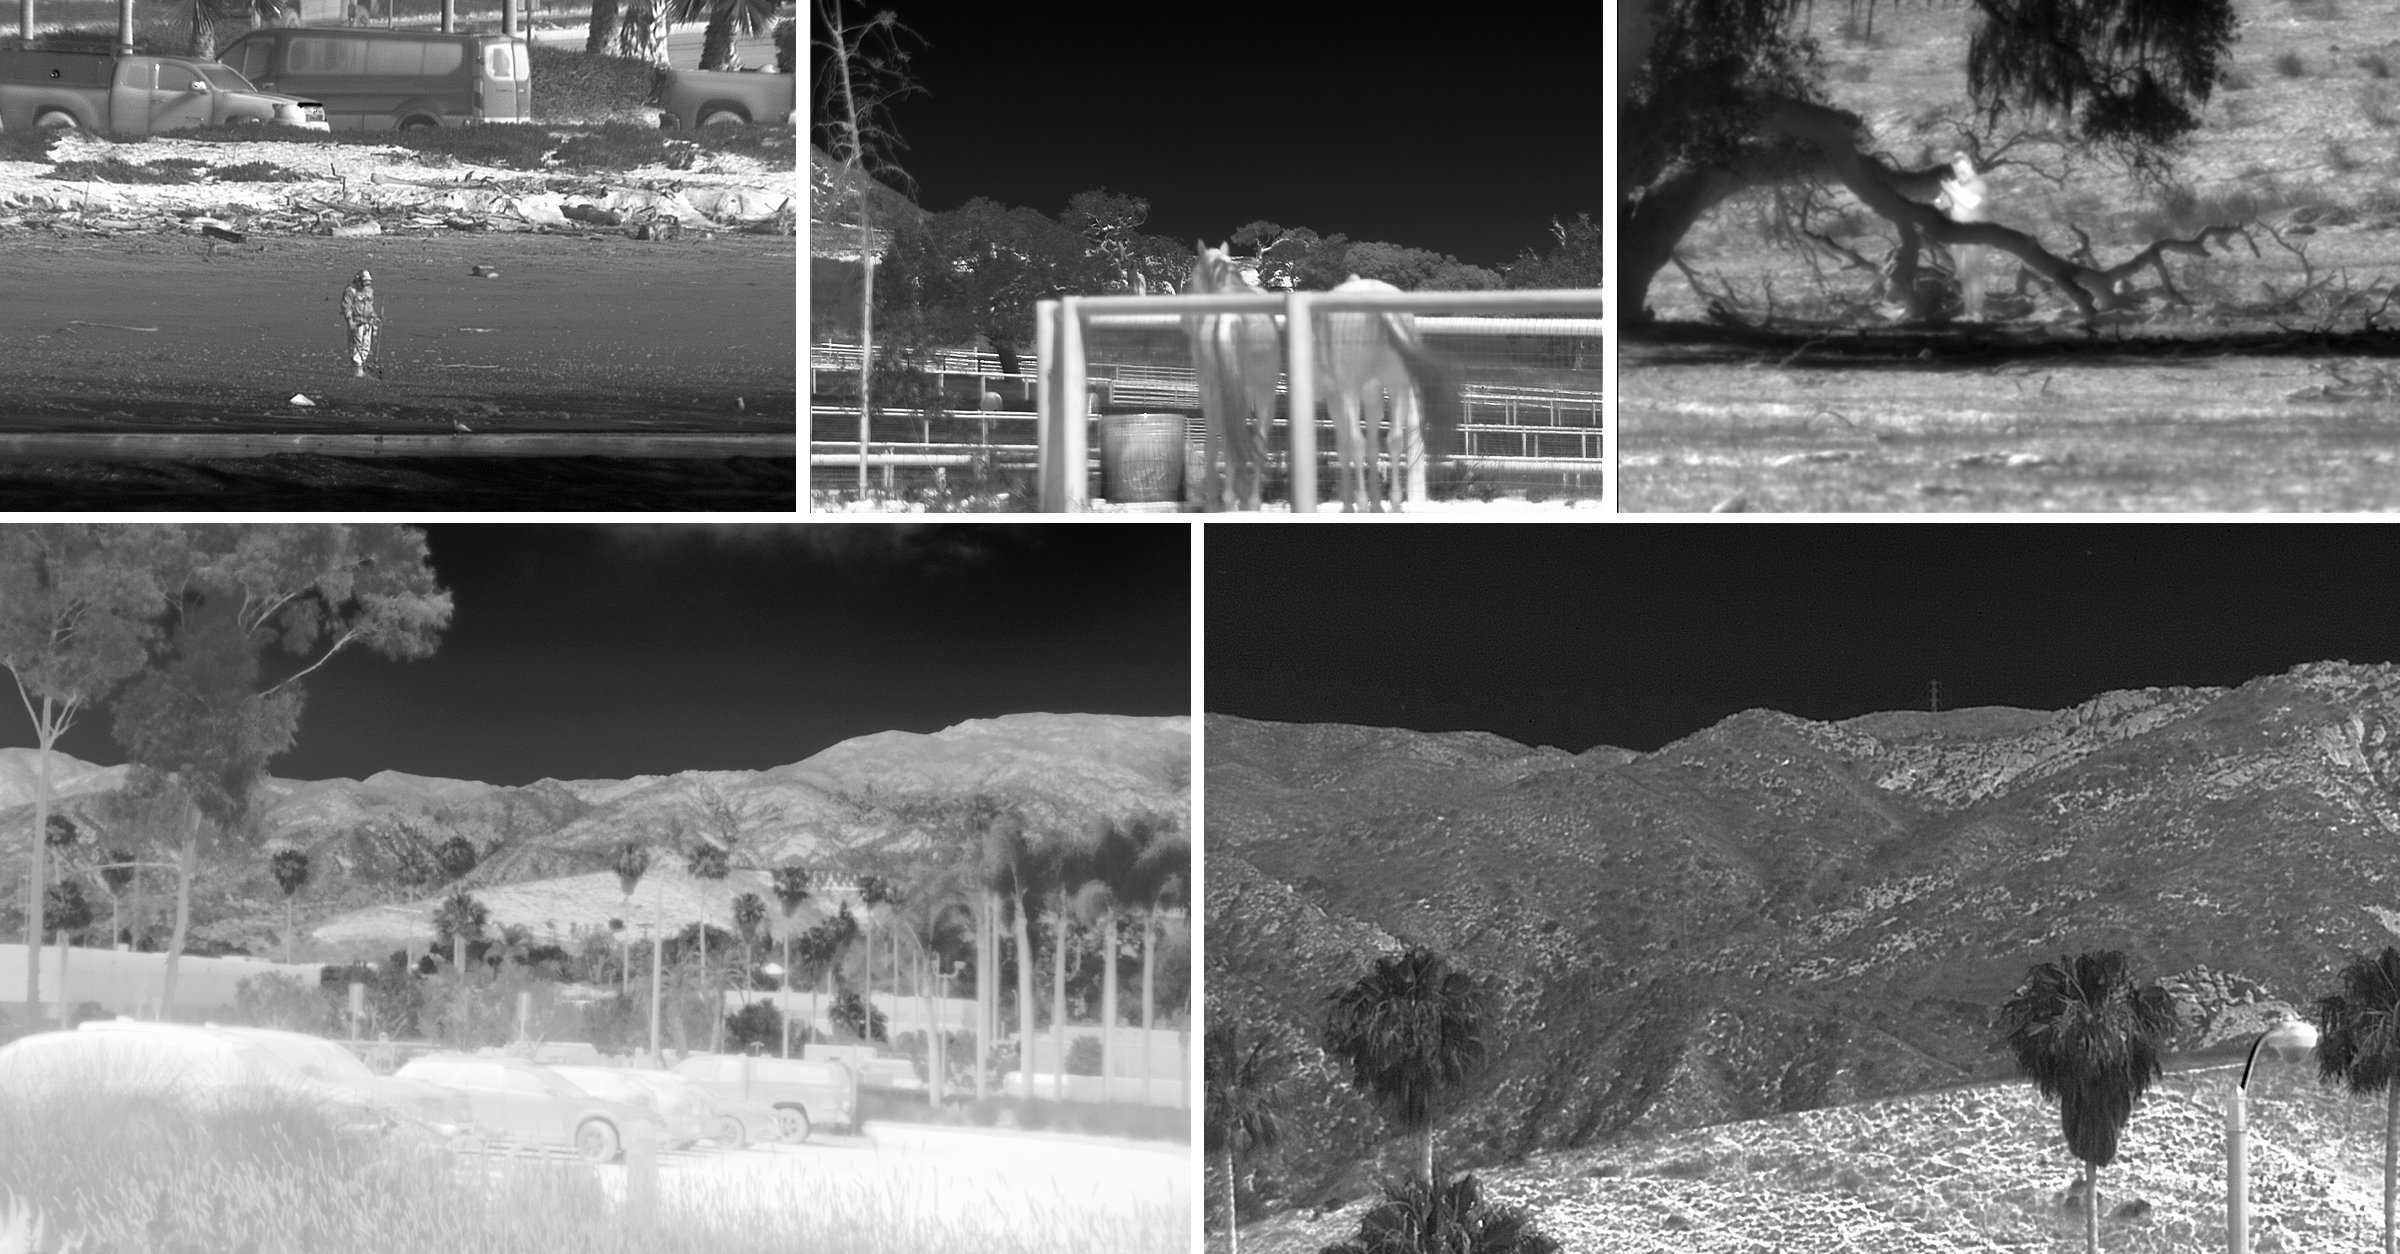
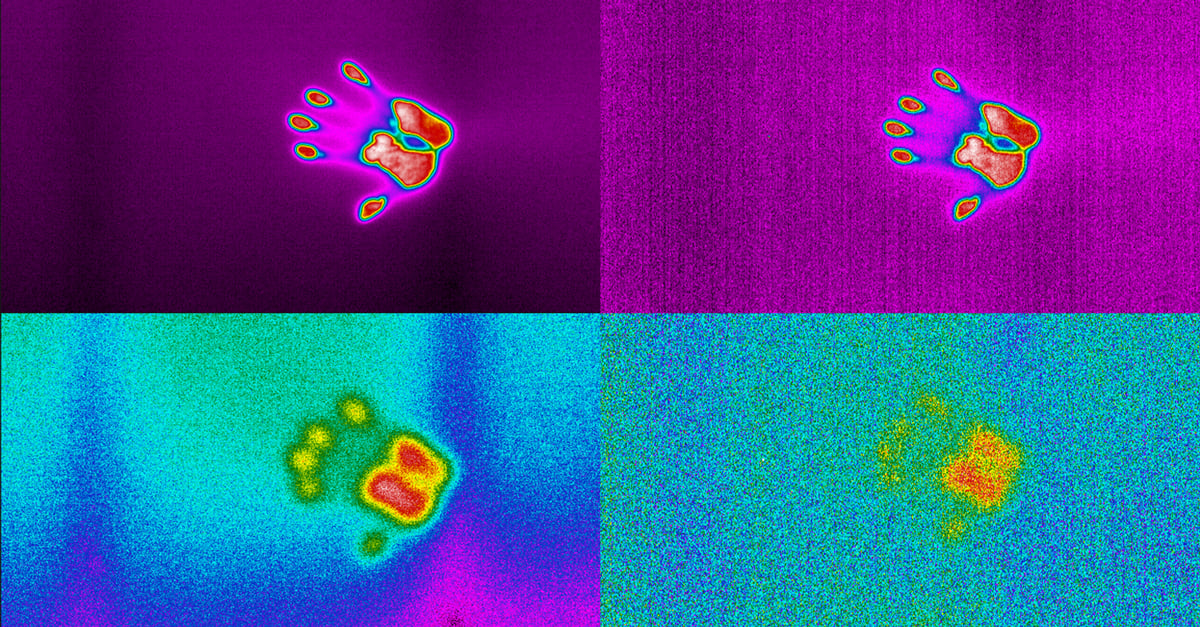
組み込みAIを超えて:センサーデータからエッジでの導入まで、サーマル認識パイプラインを最適化する
要旨
ディープラーニング、コンピュテーショナルイメージング、組み込みプロセッサーの急速な進歩により、高度な認識ワークロードをエッジで実行できるようになりました。サーマルシステムやマルチスペクトルシステムでは、競争優位性は、人工知能(AI)モデルを組み込みプロセッサー上に搭載することだけにとどまりません。より大きな優位性は、サイズ、重量、電力、レイテンシー、帯域幅、環境条件といった実環境の制約の下で、センサーデータや画像信号処理から、物体検出、追跡、ランタイム最適化、熱管理、現場導入に至るまで、認識パイプライン全体を最適化することによって生まれます。
このホワイトペーパーでは、Teledyne FLIR OEMが、Prism™によるサーマルおよびマルチスペクトル画像信号処理、アプリケーション固有の検出・追跡ライブラリ、最新の組み込みAIプラットフォームを統合し、センシングの現場で実用的な情報を提供するインテリジェントイメージングシステムの構築をどのように支援しているかを説明します。
.
目次
- 略語
- はじめに
- 軽量モデルとモバイルプロセッサーの進化
- 組み込みプラットフォーム向けニューラルネットワークの設計 - PeleeTMの紹介
- 最適化
- モバイルプロセッサーがもたらす迅速な開発力
- フレームワーク
- ビデオ処理パイプライン
- Prism ISPの機能
- まとめ
1. 略語
| 略語 | 定義 |
|---|---|
| ADAS | 先進運転支援システム |
| AGC | 自動ゲイン制御 |
| AI | 人工知能 |
| ARM | Advanced RISC Machineプロセッサーアーキテクチャ |
| ASIC | 特定用途向け集積回路 |
| ATR | 自動ターゲット認識 |
| CI | コンピュテーショナルイメージング |
| CNN | 畳み込みニューラルネットワーク |
| CPU | 中央処理装置 |
| DSP | デジタル信号プロセッサー |
| FFB | 特徴融合ブロック |
| FPGA | フィールドプログラマブルゲートアレイ |
| GPU | グラフィックス処理ユニット |
| HTP | Hexagon Tensorプロセッサー |
| ILSVRC | ImageNet Large Scale Visual Recognition Challenge |
| INT | INT8やINT4などの整数精度フォーマット |
| IP | 知的財産 |
| IR | 赤外線 |
| ISR | 情報・監視・偵察 |
| ISP | 画像信号処理/画像信号プロセッサー |
| LCE | ローカルコントラスト強調 |
| MSX | マルチスペクトル動画像解析 |
| NMS | 非最大抑制 |
| NPU | ニューラル処理ユニット |
| ONNX | Open Neural Network Exchange |
| PANet | Path Aggregation Feature Pyramid Network |
| RAM | ランダムアクセスメモリー |
| RISC | Reduced Instruction Set Computer |
| SDK | ソフトウェア開発キット |
| SLAM | Simultaneous Localization and Mapping |
| SoC | システムオンチップ |
| SoM | システムオンモジュール |
| SSD | Single Shot Detector |
| SWaP | サイズ、重量、電力 |
| TOPS | 1秒あたり数兆回の演算 |
| YOLO | You Only Look Once |
2. はじめに
過去10年にわたり、ディープラーニングの進歩により、コンピュータービジョンは、手作業による特徴抽出を中心としたシステムから、大規模なデータセットでトレーニングされ、特定の認識タスクに最適化されたデータ駆動型モデルへと変化を遂げています。この変化により、物体検出の課題は根本的に変わりました。開発者は、固定的な視覚特徴を手作業で設計するのではなく、代表性のあるトレーニングデータを収集し、適切なモデルアーキテクチャを選択し、ますます高度化するニューラルネットワークを実際の導入条件に適応させることに注力するようになりました。技術開発の初期段階ではよくあることですが、当初は、これらのモデルのトレーニングと実行に必要な計算能力にあまり注意が払われていませんでした。
こうした配慮の不足により、新しいテクノロジーをビジョンベースのシステムでどのように活用できるかが制限されていました。特に、リアルタイムの物体分類、メタデータ生成、アラートが重要となる映像中心のアプリケーションでは、その制約が顕著でした。同時に、携帯電話業界ではカメラ性能をめぐる開発競争が激化していました。その結果、アルゴリズムや現在コンピュテーショナルイメージング(CI)と呼ばれる技術を活用してカメラ性能を継続的に向上させる、高度な画像信号プロセッサー(ISP)が急速に発展しました。近年では、大規模言語モデル、ビジョン言語モデル、マルチモーダルAIの急速な普及により、従来のビジョンパイプラインと、基盤モデルに着想を得た新しいワークロードの両方をセンサーの近くで実行できるヘテロジニアスプロセッサーの需要が高まっています。
今日のプロセッサーは、複数の中央処理装置(CPU)、グラフィックス処理ユニット(GPU)、デジタル信号プロセッサー(DSP)、ニューラル処理ユニット(NPU)、ISPコンピュートブロックを備えたヘテロジニアスアーキテクチャを採用しています。さらに、オープンソースコミュニティは、YOLOファミリーの物体検出器、Transformerベースの検出モデル、Open Neural Network Exchange(ONNX)などのプラットフォーム非依存のファイル形式、PyTorchやTensorFlowなどの開発フレームワーク、TensorRT、ONNX Runtime、OpenVINO、LiteRT/TensorFlow Liteなどの本番環境向けランタイム、ハードウェア固有のソフトウェア開発キット(SDK)など、認識システムの構築に使用される多くのビルディングブロックを提供しています。PyTorchまたはTensorFlowでトレーニングし、ONNXにエクスポートし、ターゲットランタイム向けに最適化と量子化を行ったうえで、導入先のハードウェア上でレイテンシー、電力、メモリー使用量、精度を直接検証する、というワークフローが一般的になっています。
Teledyne FLIR OEMは、幅広い用途に向けて、認識機能とコンピュテーショナルイメージングまたは画像信号処理を、サイズ、重量、電力(SWaP)を高度に最適化したプロセッサーに統合することに注力しています。最先端ノードで製造された新しいシリコン設計を活用することで、システム開発者はバッテリー駆動時間を延ばし、システムの熱管理を簡素化できます。
これは、インテリジェントサーマルシステムにおける中心的な設計課題です。可視カメラ向けのAI技術は、センサーの物理特性、少ないテクスチャ情報、環境変動、大気の影響、ターゲットサイズ、光学系、フレームレート、キャリブレーション、検出器に入力される情報を左右する画像処理工程を考慮せずに、サーマルイメージングへそのまま応用することはできません。実際には、検出と追跡の性能は、生のセンサーデータ、温度情報付きまたは温度情報なしの処理、トーンマッピング、ノイズ除去、安定化、超解像、モデルアーキテクチャ、量子化、ランタイムマッピング、メモリー帯域幅、電力管理といった一連の処理全体に依存します。Teledyne FLIR OEMの優位性は、AI推論を単独の機能として扱うのではなく、その一連の処理全体を最適化できる点にあります。
3. 軽量モデルの進化
とモバイルプロセッサー
ディープラーニングがコンピュータービジョンに与える影響が認識されると、低コストのモバイルプロセッサー上でエッジ実行できるニューラルネットワークとモデルの開発が始まりました。これにより、自動ターゲット認識(ATR)、車両自律走行、先進運転支援システム(ADAS)、セキュリティ、地上および空中の情報・監視・偵察(ISR)など、リアルタイム映像アプリケーション向けの物体検出が可能になりました。ビジョンベースの製品に組み込まれるその他のソフトウェアパッケージには、SLAM(Simultaneous Localization and Mapping)、衝突回避、センサーフュージョン、オプティカルフロー、物体追跡などがあります。これらの計算負荷の高い機能は、特定のハードウェアアーキテクチャ向けにコンパイルされると、ターゲットとなるシステムオンチップ(SoC)内のCPU、GPU、DSP、NPU、ISP、メモリーサブシステムにマッピングされます。最新のヘテロジニアスプロセッサー全体でこれらのタスクを管理することは、エンジニアリング上の大きな課題ですが、クラウド依存型のアーキテクチャーと比べて、電力、レイテンシー、熱管理の面で大きな利点をもたらします。わずか数世代のプロセッサーで、高度なSoCは10 nmクラスのノードから7 nm、5 nm、4 nmクラスの設計へと移行し、ワットあたりの性能が大幅に向上しています。
表1 - 代表的な組み込みエッジAIプロセッサーとモジュール
| プラットフォーム | プロセスノード | AI性能 | 電力範囲 | 最適なユースケース |
|---|---|---|---|---|
| NVIDIA Jetson Orin Nano Super Developer Kit | 8 nmクラス | 最大67 INT8 TOPS | 7 W~25 Wで設定可能 | プロトタイピング、ロボティクス、ビジョンAI、マルチモーダルエッジAI、CUDAおよびTensorRTをサポートする開発者エコシステム。 |
| NVIDIA Jetson AGX Orin | 8 nmクラス | 最大275 TOPS | 15 W~60 Wで設定可能 | 高性能ロボティクス、マルチカメラ認識、自律システム、大規模なエッジAIワークロード。 |
| Qualcomm Dragonwing QCS8550 | 4 nm | モジュールの実装に応じて最大48 INT8 TOPS | アプリケーションに依存 | スマートカメラ、産業用ドローン、自律型モバイルロボット、エッジAIボックス、高度に統合された低電力IoTプラットフォーム。 |
| Hailo-8 / Hailo-10クラスのアクセラレーター | アクセラレーターに依存 | デバイスに応じて数十~数百TOPS | 低電力アクセラレータークラス | カメラ、ゲートウェイ、産業システム、コストや電力の制約が厳しい導入環境でのビジョンアクセラレーション。 |
画像信号処理とAI物体検出アルゴリズムは、計算負荷が高い処理です。たとえば、Teledyne FLIR OEMの高度なノイズ除去および超解像アルゴリズムは、1ピクセルあたり毎秒最大100,000回の演算(解像度640x512の入力を60フレーム/秒(fps)で処理する場合、約2兆回/秒(TOPS))を実行し、GPUコア上で動作します。大規模な物体検出モデルの実行にも多くの処理能力が必要であり、DSPサブシステム(Qualcomm®)またはGPU(NVIDIA®)上で動作します。
サーマルシステムでは、生のTOPSは有用ではあるものの、指標としては完全ではありません。実際の性能は、パイプラインの各段階が適切なコンピュートリソースにどれだけ効率的にマッピングされているか、映像データがメモリーを何回通過する必要があるか、画像強調によって検出器の信頼度が向上するか低下するか、またシステム全体が電力や熱の制限を超えずに必要なフレームレートを維持できるかどうかに左右されます。したがって、最も効果的な組み込みAI設計は、プロセッサー仕様だけでなく、センシング上の課題と導入環境から出発します。
物体検出器の開発と導入では、プロセッサーアーキテクチャ、目標精度、許容できるレイテンシーまたはフレームレート、メモリー帯域幅、ソフトウェアランタイム、モデルサイズ、電力/熱バジェットなど、考慮すべき変数が数多くあります。組み込みプロセッサー上で物体検出器を実行したいというニーズに応える形で、2015年にワシントン大学のJoseph Redmonが開発したYOLO(You Only Look Once)や、2017年にGoogleが開発したMobileNetなど、複数の低消費電力ニューラルネットワークが開発されてきました。以降、検出器を取り巻く状況は大きく広がり、新しいYOLOファミリーモデル、Transformerベースの検出器、非最大抑制(NMS)フリーのアーキテクチャ、マルチタスク認識やオープンボキャブラリー検出向けに設計されたモデルが登場しています。組み込みサーマルシステムやマルチスペクトルシステムで最も重要なのは、単にどのネットワークが最新かではなく、選択したプロセッサー上で必要な検出性能、レイテンシー、消費電力、統合信頼性を実現できるモデルはどれかという点です。
YOLOは、シングルパスアプローチによって物体検出に革命をもたらしました。領域提案とそれに続く分類など複数の段階を含む領域ベースの畳み込みニューラルネットワーク(RCNN)とは異なり、YOLOはネットワークの単一のフォワードパスで検出と位置特定を行います。入力画像をグリッドに分割し、各グリッドセルについて複数のバウンディングボックスとクラス確率を同時に予測することで、YOLOアルゴリズムは速度と精度の両方を実現します。1段階検出器は、単一のフィードフォワードネットワークを使用して、物体のクラスと位置を直接予測します。SSD(Single Shot Detector)は、予測に複数スケールの特徴量を使用することや、さまざまな物体形状に対応するためにデフォルトボックスとアスペクト比を使用することなど、いくつかの点でYOLOを改善しています。一般に2段階アプローチが高い精度を実現するのに対し、多くの場合1段階アプローチはより高い効率で動作します。新しい検出器では、より優れた特徴集約、量子化を考慮した設計、Transformerに着想を得たアテンションメカニズム、後処理のオーバーヘッドを削減する導入しやすいアーキテクチャにより、このトレードオフ領域の改善が続いています。
4. 組み込みプラットフォーム向けニューラルネットワークの設計 - Peleeの紹介

図1 - オブジェクト検出器のアーキテクチャ(Juan R. Terven、2023年)
サーマルカメラ向けの物体検出を設計するには、汎用ビジョンモデルを選択する場合とは異なる出発点が必要です。サーマル画像は可視画像に比べて視覚的なテクスチャが少ないことが多く、ターゲットが占めるピクセル数もごくわずかな場合があります。また、環境条件によってコントラスト、見かけ上の形状、背景クラッタが変化することもあります。こうした要因により、検出器をセンサー、光学系、画像処理パイプライン、導入先ハードウェアとあわせて共同設計することが重要になります。
Teledyne FLIR OEMは、Peleeネットワーク(特許出願中)の開発により、シングルパスアプローチを拡張しました。畳み込みニューラルネットワーク(CNN)は、特徴抽出器またはバックボーン、特徴アグリゲーターまたはネック、ヘッドまたは物体検出器という3つの主要ブロックで構成されます。Peleeは、特徴の再利用を促進する高密度な接続パターンで構築された新しいバックボーン設計と、さまざまなスケールの受容野を得るための双方向Dense Layerを備えています。Peleeには、PANet(Path Aggregation Feature Pyramid Network)に基づく新しい特徴融合ブロック(FFB)が組み込まれています。小ターゲット検出を念頭に設計された新しいFFBは、出力の各特徴マップが浅い層から学習した詳細情報を保持し、高レベルの意味特徴を取得できるようにすることを目的として、後期融合戦略を採用しています。
| フレームワーク | バックボーン | 計算コスト(FLOPs) | ||
|---|---|---|---|---|
| バックボーン | 合計 | バックボーンの割合 | ||
| SSD | VGG | 31.9 | 34.2 | 93.3% |
| RefineDet | VGG | 31.9 | 37.38 | 85.3% |
| YOLOv3 | DarkNet 53 | 14.51 | 19.54 | 74.2% |
| RetinaNet | ResNet101 | 15.48 | 34.51 | 53.4% |
バックボーンネットワークは、物体検出器のメモリー、速度、性能に直接影響します。SSD CNNでは、計算コストの90%以上がバックボーンネットワークによって消費されます。Teledyne FLIR OEMのCNNは、スクイーズ&エキサイテーションブロックの使用を避け、ハードウェアに応じて活性化関数を慎重に選択し、ネットワークの幅と深さもハードウェアに合わせて調整する新しいバックボーン設計を採用しています。
したがってPeleeは、新しいあらゆるモデルファミリーに対する汎用的なベンチマーク上の勝者ではなく、アプリケーション固有で導入を重視した検出器アーキテクチャとして理解すべきです。その価値は、スマートサーマルカメラにとって重要なエンジニアリング上のトレードオフ領域、すなわち小ターゲット性能、予測可能なレイテンシー、メモリー効率、ハードウェアを考慮した活性化関数の選択、そして制約のあるSWaPエンベロープ内でPrism ISPの機能、ビデオ安定化、追跡、その他の認識ワークロードと並行して動作できることにあります。

図2 - Peleeバックボーンベースのモデル性能

図3 – PeleeとYOLOネットワークの性能比較
5. 最適化
量子化
量子化とは、ニューラルネットワークパラメータの浮動小数点値を圧縮し、推論実行時のモデルレイテンシーの改善、メモリーフットプリントの削減、消費電力の低減を図ることです。モデルトレーニングは通常、高性能なGPUベースのシステム上で32ビット浮動小数点データを使用して実行されます。その後、組み込みプロセッサー上での推論は、プロセッサー、モデルアーキテクチャ、キャリブレーションデータ、許容できる精度上のトレードオフに応じて、FP16、FP8、INT8、INT4、またはその他のランタイム対応精度を使用して最適化されます。
Teledyne FLIR OEMは、メモリーフットプリント、計算時間、エネルギー消費を削減するためにINT8を使用しています。これは、多くの組み込みビジョンワークロードにおいて、INT8が精度と速度の実用的な妥協点であり続けているためです。しかし現在では、導入にあたって、明示的な量子化ワークフロー、代表性のあるキャリブレーションデータ、必要に応じた量子化認識トレーニング、ターゲット固有のエンジン生成への依存度が高まっています。開発者は、FP16、INT8、およびより低精度のオプションを実際のハードウェア上で検証する必要があります。これは、性能、精度、メモリー使用量、熱挙動が、GPU、DSP、NPU、ベンダー固有のランタイム実装によって大きく異なる可能性があるためです。コンピュートリソースを取り戻すことで、開発者は2つ以上のカメラフィードでのリアルタイム推論など、より多くの機能を追加する柔軟性を得られます。
プルーニング
プルーニングは、各ユニットの重要度を判断し、受動的なパスを削除することで、ニューラルネットワーク内の未使用のデータパスを削減する手法です。トレーニング後、ネットワーク内の多くのニューロンは重み値が0になるため、量子化後の二次的なネットワークトレーニングプロセスを通じて、これらのニューロンを除去できます。現在のプルーニング手法には、重みプルーニング、チャネルプルーニング、ニューロンプルーニングがあり、それぞれに長所と短所があります。
ユニットの重要度を判断する基準は、精度に影響を与える可能性があります。制約付き学習手法を使用することで改善できる場合がありますが、実装は複雑です。プルーニングにおけるランダムサーチ手法は実装が容易ですが、精度を改善する他の手法と比べると、ネットワークモデルの性能は限定的です。したがって、各手法は実際のアプリケーションシナリオに応じて選択する必要があります。複雑さとモデル圧縮効率を両立できる単一の手法はありません。[i]
熱管理
ドローンや兵器用照準器を含む多くの製品カテゴリーでは、消費電力が設計上の重要な制約となります。消費電力が大きいと、動作時間が制限され、サポートロジスティクス上の課題が増え、熱管理の複雑さとコストも増加します。一部のバッテリー駆動デバイスでは、消費電力を最小限に抑えるために、フィールドプログラマブルゲートアレイ(FPGA)または特定用途向け集積回路(ASIC)プロセッサーを使用する選択肢があります。しかし、これらのライブラリは通常、OpenCVなどのオープンソースコンポーネントやフレームワークを使用して、Advanced RISC Machine(ARM)プロセッサーやその他のコア上で動作するようにコンパイルされているため、サードパーティ製の解析ソフトウェアやISPソフトウェアは利用できません。電力制約が最も厳しい製品には当てはまらないものの、4 nm~7 nmノードで製造された新世代の組み込みプロセッサーの消費電力要件により、システム設計者は製品に高付加価値機能を追加するための多くの選択肢を得られます。
複数のカメラを動作させ、物体検出器、ターゲットトラッカー、ローカルコントラスト強調など複数の機能ルーチンを実行するシステムでは、プロセッサーのスループットが上限に達し、大量の熱が発生します。これに対する対策として、ソフトウェア開発者は、動的に設定または調整できる構成パラメーターを組み込むことができます。たとえば、多くのアプリケーションでは、フレームレートと同じ頻度で推論を行う必要はありません。推論出力を10 fps以下に抑えることで、ソフトウェアスタック全体の電力プロファイルを電力バジェットに収まるよう管理できます。
6. モバイルプロセッサーがもたらす
迅速な開発力
CNNモデルとCIアルゴリズムの実行には、非常に大きな計算処理能力が求められます。最近まで、組み込みプロセッサーには、AIやCIのワークロードに対応できる処理能力がありませんでした。AIには、積和演算の大規模な並列処理が必要です。従来のGPUは、グラフィックス処理で同様の並列処理を実行できたため、AIアプリケーション、特にモデルトレーニングに転用されました。モデルトレーニング分野でNVIDIAが主要なプレイヤーとしての地位を確立したのは、そのためです。
今日のモバイルプロセッサーおよび組み込みプロセッサーは、工学技術の目覚ましい成果です。たとえば、Qualcomm{ut}のDragonwing QCS8550 SoCは、要求の厳しいIoTおよびエッジAIアプリケーション向けに、CPU、GPU、DSP、NPU、コンピュータービジョン、専用ISPリソースを備えた4 nm設計です。統合ISPおよびコンピュータービジョンリソースは、ビデオノイズ除去、安定化、画像補正、ホワイトバランス、カラー処理、自動ゲイン制御、フォーカス、その他のカメラ機能をサポートしています。このクラスのチップには膨大な開発投資が必要であり、高度なファウンドリ能力、ソフトウェアツール、長期的なエコシステムサポートに依存しています。

図5 - QCS 8550プロセッサーコア
Teledyne FLIR OEMは、お客様がその上に製品を構築できるプラットフォームの実現を目指しました。このプラットフォームは、高度に統合されたソフトウェアスタックの作成を可能にし、可能な場合は単一のプロセッサーを使用することで、コスト、レイテンシー、消費電力を最小限に抑えます。これは、Teledyne FLIR OEM Boson®サーマル赤外線(IR)カメラモジュール向けにIntel® Myriad™プロセッサーを選定したことを含め、数世代のプラットフォームにわたる目標でした。Myriadチップアーキテクチャでは、コンピュテーショナルイメージングやCNNベースの物体検出器に求められる、より大きな計算ニーズを満たすことができませんでした。NVIDIA Xavier、NVIDIA Jetson Orinクラスのモジュール、Qualcomm RB5/QCS5165、Qualcomm QCS8550クラスのプロセッサーの導入により、特定のプロセッサーコアやアクセラレーターに複数のソフトウェアスタックを分散して実行することが現実のものとなりました。
システムオンチップ(SoC)の概要
今日の組み込みプロセッサーは最新のファウンドリノードを活用しており、統合メモリーを備えたマルチコア設計を可能にしています。プロセッサーのサプライヤーは非常に包括的な開発サポートを提供しており、開発者はこれらのマルチコアプロセッサー上にコードを導入して、電力/熱バジェットを満たしながら性能を最大化できます。
CPU
CPUの中核機能は、ランダムアクセスメモリー(RAM)から命令をフェッチし、その命令をデコードして実行することです。CPUは、逐次ワークロードを処理するルーチンを実行するように設計された汎用プロセッサーです。多くのCPUには、一部の処理を高速化するベクトルプロセッサーが内蔵されています(例:ARMベースCPUのNEON)。Prism ISP相関ビデオトラッカーや電子ビデオ安定化など、Teledyne FLIR OEMのデジタル製品機能の一部はCPUコア上で動作します。現世代のSoCでは多数のCPUコアを利用できるため、開発者は性能と消費電力を最適化するうえで非常に高い柔軟性を得られます。CPUは、ピクセルごとに多数の数学演算を必要とするタスクには適していません。これは、CPUのスループットに制約があり、演算あたりの消費電力が比較的高くなるためです。
GPU
AIとコンピュテーショナルイメージング(CI)のワークロードは非常に大きく、大量の帯域幅と処理能力を必要とします。プロセッサーの設計者は、メモリー、セキュリティ、リアルタイムデータ接続を統合した強力なチップアーキテクチャを生み出してきました。従来のCPUは通常、このために必要とされる処理性能を備えていませんが、逐次タスクの実行には最適です。GPUは、AIの積和演算の並列処理に対応でき、AIアプリケーションに適用できます。実際、GPUはAIアクセラレーターとして機能し、ニューラルネットワークや同様のワークロードの性能を高めることができます。GPUは数千のコンピュートコアを搭載でき、多くの並列処理タスクに使用されます。GPUは、モデルのトレーニングに特に有用です。ただし、GPUは大量の電力を消費し、オンチップメモリー要件も高くなります。このため、最新のモバイルプロセッサーは、エッジで推論を実行するためにデジタル信号プロセッサー(DSP)を使用する専用AIコプロセッサーを採用しています。
DSP
DSPは、数学演算を実行するよう最適化された、電力効率に優れた専用SoCサブシステムです。ワイド命令ワードを使用することで、クロックサイクルあたりの処理量を最大化します。ただし、DSPはプログラミングがそれほど容易ではなく、最高の性能を引き出すには、DSPハードウェアの機能、プログラミング環境、DSPソフトウェアの最適化に精通している必要があります。Qualcomm Hexagon™ Tensor Processor(HTP)は、計算負荷の高いAIワークロードの実行に適したAIアクセラレーターです。性能を向上させ、HTP上でAIモデルを実行するには、モデルをサポートされている精度のいずれかに量子化する必要があります。INT4、INT8、INT16、またはFP16。
ISP
デジタル写真はモバイル端末業界における競争の最前線であるため、モバイルプロセッサーサプライヤーは、ノイズ低減、レンズ歪み補正、ホワイトバランス調整、自動露出、オートフォーカス、デモザイク、画像圧縮などの画像強調機能を実行するため、専用のシリコンIPブロックを組み込んでいます。システムレベルでは、特定の画像センサーとレンズに合わせてパラメーターや各種フィルターを最適化するため、一般にISPチューニングが必要になります。ISPのファインチューニングは、それ自体が1つの専門分野です。多くのSoCサプライヤーは、一般的な画像センサー向けのISPライブラリを提供しており、システム開発者にとって大幅な投資削減につながる可能性があります。
モバイルプロセッサーのサプライヤー自体がサーマルカメラ用ISPを設計・製造すべき理由はほとんどありません。とはいえ、画像信号処理を行う利点は大きいため、Teledyne FLIR OEMは、16ビットから8ビットへのトーンマッピング(自動ゲイン制御)、時空間ノイズ除去、超解像、乱流軽減、電子画像安定化などをはじめとする包括的なISP機能セットを開発しています。これらのアルゴリズムのほとんどは、処理負荷が大きいため、GPU上で実行されます。
メモリー
デジタルビデオストリームの高いデータレートに加え、データが複数のアルゴリズムによって繰り返し読み取られる可能性があることを考えると、効率的な信号処理には十分なメモリー容量とメモリー帯域幅が不可欠です。クロック速度の向上、メモリー帯域幅の拡大、専用AIアクセラレーション、ソフトウェア最適化の改善を組み合わせることで、Teledyne FLIR OEMの既存の最大AIモデル(入力解像度768x768ピクセル)は、Qualcomm QCS8550では6 ms、QRB5165では33 msで実行されます。これは推論速度が5倍以上向上したことを示しており、次世代の解像度SXGA(1280x1024)のカメラでフレームレートと同じ頻度の推論を実現するための十分な余裕をもたらします。
7. フレームワーク
AIフレームワークとは、インテリジェントシステムの構築、最適化、導入の方法を形作る基盤的な構成要素のことです。ライブラリと事前構築済みの関数を備えたこれらのフレームワークにより、開発者はすべての関数をゼロから設計しなくても、高度なAIアルゴリズムを作成できます。本番環境のエッジAIシステムでは、フレームワークに関して検討すべき内容は、モデルトレーニングにとどまらず、エクスポート形式、ランタイム最適化、量子化ツール、ハードウェア固有のコンパイラー、回帰テスト、OTAアップデート戦略、フリートレベルの性能モニタリングにまで広がっています。
PyTorchは、その柔軟性と使いやすい実行モデルにより、研究、実験、モデル開発で広く使用されています。PyTorchの動的計算グラフにより、開発者はモデルの挙動をその場で変更し、Pythonの制御フロー操作を使用できるため、複雑なモデルアーキテクチャ、迅速なプロトタイピング、反復的な実験に適しています。
TensorFlowは、本番環境やモバイル導入ワークフローにおいて引き続き重要です。このことは、TensorFlow LiteまたはLiteRTがすでに統合されている場合に特に当てはまります。しかし、最新の組み込み導入では、PyTorchかTensorFlowかという単純な選択になることはほとんどありません。一般的な本番環境向けの流れとしては、PyTorchまたはTensorFlowでトレーニングし、ONNXまたはその他のポータブルな表現形式にエクスポートし、グラフを最適化し、モデルを量子化し、TensorRT、ONNX Runtime、OpenVINO、LiteRT/TensorFlow Lite、Qualcomm AI Engine Directなどのランタイム向けにコンパイルしたうえで、ターゲットデバイス上でレイテンシー、精度、消費電力、熱挙動を検証します。このため、最適なフレームワークは、単にトレーニング時に最も便利なものではなく、選択したプロセッサーとアプリケーションに対応する導入パイプライン全体をサポートするものということになります。
8. ビデオ処理パイプライン
ビデオ処理パイプラインは、Teledyne FLIR OEMのアプローチの差別化が最も際立つ領域です。カメラ、ISP、検出器、トラッカー、組み込みプロセッサーを独立したコンポーネントとして扱うのではなく、このパイプラインは相互に接続されたシステムとして設計されています。各段階は次の段階に影響を与えます。ノイズ除去はターゲットのテクスチャを変化させ、コントラスト強調はモデルの入力分布を変化させ、安定化は時間的一貫性を高め、超解像は有効なディテールを向上させる可能性があり、追跡ではフレームごとの検出結果が持続的な情報に変換されます。こうした相互作用を最適化することは、信頼性の高いエッジ認識の実現に不可欠です。
Teledyne FLIR OEMでは、ローカルコントラスト強調(LCE)、空間・時間ノイズ低減、電子画像安定化、乱流軽減、超解像、複数のビデオ融合技術を含む、サーマル画像向け画像処理ソフトウェアライブラリ群であるPrism ISPを開発しました。これらの機能は、人による解釈に向けて画質を向上させると同時に、後段の検出・追跡アルゴリズムに提示される情報を形作ります。その目的は、映像の見え方を向上させると同時に、電力要件とコストを最小限に抑えながら、サーマル認識パイプライン全体の信頼性、効率、導入しやすさを高めることです。Teledyne FLIR OEMのサーマルカメラモジュールには、Prism ISPを実行するための統合プロセッサーは含まれていません。最新のモバイルプロセッサーおよび組み込みプロセッサーを利用できるようになったことで、実環境の電力・熱制約を満たしながら、有用なビデオフレームレートでISP、検出、追跡アルゴリズムを実行できる処理能力を備えたアクセサリー電子モジュールを追加することが現実的になりました。

図6 - Prismビデオ処理パイプライン
サーマルイメージングは、物体を可視化する目的で多くのユースケースで利用されています。検査や消防活動ではメートル単位の距離、情報・監視・偵察(ISR)では数キロメートルの距離、さらに空中、塔上、地上の視点から利用されます。距離、視点、昼夜や天候に基づく環境条件が組み合わさることで、実環境でのイメージング課題が生じますが、こうした課題はPrism ISPアルゴリズム機能によって軽減できます。
9. Prism ISPの機能
乱流軽減

図7 - 乱流軽減なし(左)とあり(右)の比較
大気乱流とは、速度、圧力、密度の変動を特徴とする、流体または空気の不規則で複雑な動きを指します。地表面などが太陽放射を受けて加熱されることで大気が混合されるため、大気乱流は光子の伝搬に影響を及ぼします。空気がかき乱され、水蒸気、煙、その他の物質によって赤外線信号の屈折が変化します。高度な技術により、時間方向の良好な画質を維持しながら歪みの影響を除去します。つまり、動いている物体が識別不能な塊や筋状の像に変化するのを防ぎます。これは、AIを使用して人や車両などのターゲットを検出する際に重要です。
AIによる検出と追跡において、乱流軽減とは単なる画質向上機能ではありません。歪み、揺らぎ、見かけ上の動きは、検出器の信頼度を低下させ、追跡を不安定にする可能性があります。推論と追跡の前に時間的一貫性を高めることで、このパイプラインは、より大きなモデルやより高い計算バジェットだけに依存することなく、信頼性の高いターゲット情報を提供できます。
乱流軽減アルゴリズムの主な目的は、信号品質を向上させ、ノイズを低減し、乱流条件下で明瞭性と安定性を回復することです。Prism ISPアルゴリズムは、乱流の影響を受けたデータを分析・処理するために、さまざまな数学的手法と信号処理手法を採用しています。
- データ取得:最初のステップは、乱流の影響を受けたデータを取得することです。このデータは画像フレームの形式で提示されます。
- 前処理:取得したデータは、乱流に直接関係しないノイズやアーティファクトを除去するために前処理されます。これには、信号品質を向上させるためのフィルタリング、ノイズ低減、キャリブレーション技術が含まれます。
- 乱流推定:データに含まれる乱流特性を推定することが不可欠です。これには、変動の統計的特性を分析し、乱流強度、相関長、時間スケールなどの関連パラメーターを特定することが含まれます。
- デコンボリューションまたは再構成:デコンボリューション技術は、乱流によって生じるぼやけの影響を補正しようとするものです。デコンボリューションアルゴリズムでは多くの場合、乱流の数学的モデルや経験的知識を利用して、元の信号を復元します。
- 適応フィルタリング:乱流条件は時間的・空間的に変化するため、乱流軽減アルゴリズムの多くには適応フィルタリング技術が採用されています。これらの手法では、推定された乱流パラメーターに基づいてフィルタリングパラメーターが動的に調整され、ノイズ低減と重要な信号特徴の保持とのトレードオフが最適化されます。
- 後処理:乱流軽減ステップの後、品質をさらに向上させ、最終出力のアーティファクトを低減するために、追加の後処理が行われる場合があります。こうした後処理には、具体的な用途に応じて、ノイズ除去やシャープニング、コントラスト強調、特徴抽出などの技術が含まれます。
超解像

図8 – 超解像なし(左)と超解像あり(右)の比較
マルチフレーム超解像は、1つ以上の低解像度画像から高解像度画像を再構成することを目的とした強力な技術です。システムの光学分解能は、システムの開口部によって決まる回折限界と、検出器のサンプリング分解能によって制限されます。小さな開口部と低解像度センサーを使用すると、システムを低コスト化・小型化できる一方で、エイリアシングが目立つエッジやぼやけたエッジを含む低品質な画像になります。これは、有限の開口サイズと組み合わさることで回折の影響が大きくなる長焦点距離の光学系を使用して、長距離ターゲットを撮影する場合に特に当てはまります。超解像では、高度なアルゴリズムを用いて、劣化した入力データから高解像度画像を再構成します。従来の手法は、主に低解像度画像に内在する空間相関を利用することに重点を置いていましたが、近年の進歩により、エイリアシングを活用する手法が優れた結果をもたらすことが示されています。
認識パイプラインでは、超解像は検出範囲、小ターゲットの分類、オペレーターの信頼度にも影響を与える可能性があります。シャープニングや再構成によるアーティファクトは、視覚的な解釈に役立つ場合がある一方で、AIモデルが受け取る入力分布を変化させる可能性もあるため、その効果はシステムレベルで評価する必要があります。これは、ISPと検出を個別の機能としてではなく、あわせてチューニングする必要があることを改めて示しています。
画像安定化

図9 - 電子画像安定化の代表的な用途
カメラは多くの場合、地上の車両、海洋上の船舶、航空機、ドローン、タワーなど、動きや揺れが生じるプラットフォームに取り付けられます。プラットフォームの動きは映像に直接伝わるため、視聴者の疲労や画質低下につながり、状況認識や証拠としての忠実性に影響を及ぼす可能性があります。電子画像安定化により、動きに起因する画像の歪みの大部分を除去できます。これは、長距離イメージングに使用される狭視野のズーム光学系で撮影する場合に特に有効です。
自動認識では、安定化によって時間的一貫性が向上し、誤った追跡の開始、検出漏れ、オペレーターの疲労を低減できる可能性があります。また、検出と追跡が実行される前に、プラットフォームに起因する画像の動きが低減されるため、後段のアルゴリズムが動きの手がかりをより効果的に利用しやすくなります。
MSX - マルチスペクトル動画像解析

図10 - FLIR MSXがサーマル画像上の可視エッジをリアルタイムで強調
サーマル画像と可視画像を1つの融合ビデオストリームに統合する画像融合には、さまざまなアプローチがあります。その目的は、後段の人間のオペレーターやシステムが分析するために2つ以上のストリームを送信する必要をなくしながら、各スペクトルに固有の有用な情報を引き出すことです。ただし実際には、この処理は、2つ以上のチャネルで完全な画像位置合わせ(アライメント)が必要になることや、各センサーの積分時間が異なることに起因する問題があるため、複雑になる場合があります。
Teledyne FLIR OEMは、MSX(マルチスペクトル動画像解析)と呼ばれる独自の技術の特許を取得しています。画像ブレンディング(可視光画像とサーマル画像の混合)と異なり、MSXでサーマル画像のディテールが損なわれたり、サーマル画像の透過性が低下したりすることはありません。その代わりに、高周波フィルターを適用して、輪郭、文字、数字、その他の高コントラストなエッジディテールを含む記号類など、鮮明な可視情報を抽出し、それらをサーマル画像に重ね合わせます。これにより画像の輪郭が明瞭になり、予知保全、セキュリティ、空中ISRアプリケーションなどの分野で有用な技術であることが実証されています。
AGC – 自動ゲイン制御

図11 - ローカルコントラスト強調(Boson® 640ソースビデオ)
画像において、コントラストとは、最も明るい領域と最も暗い領域の輝度差を指します。コントラストは、画像全体の視覚的な印象を決めるうえで重要な役割を果たします。ローカルコントラストストレッチングとも呼ばれるローカルコントラスト強調は、画像全体のコントラストを一律に変更するのではなく、画像内の特定領域でコントラストのダイナミックレンジを拡大するという原理に基づいて機能します。
ローカルコントラスト強調は、細かなディテールを引き出し、テクスチャを高め、特徴を強調します。生の16ビットモノクロセンサーデータを、ディスプレイに表示される8ビットの色深度に変換するには、広範なピクセル値の分布を、カラーまたはグレーの256階調のいずれかにマッピングするアルゴリズムが必要です。画像内のピクセル値の分布が線形になることはまれであるため、コントラストの最大化は非常に複雑で、シナリオごとに動的に変化します。画像全体のコントラストを均一に調整するグローバルコントラスト強調とは異なり、ローカルコントラスト強調は、局所的なディテールと微細なテクスチャを保持することに重点を置いています。画像内のより小さな領域を対象とし、隣接する領域間の相対的なコントラスト関係を維持しながら、その領域内のコントラストを高めます。
AIパイプラインでは、トーンマッピングとローカルコントラスト強調は、検出器への数値入力を形作るため、慎重に管理する必要があります。視覚的に見やすい処理設定が、必ずしもモデルの信頼度を最大化し、誤報を減らし、小ターゲットのディテールを保持するとは限りません。Teledyne FLIR OEMのパイプラインレベルのアプローチなら、これらの画像処理上の選択を、利用可能なSWaPエンベロープ内で、信頼性の高い検出、追跡、意思決定支援という最終的なシステム目標に照らして評価できます。
10. まとめ
ディープラーニング、組み込みプロセッサー、本番AI導入ツールは目覚ましい進歩を遂げてきました。サーマルシステムやマルチスペクトルシステムにとって、こうした進歩は重要ですが、それだけでは十分ではありません。市場では、AIをエッジで実行できるかどうかという段階を超えつつあります。より重要性を増しているのは、厳しいSWaP、レイテンシー、帯域幅、熱制約を満たしながら、現場で信頼性が高く実用的な情報を提供できるよう、認識パイプライン全体を設計できるかどうかです。
Teledyne FLIR OEM’の優位性は、単に組み込みプロセッサー上でAIを実行することにとどまりません。その優位性は、センサーデータ、画像信号処理、モデル設計、量子化、ランタイム導入、追跡、メモリー使用量、電力管理、環境堅牢性からなるサーマル認識パイプライン全体を、統合システムとして最適化できる点にあります。防衛、自律システム、ロボティクス、産業オートメーション、セキュリティ、オートモーティブシステムにわたる実用アプリケーションでは、目を引くTOPS値や汎用モデルの選択だけでなく、このフルスタック統合が差別化要因になります。
したがって、次世代のインテリジェントサーマルカメラは、センシングの物理特性、コンピュテーショナルイメージング、組み込みAI、導入エンジニアリングをどれだけ適切に統合できるかによって決まります。Teledyne FLIR OEMは、サーマルセンサーに関する専門知識、Prism ISP、アプリケーション固有の検出・追跡ライブラリ、最新のヘテロジニアスプロセッサー上でソフトウェアを最適化してきた経験を組み合わせることで、お客様がエッジAIのデモから、実環境で動作する導入済み認識システムへ移行できるよう支援します。
[i] https://patentimages.storage.googleapis.com/f5/e3/05/021253fa9a6921/US20220019843A1.pdf
[ii] https://patents.google.com/patent/US20220019843A1/en?oq=17%2f374909
[iii] A Review of Artificial Intelligence in Embedded Systems https://doi.org/10.3390/mi14050897