
Uso de datos sintéticos para acelerar el desarrollo de modelos de percepción de IA para la detección de objetos
DESCARGAR VERSIÓN EN PDF
Introducción
El concepto de operaciones (CONOPS) para plataformas aéreas y sistemas autónomos está evolucionando rápidamente. La interferencia de radiofrecuencia (RF) ahora puede interrumpir las comunicaciones y la navegación por el sistema satelital de navegación global (GNSS), lo que aumenta la necesidad de detección y seguimiento de objetivos multiclase, autonomía integrada, reconocimiento automático de objetivos basado en el borde y orientación de terminales que pueden funcionar en entornos disputados. Para OEM e integradores de sistemas, este cambio está impulsando la demanda de productos de percepción digital que detecten, clasifiquen y rastreen objetos relevantes para la misión en el borde utilizando cámaras electroópticas (EO) e infrarrojas (IR).
Los detectores de objetos generalizados pueden ser suficientes para muchas aplicaciones de conciencia situacional, pero muchas aplicaciones de defensa requieren una clasificación detallada de objetivos, comportamientos y puntos de mira. Las soluciones de percepción de IA adoptan una ontología similar a la percepción humana tras tres niveles de percepción: detección, reconocimiento e identificación. Cada nivel tiene un umbral de píxel en el objetivo, y a menudo es muy difícil recopilar datos de campo que cubran todos los píxeles en los requisitos del objetivo para entrenar un modelo de alto rendimiento. El factor limitante son los datos, ya que los datos de imágenes suelen estar aislados en organizaciones militares, agencias gubernamentales, instituciones de investigación y contratistas de defensa, cada uno con diferentes políticas de acceso y comercialización. Al mismo tiempo, las clases de objetivos continúan expandiéndose y las condiciones del mundo real como camuflaje, suplantación, modalidad del sensor, geometría de visualización y entorno deben representarse en los datos de entrenamiento. Cumplir estos requisitos exige la generación de datos y la formación de modelos en días en lugar de semanas o meses. El OEM de Teledyne FLIR desarrolló AIMMGen™ para abordar este desafío como una capacidad de generación de datos sintéticos y formación de modelos de IA que respalda la cartera más amplia de productos digitales Prism™.
Principales conclusiones
- AIMMGen acelera el desarrollo de modelos de objetos generando grandes volúmenes de datos sintéticos etiquetados de EO, IR y multiespectrales para escenarios ricos en objetivos.
- La cadena de herramientas reduce la dependencia de conjuntos de datos escasos, costosos o restringidos del mundo real, a la vez que preserva la capacidad de aumentar los datos medidos cuando están disponibles.
- La gestión automatizada de metadatos, la selección de conjuntos de datos y la optimización de modelos admiten el desarrollo repetible y rastreable de modelos de percepción específicos de la misión.
- Como parte del ecosistema de productos digitales Prism, AIMMGen ayuda a convertir datos sintéticos y flujos de trabajo de formación en capacidades de percepción digital implementables para plataformas OEM.
- Los resultados de ejemplo muestran una mejora medible del rendimiento en la detección de aire a tierra y demuestran un entrenamiento de modelos solo sintéticos para la clasificación marítima MWIR de grano fino.
Por qué importan los datos sintéticos ahora
El valor estratégico de los datos sintéticos para la formación de modelos ya no se limita a cubrir las carencias de datos de formación. Se está convirtiendo en una forma práctica de acelerar la detección definida por software y las capacidades de percepción de IA adaptables sobre el terreno. A medida que evolucionan los requisitos de la misión, los clientes necesitan modelos que puedan ampliarse a nuevas clases de objetivos, validarse en todas las modalidades de sensores e implementarse en procesadores integrados sin reiniciar campañas de recopilación de datos y etiquetado de meses de duración.
Para OEM de Teledyne FLIR, AIMMGen es la base de generación de modelos detrás de esta estrategia de productos digitales. Ayuda a convertir imágenes dispersas, costosas o difíciles de recopilar en modelos de IA validados que admiten aplicaciones Prism para la detección, el seguimiento, el reconocimiento de objetivos y la percepción específica de la misión.
Generación de datos sintéticos y modelos de IA
Los desarrolladores de mercados como la conducción autónoma suelen tener acceso a grandes bibliotecas de formación. Por el contrario, las organizaciones que desarrollan sistemas de detección militares y específicos para misiones a menudo tienen acceso limitado a datos representativos de objetivos. Los datos reales siguen siendo importantes para los clasificadores de precisión, pero los datos sintéticos ofrecen una forma práctica de aumentar los conjuntos de datos medidos o desarrollar clasificadores detallados cuando los datos medidos no están disponibles, están restringidos o son prohibitivamente costosos de recopilar.
AIMMGen (modelado de IA y generación de modelos) de Teledyne FLIR OEM combina la generación automatizada de datos a gran escala, la recuperación inteligente de datos y la optimización de modelos de IA en una sola canalización para desarrolladores de algoritmos de reconocimiento automático de objetivos (ATR) e integradores de OEM. Dentro del ecosistema de productos digitales Prism, AIMMGen funciona como una fábrica de modelos: ayuda a crear, entrenar, probar y entregar modelos de percepción de IA para aplicaciones de software listas para la misión y módulos de percepción integrados. La cadena de herramientas genera rápidamente datos sintéticos para escenarios del mundo real, incluidos tipos de objetos objetivo, posiciones, orientaciones, modalidades de sensores, configuraciones, trayectorias y estados ambientales. Puede producir millones de imágenes etiquetadas en días, en lugar de las semanas o meses que normalmente se requieren para la recopilación de datos de campo y el etiquetado manual.
AIMMGen genera automáticamente etiquetas para cada imagen y almacena metadatos de recopilación con el conjunto de imágenes. Para respaldar la formación, la validación y la implementación repetible en todos los casos de uso, los metadatos de cada imagen y objetivo se almacenan en un lago de datos para una rápida curación y construcción de conjuntos de datos. Estos metadatos incluyen parámetros de recopilación, información de destino y parámetros de imagen. El marco de formación extensible e independiente del modelo de AIMMGen permite la formación y optimización a escala de nube en una gama de casos de uso y tareas. Este flujo de trabajo rastreable ayuda a los clientes a comprender no solo cómo funciona un modelo, sino también qué datos, condiciones y supuestos dieron forma a su desarrollo.
De datos sintéticos a percepción digital desplegable
El flujo de trabajo AIMMGen es más valioso cuando se ve como parte de una canalización de percepción digital de extremo a extremo. La generación de datos sintéticos crea imágenes etiquetadas a escala. La selección del conjunto de datos y la gestión de metadatos hacen que los datos sean buscables y reutilizables. La formación y optimización automatizadas convierten los datos seleccionados en modelos. Las pruebas de validación y rendimiento proporcionan pruebas de que el modelo puede admitir una aplicación sobre el terreno. En el ecosistema Prism, estas salidas pueden admitir productos y módulos de software que realizan detección, seguimiento, clasificación, imágenes computacionales y reconocimiento de objetivos en el borde.
Para los clientes OEM, el desafío rara vez es la formación de modelos por sí sola. El objetivo más grande es reducir el riesgo de desarrollo, acortar el tiempo de capacidad y adaptar el software de percepción a medida que cambian los objetivos, los sensores, las plataformas de implementación y los requisitos de la misión.
Paso 1: Proceso de generación de datos sintéticos AIMMGen
La primera etapa del proceso AIMMGen es la generación de datos, que comienza con especificaciones para tipos de ubicación, resolución del sensor, tipos de objetos objetivo, condiciones de imagen, configuraciones del sensor y el número deseado de imágenes. Las combinaciones aleatorizadas de estas especificaciones se crean hasta que el número total de imágenes alcanza o supera el número deseado. La canalización de generación de datos utiliza un motor de simulación geoespecífico que incluye un terreno preciso para el mundo, establece las condiciones ambientales, inserta objetivos muestreados de más de 20 000 modelos únicos y comienza a recopilar datos. La verdad de tierra se genera automáticamente como metadatos y se almacena junto con los metadatos de destino.
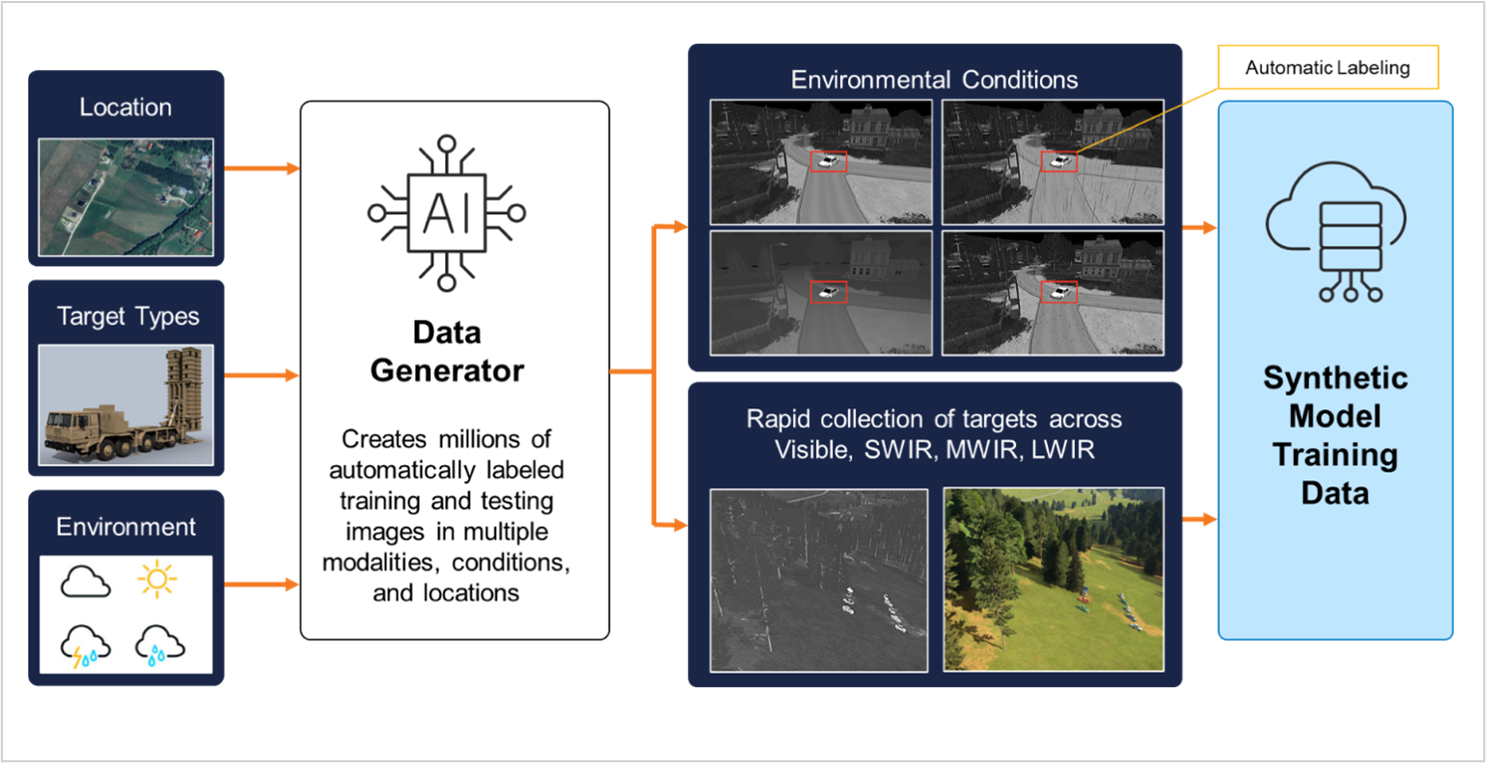
Figura 1. Los datos de entrenamiento sintéticos se generan en minutos y a bajo coste
Los metadatos de imagen, incluido el URI final de cada ubicación de imagen y los metadatos de destino asociados, se capturan y almacenan en una base de datos de Elasticsearch. Estos metadatos se almacenan en índices separados y se vinculan a través de identificadores únicos, lo que permite a los usuarios visualizar, filtrar y buscar en subconjuntos de datos. Después de la generación, los datos se pueden seleccionar a través de herramientas de visualización para admitir el diseño de experimentos y el desarrollo de conjuntos de datos.
Paso 2: Formación y optimización de modelos AIMMGen
La segunda fase es la formación y optimización automatizadas de modelos. Los usuarios especifican conjuntos de datos, características de rendimiento de modelo deseadas y métricas de optimización. AIMMGen organiza un grupo de nodos de entrenamiento de IA para entrenar, evaluar y producir modelos optimizados contra métricas de referencia y definidas por el usuario. Debido a que el marco de formación es independiente del modelo, los usuarios pueden crear canalizaciones de datos personalizadas y arquitecturas de modelos dentro de AIMMGen. Los modelos de salida se rastrean y almacenan en una base de datos para respaldar la trazabilidad, la reproducibilidad y el refinamiento futuro a medida que evolucionan las misiones de los clientes o los conjuntos de objetivos.
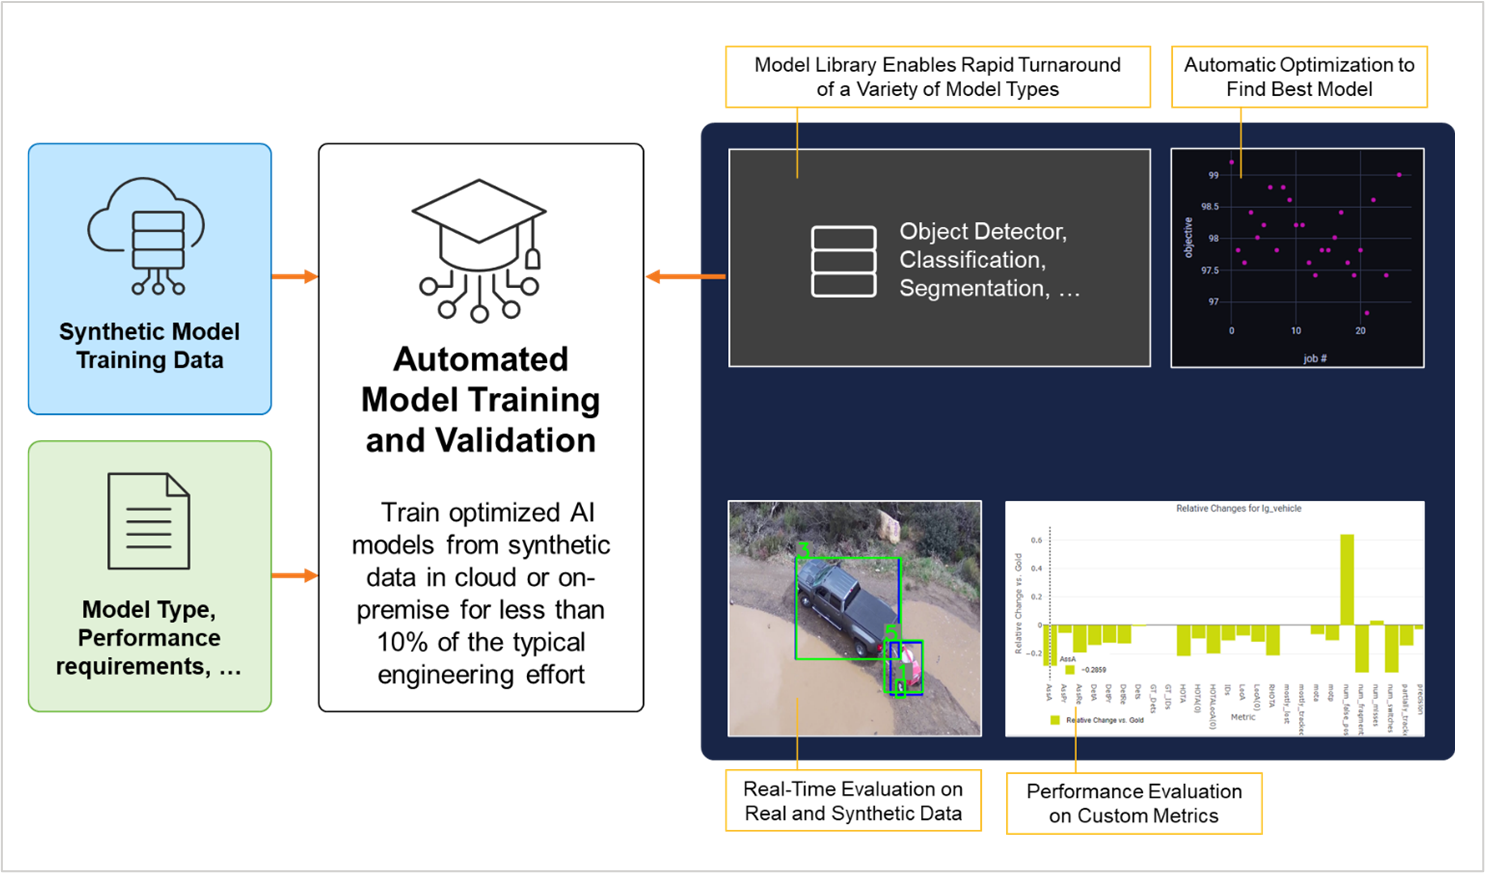
Figura 2. Formación y optimización automáticas
Métricas de rendimiento de referencia para la optimización del modelo de percepción de IA
En el desarrollo de modelos de percepción de IA, la precisión, el modo seguro y F1-score son métricas clave para evaluar lo bien que un modelo identifica y clasifica objetos o instancias.
La precisión mide la precisión de las predicciones positivas realizadas por el modelo. Es importante cuando el coste de los falsos positivos es alto. En aplicaciones militares, identificar erróneamente una amenaza como amenaza podría conducir a acciones innecesarias.
Precisión = Positivos verdaderos/(Positivos verdaderos + Positivos falsos)
Recall, también conocido como sensibilidad o tasa de verdaderos positivos, mide la capacidad del modelo para identificar todas las instancias relevantes. Esto es fundamental cuando faltar a una instancia positiva tiene graves consecuencias, como el peligro de no detectar una amenaza real.
Recuerdo = Positivos verdaderos/(Positivos verdaderos + Falsos negativos)
F1-Score proporciona una visión equilibrada del rendimiento del modelo, lo que garantiza que se tengan en cuenta tanto la precisión como el modo seguro. Esta es una buena medida del rendimiento general del modelo al tratar con conjuntos de datos desequilibrados y es esencial para desarrollar sistemas de percepción sólidos.
F1 - Puntuación = 2 x (Precisión * Recuerdo)/(Precisión + Recuerdo)
Aplicaciones y resultados de ejemplo AIMMGen
AIMMGen se ha validado en múltiples dominios de aplicaciones y sensores, incluida la detección de aire a tierra y la clasificación marítima de grano fino.
En un experimento de detección de aire a tierra, el OEM de Teledyne FLIR añadió datos electroópticos (EO) sintéticos e infrarrojos de onda larga (LWIR) a un conjunto de datos de formación de detección de objetos que ya incluía datos medidos de EO e IR. Con solo cambios limitados en el esquema de formación, los modelos entrenados en AIMMGen lograron una mejora medible en el modo seguro. Esto importa operativamente porque las detecciones perdidas pueden ser más consecuentes que los falsos positivos adicionales en muchos flujos de trabajo de vigilancia, orientación y protección contra fuerzas. La mejora se refleja en el aumento general en la F1-score.
Tabla 1. Modelos AIMMGen comparados con modelos entrenados solo reales
|
|
Modelos AIMMGen |
Modelo solo real existente |
| Precisión |
0,71 ± 0,01 |
0,71 |
|
Modo seguro |
0,52 ± 0,01 |
0,48 |
|
F1-Score |
0,60 ± 0,01 |
0,57 |
AIMMGen también puede admitir la generación de modelos de IA con pocos o ningún dato de entrenamiento real, como se demuestra en un ejemplo marítimo de infrarrojos de onda media (MWIR). La identificación de objetos marítimos de grano fino suele requerir costosos conjuntos de datos MWIR con etiquetas detalladas tipo embarcación. Con datos reales limitados, los modelos solo pueden distinguir entre categorías amplias como “vaso pequeño” y “vaso grande”. Sin embargo, con AIMMGen, un modelo se entrenó exclusivamente en datos sintéticos y fue capaz de clasificar subtipos de vasos específicos. El rendimiento se validó en múltiples colecciones del mundo real, incluidos entornos de agua dulce y litorales, lo que demuestra la robustez de la formación solo sintética y el potencial de ampliar las clases de objetivos cuando las imágenes reales son escasas o difíciles de recopilar.
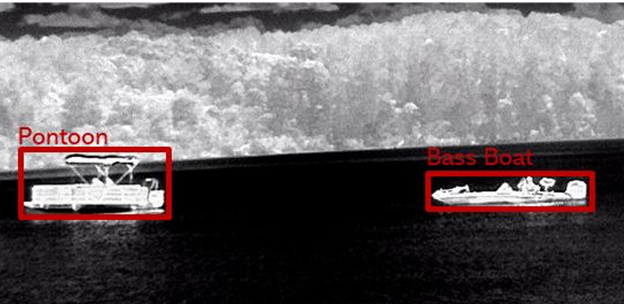
Figura 3: Identificación de grano fino en MWIR de embarcaciones marítimas utilizando modelos de IA con formación en datos sintéticos
Resumen
Crear conjuntos de datos de formación grandes y diversos para aplicaciones de EO, IR y multiespectrales sigue siendo una barrera importante para implementar sistemas de percepción de IA sólidos. AIMMGen aborda esta barrera con imágenes sintéticas, gestión automatizada de metadatos, selección de conjuntos de datos y optimización de modelos. Como parte de la estrategia más amplia de productos digitales Prism de Teledyne FLIR OEM, AIMMGen es más que una cadena de herramientas de generación de datos. Proporciona una base de generación de modelos para desarrollar, validar y ampliar las capacidades de percepción de IA específicas de la misión en defensa, autonomía, servicios de emergencia y otras aplicaciones OEM.
Para obtener más información sobre la familia de software Prism y los productos digitales OEM de Teledyne FLIR, consulte oem.flir.com/prism.
Artículos relacionados
-
 Artículo
Los avances en los sistemas de adquisición de imágenes MWIR estándar pueden reducir el tiempo de desarrollo en dos años
Más información -
 Artículo
Comparing Sensitivity of Thermal Imaging Camera Modules
Más información -
 Documento técnico
Beyond Embedded AI: Optimizing the Thermal Perception Pipeline from Sensor Data to Edge Deployment
Más información