
Verwendung synthetischer Daten zur Beschleunigung der Entwicklung von KI-Wahrnehmungsmodellen für die Objekterkennung
PDF-VERSION HERUNTERLADEN
Einführung
Das Betriebskonzept (CONOPS) für Luftplattformen und autonome Systeme entwickelt sich rasant weiter. Hochfrequenz (RF)-Störungen können nun die Kommunikation und die Navigation des globalen Navigationssatellitensystems (GNSS) stören, was die Notwendigkeit für mehrstufige Zielerkennung und -verfolgung, Onboard-Autonomie, randbasierte automatische Zielerkennung und Terminalführung erhöht, die in umkämpften Umgebungen betrieben werden können. Für OEMs und Systemintegratoren treibt diese Verschiebung die Nachfrage nach digitalen Wahrnehmungsprodukten an, die einsatzrelevante Objekte am Rand mithilfe von elektrooptischen (EO) und Infrarot (IR) Kameras erkennen, klassifizieren und verfolgen.
Generalisierte Objektdetektoren können für viele Situationserkennungsanwendungen ausreichend sein, aber viele Verteidigungsanwendungen erfordern eine feinkörnige Klassifizierung von Zielen, Verhaltensweisen und Zielpunkten. KI-Wahrnehmungslösungen übernehmen eine ähnliche Ontologie wie die menschliche Wahrnehmung nach drei Wahrnehmungsebenen: Erkennung, Erkennung und Identifizierung. Jede Ebene hat ein Pixel auf dem Zielschwellenwert, und es ist oft sehr schwierig, Felddaten zu sammeln, die alle Pixel auf den Zielanforderungen abdecken, um ein Hochleistungsmodell zu trainieren. Der einschränkende Faktor sind Daten, da Bilddaten oft über Militärorganisationen, Regierungsbehörden, Forschungseinrichtungen und Verteidigungsunternehmen hinweg isoliert sind, jeweils mit unterschiedlichen Zugriffs- und Vermarktungsrichtlinien. Gleichzeitig dehnen sich die Zielklassen weiter aus und reale Bedingungen wie Camouflage, Spoofing, Sensormodalität, Betrachtungsgeometrie und Umgebung müssen in Trainingsdaten dargestellt werden. Um diese Anforderungen zu erfüllen, sind Datengenerierung und Modellschulungen in Tagen statt Wochen oder Monaten erforderlich. Teledyne FLIR OEM hat AIMMGen™ entwickelt, um diese Herausforderung als synthetische Datengenerierung und KI-Modelltrainingsfunktion zu bewältigen, die das breitere digitale Produktportfolio von Prism™ unterstützt.
Wichtigste Erkenntnisse
- AIMMGen beschleunigt die Entwicklung von Objektmodellen, indem es große Mengen an markierten synthetischen EO-, IR- und multispektralen Daten für zielreiche Szenarien generiert.
- Die Toolchain reduziert die Abhängigkeit von knappen, kostspieligen oder eingeschränkten realen Datensätzen und bewahrt gleichzeitig die Möglichkeit, gemessene Daten zu erweitern, wenn sie verfügbar sind.
- Automatisiertes Metadatenmanagement, Datensatzkuratierung und Modelloptimierung unterstützen die wiederholbare, rückverfolgbare Entwicklung von missionsspezifischen Wahrnehmungsmodellen.
- Als Teil des Ökosystems digitaler Produkte von Prism hilft AIMMGen bei der Umwandlung synthetischer Daten und Trainingsworkflows in einsetzbare digitale Wahrnehmungsfunktionen für OEM-Plattformen.
- Beispielhafte Ergebnisse zeigen messbare Leistungsverbesserungen bei der Luft-Boden-Erkennung und demonstrieren ein Modelltraining nur mit synthetischer Technologie für die maritime Klassifizierung von feinkörnigen MWIR.
Warum synthetische Daten jetzt wichtig sind
Der strategische Wert synthetischer Daten für das Modelltraining ist nicht mehr auf das Füllen von Lücken in den Schulungsdaten beschränkt. Es entwickelt sich zu einer praktischen Möglichkeit, softwaredefinierte Erfassungs- und feldanpassungsfähige KI-Wahrnehmungsfunktionen zu beschleunigen. Da sich die Missionsanforderungen weiterentwickeln, benötigen Kunden Modelle, die auf neue Zielklassen erweitert, über Sensormodalitäten validiert und auf eingebetteten Prozessoren bereitgestellt werden können, ohne monatelange Datenerfassungs- und Etikettierungskampagnen neu zu starten.
Für Teledyne FLIR OEM ist AIMMGen die Grundlage der Modellgeneration hinter dieser Strategie für digitale Produkte. Die Lösung hilft, spärliche, kostspielige oder schwer zu erfassende Bilder in validierte KI-Modelle umzuwandeln, die Prism-Anwendungen für Erkennung, Verfolgung, Zielerkennung und missionsspezifische Wahrnehmung unterstützen.
Synthetische Daten und KI-Modellgenerierung
Entwickler in Märkten wie autonomem Fahren haben oft Zugang zu großen Schulungsbibliotheken. Im Gegensatz dazu haben Organisationen, die militärische und missionsspezifische Erfassungssysteme entwickeln, häufig begrenzten Zugriff auf repräsentative Zieldaten. Echte Daten bleiben für Präzisionsklassifikatoren wichtig, aber synthetische Daten bieten eine praktische Möglichkeit, gemessene Datensätze zu erweitern oder feinkörnige Klassifikatoren zu entwickeln, wenn gemessene Daten nicht verfügbar, eingeschränkt oder unerschwinglich teuer zu erfassen sind.
AIMMGen (AI Modeling and Model Generation) von Teledyne FLIR OEM kombiniert umfangreiche automatisierte Datengenerierung, intelligente Datenabrufe und KI-Modelloptimierung in einer einzigen Pipeline für ATR-Algorithmusentwickler (Automatic Target Recognition) und OEM-Integratoren. Innerhalb des Ökosystems digitaler Produkte von Prism fungiert AIMMGen als Modellfabrik: Es hilft bei der Erstellung, Schulung, Prüfung und Bereitstellung von KI-Wahrnehmungsmodellen für missionsfertige Softwareanwendungen und eingebettete Wahrnehmungsmodule. Die Toolchain generiert schnell synthetische Daten für reale Szenarien, einschließlich Zielobjekttypen, Positionen, Ausrichtungen, Sensormodalitäten, Konfigurationen, Trajektorien und Umgebungszustände. Es kann Millionen von beschrifteten Bildern in Tagen produzieren, anstatt in den Wochen oder Monaten, die normalerweise für die Erfassung von Felddaten und die manuelle Beschriftung erforderlich sind.
AIMMGen generiert automatisch Beschriftungen für jedes Bild und speichert Sammlungsmetadaten mit dem Bildsatz. Zur Unterstützung von Schulungen, Validierungen und wiederholbarer Bereitstellung über Anwendungsfälle hinweg werden Metadaten für jedes Bild und Ziel in einem Data Lake gespeichert, um eine schnelle Kuration und Datensatzerstellung zu ermöglichen. Diese Metadaten umfassen Erfassungsparameter, Zielinformationen und Bildparameter. Das erweiterbare, modellunabhängige Trainings-Framework von AIMMGen ermöglicht dann das Cloud-Scale-Training und die Optimierung für eine Reihe von Anwendungsfällen und Aufgaben. Dieser nachvollziehbare Workflow hilft Kunden nicht nur zu verstehen, wie ein Modell funktioniert, sondern auch, welche Daten, Bedingungen und Annahmen seine Entwicklung geprägt haben.
Von synthetischen Daten bis hin zur einsatzfähigen digitalen Wahrnehmung
Der AIMMGen-Workflow ist am wertvollsten, wenn er als Teil einer End-to-End-Pipeline für digitale Wahrnehmung betrachtet wird. Synthetische Datengenerierung erzeugt etikettierte Bilder in großem Maßstab. Die Datensatzkuratierung und das Metadatenmanagement machen die Daten durchsuchbar und wiederverwendbar. Automatisiertes Training und Optimierung wandeln kuratierte Daten in Modelle um. Validierung und Leistungstests liefern den Nachweis, dass das Modell eine Anwendung vor Ort unterstützen kann. Im Prism-Ökosystem können diese Ausgaben Softwareprodukte und -module unterstützen, die Erkennung, Verfolgung, Klassifizierung, computergestützte Bildgebung und Zielerkennung am Rand durchführen.
Für OEM-Kunden besteht die Herausforderung nur selten darin, Schulungen zu modellieren. Das größere Ziel besteht darin, das Entwicklungsrisiko zu reduzieren, die Zeit bis zur Fähigkeit zu verkürzen und die Wahrnehmungssoftware anzupassen, wenn sich Ziele, Sensoren, Bereitstellungsplattformen und Missionsanforderungen ändern.
Schritt 1: AIMMGen Synthetischer Datengenerierungsprozess
Die erste Stufe des AIMMGen-Prozesses ist die Datengenerierung, die mit den Spezifikationen für Standorttypen, Sensorauflösung, Zielobjekttypen, Bildgebungsbedingungen, Sensorkonfigurationen und die gewünschte Anzahl von Bildern beginnt. Randomisierte Kombinationen dieser Spezifikationen werden erstellt, bis die Gesamtzahl der Bilder die gewünschte Anzahl erreicht oder überschreitet. Die Datengenerierungspipeline nutzt eine geospezifische Simulationsmaschine, die genaues Gelände für den Globus beinhaltet, die Umgebungsbedingungen festlegt, Ziele einfügt, die aus über 20.000 einzigartigen Modellen abgetastet wurden, und mit der Datenerfassung beginnt. Ground Truth wird automatisch als Metadaten generiert und neben Zielmetadaten gespeichert.
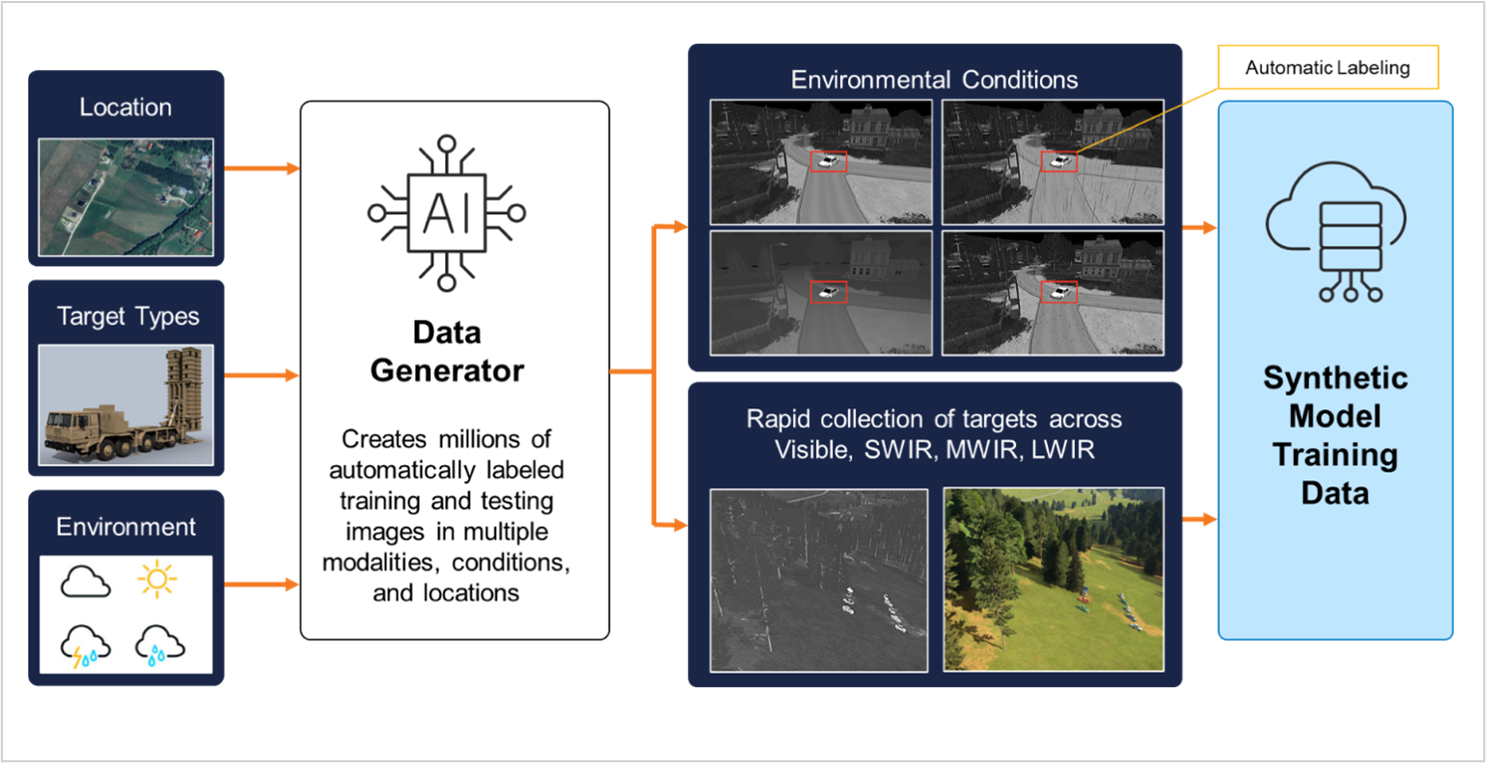
Abbildung 1. Synthetische Trainingsdaten werden in Minuten und zu niedrigen Kosten generiert
Bildmetadaten, einschließlich der endgültigen URI jedes Bildstandorts und der zugehörigen Zielmetadaten, werden in einer Datenbank von Elasticsearch erfasst und gespeichert. Diese Metadaten werden in separaten Indizes gespeichert und über eindeutige Kennungen verknüpft, sodass Nutzer Datenuntergruppen visualisieren, filtern und durchsuchen können. Nach der Generierung können die Daten über Visualisierungstools kuratiert werden, um das Experimentdesign und die Datensatzentwicklung zu unterstützen.
Schritt 2: AIMMGen-Modellschulung und -optimierung
Die zweite Stufe ist das automatisierte Modelltraining und die Optimierung. Nutzer geben Datensätze, gewünschte Modellleistungsmerkmale und Optimierungsmetriken an. AIMMGen orchestriert einen Cluster von KI-Trainingsknoten, um Modelle zu trainieren, zu bewerten und zu produzieren, die gegen Baseline- und benutzerdefinierte Metriken optimiert sind. Da das Trainings-Framework modellagnostisch ist, können Nutzer benutzerdefinierte Datenpipelines und Modellarchitekturen innerhalb von AIMMGen erstellen. Ausgabemodelle werden verfolgt und in einer Datenbank gespeichert, um Rückverfolgbarkeit, Reproduzierbarkeit und zukünftige Verfeinerung zu unterstützen, wenn sich Kundenmissionen oder Zielgruppen weiterentwickeln.
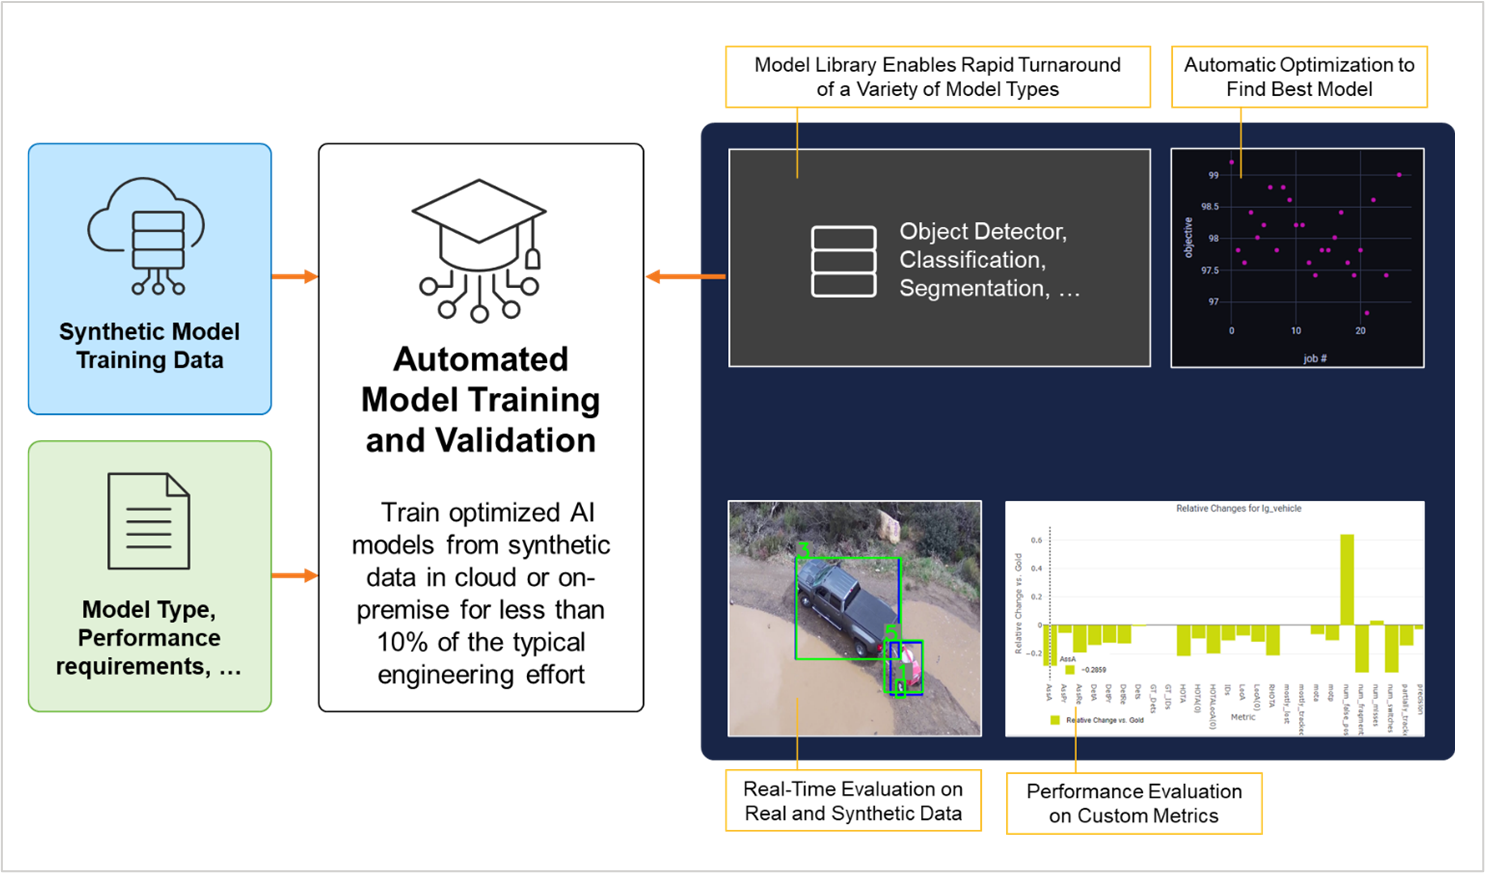
Abbildung 2. Automatische Schulung und Optimierung
Baseline-Leistungsmetriken für die Optimierung des KI-Wahrnehmungsmodells
Bei der Entwicklung von KI-Wahrnehmungsmodellen sind Präzision, Rückruf und F1-score wichtige Metriken, um zu bewerten, wie gut ein Modell Objekte oder Instanzen identifiziert und klassifiziert.
Präzision misst die Genauigkeit der positiven Vorhersagen des Modells. Es ist wichtig, wenn die Kosten für falsch positive Ergebnisse hoch sind. Bei militärischen Anwendungen könnte die falsche Identifizierung einer Nichtbedrohung als Bedrohung zu unnötigen Handlungen führen.
Präzision = Richtig Positive/(Richtig Positive + Falsch Positive)
Recall, auch bekannt als Empfindlichkeit oder wahre positive Rate, misst die Fähigkeit des Modells, alle relevanten Instanzen zu identifizieren. Dies ist entscheidend, wenn das Verpassen eines positiven Vorfalls schwerwiegende Folgen hat, wie z. B. die Gefahr, eine tatsächliche Bedrohung nicht zu erkennen.
Erinnerung = Richtig Positive/(Richtig Positive + Falsch Negative)
Der F1-Score bietet eine ausgewogene Sicht auf die Leistung des Modells und stellt sicher, dass sowohl Präzision als auch Rückruf berücksichtigt werden. Dies ist ein gutes Maß für die Gesamtleistung des Modells im Umgang mit unausgewogenen Datensätzen und ist für die Entwicklung robuster Wahrnehmungssysteme unerlässlich.
F1 - Punktzahl = 2 x (Präzision * Rückruf)/(Präzision + Rückruf)
AIMMGen Beispielanwendungen und Ergebnisse
AIMMGen wurde für mehrere Anwendungs- und Sensorbereiche validiert, einschließlich Luft-Boden-Erkennung und feinkörniger maritimer Klassifizierung.
In einem Luft-Boden-Erkennungsexperiment fügte Teledyne FLIR OEM einem Objekterkennungstrainingsdatensatz synthetische elektrooptische (EO) und Langwelleninfrarot (LWIR)-Daten hinzu, die bereits gemessene EO- und IR-Daten enthielten. Mit nur begrenzten Änderungen am Trainingsschema erreichten die AIMMGen-geschulten Modelle eine messbare Verbesserung im Recall. Dies ist betriebsnotwendig, da verpasste Erkennungen in vielen Überwachungs-, Targeting- und Force-Protection-Workflows mehr als zusätzliche falsch positive Ergebnisse zur Folge haben können. Die Verbesserung spiegelt sich im Gesamtanstieg des F1-score wider.
Tabelle 1. AIMMGen-Modelle im Vergleich zu rein trainierten Modellen
|
|
AIMMGen-Modelle |
Vorhandenes Nur-Echt-Modell |
| Präzision |
0,71 ± 0,01 |
0,71 |
|
Ausfallsicherheit |
0,52 ± 0,01 |
0,48 |
|
F1-Score |
0,60 ± 0,01 |
0,57 |
AIMMGen kann auch die KI-Modellgenerierung mit wenigen bis keinen realen Trainingsdaten unterstützen, wie in einem maritimen Beispiel für Midwave-Infrarot (MWIR) gezeigt. Die feinkörnige Identifizierung maritimer Objekte erfordert in der Regel kostspielige MWIR-Datensätze mit detaillierten Schiffsetiketten. Bei begrenzten realen Daten können Modelle nur zwischen breiten Kategorien wie „kleinem Gefäß“ und „großem Gefäß“ unterscheiden. Mit AIMMGen wurde jedoch ein Modell ausschließlich auf synthetische Daten trainiert und war in der Lage, spezifische Gefäßsubtypen zu klassifizieren. Die Leistung wurde in mehreren realen Kollektionen validiert, einschließlich Frischwasser- und littoralen Umgebungen, was die Robustheit des rein synthetischen Trainings und das Potenzial zur Erweiterung von Zielklassen demonstriert, wenn reale Bilder kaum oder schwer zu erfassen sind.
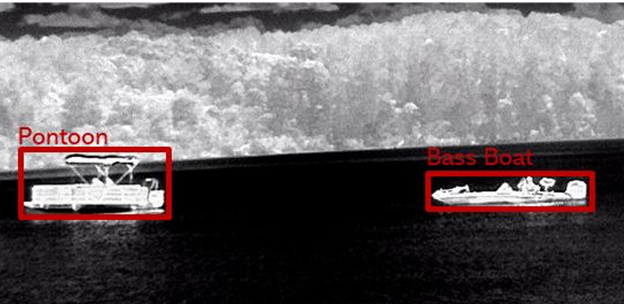
Abbildung 3: Feinkörnige Identifizierung von Seeschiffen in MWIR mit synthetischen datengeschulten KI-Modellen
Zusammenfassung
Die Erstellung großer, vielfältiger Trainingsdatensätze für EO-, IR- und Multispektralanwendungen bleibt ein großes Hindernis für die Bereitstellung robuster KI-Wahrnehmungssysteme. AIMMGen bewältigt diese Barriere mit synthetischen Bildern, automatisierter Metadatenverwaltung, Datensatzkuratierung und Modelloptimierung. Als Teil der breiteren Strategie von Teledyne FLIR OEM für digitale Prism Produkte ist AIMMGen mehr als nur eine Toolchain zur Datengenerierung. Es bietet eine Modellgenerationsgrundlage für die Entwicklung, Validierung und Erweiterung missionsspezifischer KI-Wahrnehmungsfunktionen für Verteidigungs-, Autonomie-, Ersthelfer- und andere OEM-Anwendungen.
Weitere Informationen über die Prism Softwarefamilie und digitale Produkte von Teledyne FLIR OEM finden Sie unter oem.flir.com/prism.
Zugehörige Artikel
-
 Artikel
Fortschritte bei handelsüblichen MWIR-Bildgebungssystemen können die Entwicklungszeit um zwei Jahre verkürzen
Weitere Informationen -
 Artikel
Comparing Sensitivity of Thermal Imaging Camera Modules
Weitere Informationen -
 Whitepaper
Beyond Embedded AI: Optimizing the Thermal Perception Pipeline from Sensor Data to Edge Deployment
Weitere Informationen