
Über eingebettete KI hinaus: Optimierung der thermischen Wahrnehmungspipeline von Sensordaten bis hin zur Edge-Bereitstellung
ZUSAMMENFASSUNG
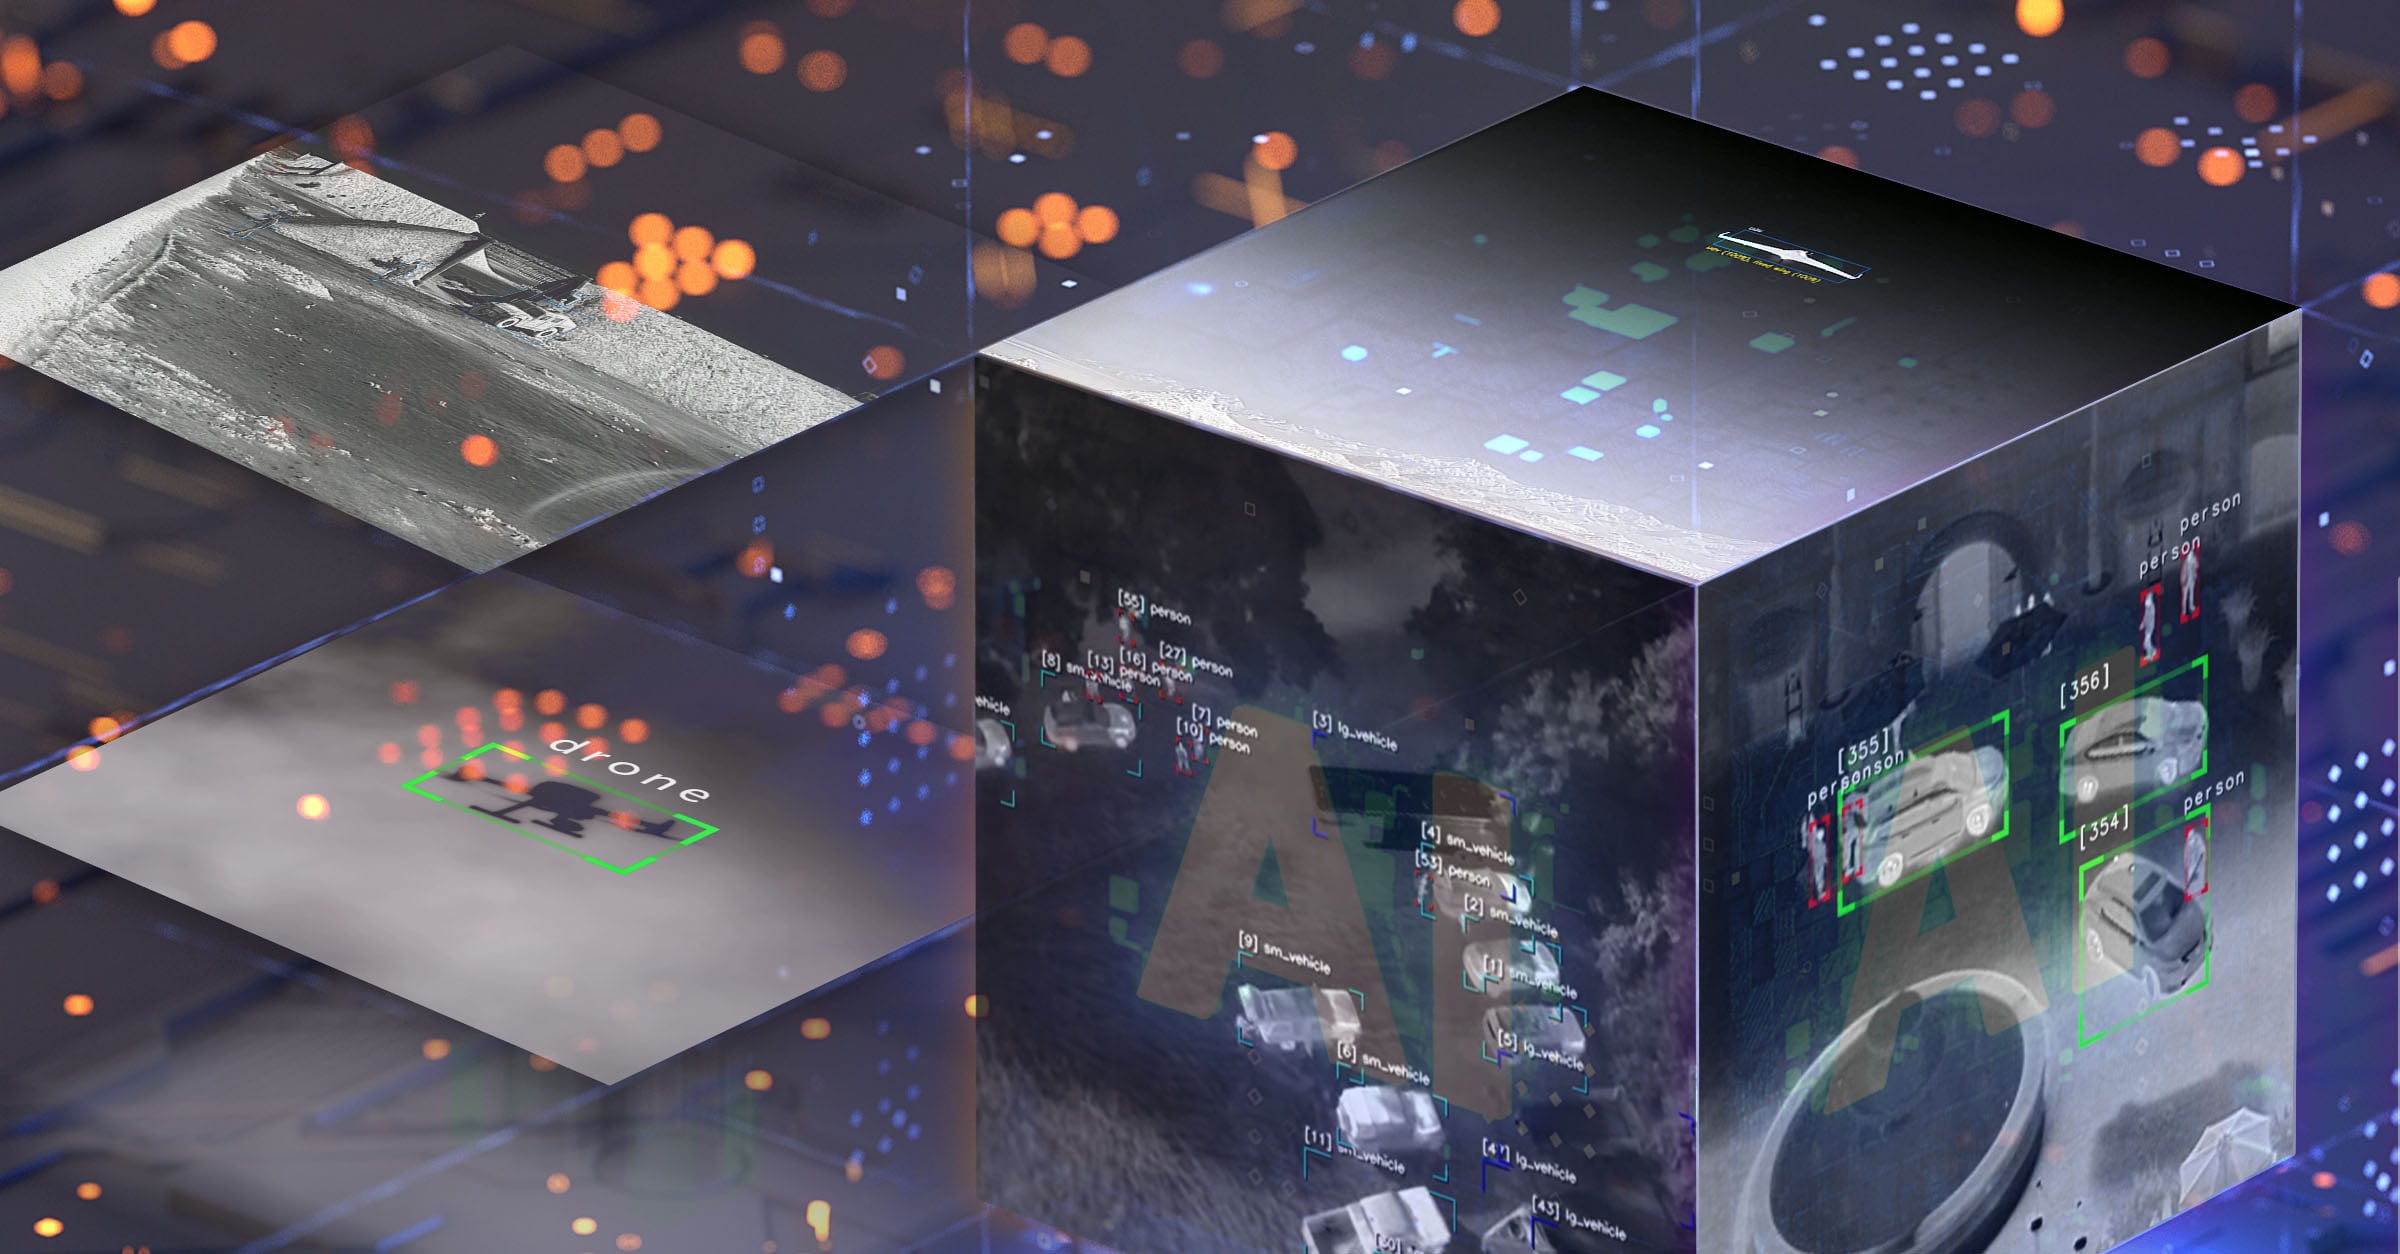
Die schnellen Fortschritte bei Deep Learning, Computer-Imaging und eingebetteten Prozessoren haben es ermöglicht, anspruchsvolle Wahrnehmungs-Workloads am Edge auszuführen. Bei thermischen und multispektralen Systemen geht der Wettbewerbsvorteil über die Platzierung eines Modells für künstliche Intelligenz (KI) auf einem eingebetteten Prozessor hinaus. Der größere Vorteil liegt in der Optimierung der gesamten Wahrnehmungspipeline, von Sensordaten und Bildsignalverarbeitung bis hin zur Objekterkennung, Verfolgung, Laufzeitoptimierung, Wärmemanagement und Feldbereitstellung unter realen Bedingungen für Größe, Gewicht, Leistung, Latenz, Bandbreite und Umgebungsbedingungen.
In diesem Artikel wird beschrieben, wie Teledyne FLIR OEM die thermische und multispektrale Bildsignalverarbeitung von Prism™, anwendungsspezifische Erkennungs- und Trackingbibliotheken und moderne eingebettete KI-Plattformen integriert, um Kunden beim Aufbau intelligenter Bildgebungssysteme zu unterstützen, die verwertbare Informationen zum Zeitpunkt der Erfassung liefern.
.
INHALT
- Akroynme
- Einführung
- Fortschritte bei Leichtbaumodellen und mobilen Prozessoren
- Entwicklung eines neuronalen Netzwerks für Embedded-Plattformen – Einführung von PeleeTM
- Optimierung
- Die schnelle Entwicklungskraft mobiler Prozessoren
- Frameworks
- Videoverarbeitungs-Pipeline
- Prism ISP-Funktionen
- Schlussfolgerungen
1. Akryonme
| Akronym | Definition |
|---|---|
| FAS | Erweiterte Fahrerassistenzsysteme |
| Kontrastabstimmung (AGC) | Kontrastabstimmung (AGC) |
| KI | Künstliche Intelligenz |
| ARM | Erweiterte RISC-Maschinenprozessorarchitektur |
| ASIC | Anwendungsspezifischer integrierter Schaltkreis |
| ATR | Automatische Zielerkennung |
| CI | Computergestützte Bildgebung |
| CNN | Konvolutionelles neuronales Netzwerk |
| CPU | Zentrale Verarbeitungseinheit |
| DSP | Digitaler Signalprozessor |
| FFB | Funktions-Fusionsblock |
| FPGA | Feldprogrammierbares Gate-Array |
| GPU | Grafikverarbeitungseinheit |
| HTP | Sechskant-Tensor-Prozessor |
| ILSVRC | Herausforderung für die visuelle Erkennung im großen Maßstab von ImageNet |
| INT | Ganzzahliges Präzisionsformat, wie in INT8 oder INT4 |
| IP | Geistiges Eigentum |
| IR | Infrarot |
| ISR | Intelligenz, Überwachung und Aufklärung |
| ISP | Bildsignalverarbeitung/Bildsignalprozessor |
| LCE | Lokale Kontrastverstärkung |
| MSX | Bildoptimierung |
| NMS | Nicht-maximale Unterdrückung |
| NPU | Neurale Verarbeitungseinheit |
| ONNX | Neural Network Exchange öffnen |
| PANet | Pyramidennetzwerk mit Pfadaggregationsfunktion |
| RAM | Random Access Memory (Direktzugriffsspeicher) |
| RISC | Computer mit reduziertem Befehlssatz |
| SDK | Software Development Kit |
| SLAM | Gleichzeitige Lokalisierung und Zuordnung |
| SoC | System auf Chip |
| SoM | System am Modul |
| SSD | Einzelschuss-Detektor |
| SWaP | Größe, Gewicht und Leistung |
| TOPS | Billionen von Operationen pro Sekunde |
| YOLO | Sie schauen nur einmal |
2. Einführung
In den letzten zehn Jahren haben Fortschritte im Bereich Deep Learning die Computervision von Systemen, die auf handgefertigter Funktionsextraktion basieren, in datengesteuerte Modelle umgewandelt, die auf großen Datensätzen trainiert und für spezialisierte Wahrnehmungsaufgaben optimiert wurden. Diese Verschiebung veränderte die Herausforderungen der Objekterkennung grundlegend: Anstatt feste visuelle Funktionen von Hand zu entwerfen, konzentrieren sich Entwickler jetzt auf die Erfassung repräsentativer Trainingsdaten, die Auswahl geeigneter Modellarchitekturen und die Anpassung zunehmend ausgefeilter neuronaler Netzwerke an reale Bereitstellungsbedingungen. Wie oft bei der frühen Technologieentwicklung wurde zunächst weniger auf die Rechenleistung geachtet, die zum Trainieren und Ausführen dieser Modelle benötigt wird.
Diese mangelnde Besorgnis schränkte ein, wie die neue Technologie in visionsbasierten Systemen eingesetzt werden könnte, insbesondere in videozentrierten Anwendungen, bei denen die Notwendigkeit einer Echtzeit-Objektklassifizierung, Metadatengenerierung und Warnungen entscheidend ist. Gleichzeitig wurde in der Mobilfunkbranche ein Waffenwettbewerb um die Kameraleistung durchgeführt. Dies führte zur schnellen Entwicklung hochentwickelter Bildsignalprozessoren (ISPs), die eine ständig verbesserte Kameraleistung mithilfe von Algorithmen und dem, was heute als computergestützte Bildgebung (CI) bezeichnet wird, ermöglichten. In jüngster Zeit hat die rasche Einführung von großen Sprachmodellen, Vision-Sprachmodellen und multimodaler KI die Nachfrage nach heterogenen Prozessoren erhöht, die sowohl traditionelle Vision-Pipelines als auch neuere, vom Fundamentmodell inspirierte Workloads näher am Sensor ausführen können.
Heutige Prozessoren verfügen über heterogene Architekturen mit mehreren zentralen Verarbeitungseinheiten (CPUs), Grafikprozessoren (GPUs), digitalen Signalprozessoren (DSPs), neuronalen Verarbeitungseinheiten (NPUs) und ISP-Rechenblöcken. Darüber hinaus hat die Open-Source-Community viele der Bausteine zur Erstellung von Wahrnehmungssystemen beigetragen, darunter YOLO-Familienobjektdetektoren, transformatorbasierte Erkennungsmodelle, plattformunabhängige Dateiformate wie Open Neural Network Exchange (ONNX), Entwicklungsframeworks wie PyTorch und TensorFlow sowie Produktionslaufzeiten wie TensorRT, ONNX Runtime, OpenVINO, LiteRT/TensorFlow Lite und hardwarespezifische Softwareentwicklungskits (SDKs). Es ist zu einem gängigen Workflow geworden, um in PyTorch oder TensorFlow zu trainieren, nach ONNX zu exportieren, die Ziellaufzeit zu optimieren und zu quantisieren und dann Latenz, Leistung, Speichernutzung und Genauigkeit direkt auf der eingesetzten Hardware zu validieren.
Teledyne FLIR OEM konzentriert sich auf die Integration von Wahrnehmung und computergestützter Bildgebung oder Bildsignalverarbeitung in hochformatige, gewichts- und leistungsoptimierte (SWaP) Prozessoren für eine Vielzahl von Anwendungen. Durch die Nutzung neuer Siliziumdesigns, die auf den fortschrittlichsten Knoten hergestellt werden, können Systementwickler die Batterielebensdauer erhöhen und das Wärmemanagement des Systems vereinfachen.
Dies ist die zentrale Designherausforderung für intelligente thermische Systeme. Sichtbare Kamera-KI-Techniken können nicht einfach auf die Wärmebildgebung übertragen werden, ohne Sensorphysik, geringeren Texturgehalt, Umgebungsvariabilität, atmosphärische Effekte, Zielgröße, Optik, Bildrate, Kalibrierung und die Bildverarbeitungsschritte zu berücksichtigen, die das Bild prägen, was der Detektor sieht. In der Praxis hängt die Erkennungs- und Verfolgungsleistung von der gesamten Kette ab: Rohdaten von Sensordaten, radiometrische oder nicht-radiometrische Verarbeitung, Tonabbildung, Denoising, Stabilisierung, Superauflösung, Modellarchitektur, Quantisierung, Laufzeitabbildung, Speicherbandbreite und Energiemanagement. Der Vorteil von Teledyne FLIR OEM liegt in seiner Fähigkeit, die gesamte Kette zu optimieren, anstatt KI-Inferenz als eigenständige Funktion zu behandeln.
3. Fortschritte bei leichten Modellen
und mobile Prozessoren
Nachdem die Auswirkungen von Deep Learning auf die Computervision erkannt wurden, begannen die Arbeiten an der Entwicklung neuronaler Netzwerke und Modelle, die auf kostengünstigen mobilen Prozessoren an der Edge ausgeführt werden konnten, und ermöglichten die Objekterkennung für Video-Echtzeitanwendungen, einschließlich automatischer Zielerkennung (ATR), Fahrzeugautonomie, Advanced Driver Assistance Systems (ADAS), Sicherheit und sowohl für Boden- als auch Luftintelligenz, Überwachung und Aufklärung (ISR). Weitere Softwarepakete, die in visionsbasierte Produkte integriert sind, sind Simultaneous Localization and Mapping (SLAM), Kollisionsvermeidung, Sensorfusion, optischer Fluss und Objektverfolgung. Diese rechenintensiven Funktionen werden, wenn sie für eine bestimmte Hardwarearchitektur kompiliert werden, über CPU-, GPU-, DSP-, NPU-, ISP- und Speichersubsysteme innerhalb des Zielsystems auf dem Chip (SoC) abgebildet. Die Verwaltung dieser Aufgaben über moderne heterogene Prozessoren hinweg ist eine erhebliche technische Herausforderung, bietet jedoch im Vergleich zu Cloud-abhängigen Architekturen erhebliche Vorteile bei Leistung, Latenz und Wärmemanagement. In nur wenigen Prozessorgenerationen sind fortschrittliche SoCs von Knoten der 10 nm-Klasse zu Designs der 7 nm-, 5 nm- und 4 nm-Klasse übergegangen, was zu einer deutlich verbesserten Leistung pro Watt führte.
Tabelle 1 – Repräsentative Embedded Edge-KI-Prozessoren und -Module
| PLATTFORM | PROZESSKNOTEN | KI-LEISTUNG | LEISTUNGSBEREICH | BESTE GEBRAUCHSFÄLLE |
|---|---|---|---|---|
| NVIDIA Jetson Orin Nano Super Developer Kit | 8 nm-Klasse | Bis zu 67 INT8 TOPS | 7 W bis 25 W konfigurierbar | Prototyping, Robotik, Vision-KI, multimodale Edge-KI und Entwicklerökosysteme mit CUDA- und TensorRT-Unterstützung. |
| NVIDIA Jetson AGX Orin | 8 nm-Klasse | Bis zu 275 TOPS | 15 W bis 60 W konfigurierbar | Hochleistungsrobotertechnik, Multikamera-Wahrnehmung, autonome Systeme und größere Edge-KI-Workloads. |
| Qualcomm Dragonwing QCS8550 | 4 nm | Bis zu 48 INT8 TOPS, je nach Modulimplementierung | Anwendungsabhängig | Intelligente Kameras, Industriedrohnen, autonome mobile Roboter, Edge-KI-Boxen und hoch integrierte IoT-Plattformen mit geringer Leistung. |
| Beschleuniger der Klasse Hailo-8/Hailo-10 Hailo-10-class | Beschleuniger abhängig | Zehn bis Hunderte von TOPS, je nach Gerät | Niedrigleistungsbeschleunigerklasse | Vision-Beschleunigung in Kameras, Gateways, Industriesystemen und kosten- oder leistungsempfindlichen Bereitstellungen. |
Bildsignalverarbeitung und KI-Objekterkennungsalgorithmen sind rechenintensiv. Beispielsweise führen die fortschrittlichen Denoising- und Superauflösungsalgorithmen von Teledyne FLIR OEM bis zu 100.000 Operationen pro Pixel pro Sekunde (ca. 2 Billionen Operationen pro Sekunde (TOPS) für einen 640x512-Auflösungseingang bei 60 Frames pro Sekunde (fps)) aus und laufen auf einem GPU-Kern. Das Ausführen großer Objekterkennungsmodelle verbraucht auch viel Verarbeitungsleistung und läuft auf dem DSP-Subsystem (Qualcomm®) oder GPU (NVIDIA®).
Für thermische Systeme ist rohe TOPS eine nützliche, aber unvollständige Metrik. Die tatsächliche Leistung hängt davon ab, wie effizient jede Phase der Pipeline der entsprechenden Rechenressource zugeordnet wird, wie oft Videodaten sich durch den Speicher bewegen müssen, ob die Bildverbesserung das Detektorvertrauen verbessert oder verschlechtert und ob das gesamte System die erforderlichen Frameraten aufrechterhalten kann, ohne die Leistungs- oder thermischen Grenzen zu überschreiten. Die effektivsten eingebetteten KI-Designs beginnen daher mit dem Erfassungsproblem und der Bereitstellungsumgebung, nicht nur mit der Prozessorspezifikation.
Es gibt viele Variablen, die bei der Entwicklung und Bereitstellung eines Objektdetektors zu berücksichtigen sind, darunter Prozessorarchitektur, gewünschte Genauigkeit, akzeptable Latenz oder Bildrate, Speicherbandbreite, Softwarelaufzeit, Modellgröße und Leistungs-/Thermalbudget. Als Reaktion auf die Anforderungen, Objektdetektoren auf eingebetteten Prozessoren auszuführen, wurden mehrere neuronale Netzwerke mit geringer Leistung entwickelt, darunter You Only Look Once (YOLO) von Joseph Redmon von der University of Washington im Jahr 2015 und MobileNet von Google im Jahr 2017. Seitdem hat sich die Detektorlandschaft erheblich erweitert, um neuere YOLO-Familienmodelle, transformatorbasierte Detektoren, nicht-maximale Unterdrückungs-(NMS)-freie Architekturen und Modelle für die Multitask-Wahrnehmung und die Erkennung von offenen Wörtern zu umfassen. Bei eingebetteten thermischen und multispektralen Systemen ist die wichtigste Frage nicht nur, welches Netzwerk das neueste ist, sondern welches Modell die erforderliche Erkennungsleistung, Latenz, den Energieverbrauch und die Integrationszuverlässigkeit auf dem ausgewählten Prozessor liefert.
YOLO revolutionierte die Objekterkennung mit seinem Single-Pass-Ansatz. Im Gegensatz zu regionenbasierten faltungsneuronalen Netzwerken (RCNN), die mehrere Phasen, wie z. B. Regionsvorschläge, gefolgt von einer Klassifizierung umfassen, erreicht YOLO die Erkennung und Lokalisierung in einem einzigen Vorwärtsdurchlauf des Netzwerks. Durch die Aufteilung eines Eingabebildes in ein Raster und die gleichzeitige Vorhersage mehrerer Begrenzungsrahmen und Klassenwahrscheinlichkeiten für jede Rasterzelle bietet der YOLO-Algorithmus sowohl Geschwindigkeit als auch Genauigkeit. Einstufige Detektoren verwenden ein einziges Feed-Forward-Netzwerk, um Objektklassen und Standorte direkt vorherzusagen. Single Shot Detector (SSD) verbessert YOLO in mehreren Aspekten, einschließlich der Verwendung von Multiskalen von Merkmalen zur Vorhersage und der Verwendung von Standardkästen und Seitenverhältnissen zur Anpassung an unterschiedliche Objektformen. Während zweistufige Ansätze im Allgemeinen eine höhere Genauigkeit erzeugen, arbeiten einstufige Ansätze oft mit höherer Effizienz. Neuere Detektoren verbessern diesen Handelsraum weiterhin durch bessere Merkmalsaggregation, quantisierungsbewusstes Design, transformatorinspirierte Aufmerksamkeitsmechanismen und einsatzfreundliche Architekturen, die den Nachbearbeitungsaufwand reduzieren.
4. Entwicklung eines neuronalen Netzwerks für Embedded-Plattformen – Einführung von Pelee

Abbildung 1 – Architektur des Objektdetektors (Juan R. Terven, 2023)
Die Objekterkennung für Wärmebildkameras erfordert einen anderen Ausgangspunkt als die Auswahl eines Allzweck-Sichtmodells. Thermische Bilder enthalten oft weniger visuelle Texturen als sichtbare Bilder; Ziele können nur eine kleine Anzahl an Pixeln einnehmen; und Umgebungsbedingungen können Kontrast, scheinbare Form und Hintergrundstörung ändern. Diese Faktoren machen es wichtig, den Detektor gemeinsam mit dem Sensor, der Optik, der Bildverarbeitungspipeline und der Bereitstellungshardware zu entwerfen.
Teledyne FLIR OEM erweiterte den Single-Pass-Ansatz mit der Entwicklung seines Pelee-Netzwerks (Patent angemeldet). Convolutional Neural Networks (CNNs) bestehen aus drei Hauptblöcken: dem Merkmalsextraktor oder Backbone, einem Merkmalsaggregator oder Hals und dem Kopf- oder Objektdetektor. Pelee verfügt über ein neues Backbone-Design, das mit einem dichten Konnektivitätsmuster ausgestattet ist, um die Wiederverwendung von Funktionen zu fördern, und eine dichte Zwei-Wege-Schicht, um verschiedene Skalierungen von aufnahmefähigen Feldern zu erhalten. Pelee integriert einen neuen Feature-Fusionsblock (FFB) basierend auf dem Path Aggregation Feature Pyramid Network (PANet). Die neue FFB wurde mit Blick auf die Erkennung kleiner Ziele entwickelt und verfolgt eine späte Fusionsstrategie, die sicherstellen soll, dass jede Merkmalskarte der Ausgabe die detaillierten Informationen speichert, die aus den flachen Schichten gewonnen wurden, und hochrangige semantische Merkmale erwirbt.
Tabelle 2 – Backbone-Ressourcen
| RAHMENWERK | BACKBONE | COMPUTATIONALE KOSTEN (FLOPS) | ||
|---|---|---|---|---|
| Backbone | Gesamt | Teil des Backbones | ||
| SSD | VGG | 31.9 | 34.2 | 93,3 % |
| VerfeinernDet | VGG | 31.9 | 37.38 | 85,3 % |
| YOLOv3 | DarkNet 53 | 14.51 | 19.54 | 74,2 % |
| RetinaNet | ResNet101 | 15.48 | 34.51 | 53,4 % |
Das Backbone-Netzwerk wirkt sich direkt auf den Speicher, die Geschwindigkeit und die Leistung des Objektdetektors aus. Bei SSD CNN werden über 90 % der Berechnungskosten vom Backbone-Netzwerk verbraucht. Das CNN von Teledyne FLIR OEM verfügt über ein neues Backbone-Design, das die Verwendung eines Squeeze-and-Excitation-Blocks vermeidet, die Aktivierungsfunktionen sorgfältig entsprechend der Hardware auswählt und die Breite und Tiefe des Netzwerks entsprechend der Hardware anpasst.
Pelee sollte daher als anwendungsspezifische, einsatzorientierte Detektorarchitektur und nicht als Allzweck-Benchmark-Gewinner für jede neue Modellfamilie verstanden werden. Sein Wert liegt im technischen Fachbereich, der für intelligente Wärmebildkameras wichtig ist: Leistung mit kleinen Zielen, vorhersehbare Latenz, Speichereffizienz, hardwarebewusste Aktivierungsmöglichkeiten und die Fähigkeit, neben Prism ISP-Funktionen zu laufen, Videostabilisierung, Tracking und andere Wahrnehmungs-Workloads innerhalb einer eingeschränkten SWaP-Hülle.

Abbildung 2 – Leistung des Pelee Backbone-Modells

Abbildung 3 – Vergleich der Leistung von Pelee versus YOLO Networks
5. Optimierung
Quantifizierung
Quantisierung ist die Komprimierung von Gleitkommawerten in neuronalen Netzwerkparametern, um die Modelllatenz zu verbessern, den Speicherbedarf zu reduzieren und den Stromverbrauch bei der Ausführung von Inferenz zu senken. Das Modelltraining wird im Allgemeinen unter Verwendung von 32-Bit-Gleitkommadaten auf leistungsstarken GPU-basierten Systemen durchgeführt. Die Schlussfolgerung auf eingebetteten Prozessoren wird dann mit FP16, FP8, INT8, INT4 oder anderen laufzeitunterstützten Präzisionen optimiert, abhängig vom Prozessor, der Modellarchitektur, den Kalibrierungsdaten und den akzeptablen Genauigkeitsabwägungen.
Teledyne FLIR OEM verwendet INT8, um den Speicherbedarf, die Rechenzeit und den Energieverbrauch zu reduzieren, da es für viele Embedded-Vision-Workloads ein praktischer Kompromiss zwischen Präzision und Geschwindigkeit bleibt. Die Bereitstellung hängt jedoch zunehmend von expliziten Quantisierungsworkflows, repräsentativen Kalibrierungsdaten, quantisierungsbewussten Schulungen bei Bedarf und zielspezifischer Motorgenerierung ab. Entwickler sollten FP16, INT8- und Niedrigpräzisionsoptionen auf der tatsächlichen Hardware validieren, da Leistung, Genauigkeit, Speichernutzung und thermisches Verhalten zwischen GPU-, DSP-, NPU- und anbieterspezifischen Laufzeitimplementierungen erheblich variieren können. Die Rückgewinnung von Rechenressourcen gibt Entwicklern die Flexibilität, mehr Funktionen hinzuzufügen, einschließlich Echtzeitinferenz auf zwei oder mehr Kamera-Feeds.
Beschneiden
Das Beschneiden ist ein Verfahren, das verwendet wird, um ungenutzte Datenpfade im neuronalen Netzwerk zu reduzieren, indem die Bedeutung jeder Einheit bestimmt und passive Pfade entfernt werden. Nach dem Training haben viele der Netzwerkneuronen einen Gewichtswert von 0, sodass diese Neuronen nach der Quantifizierung durch einen sekundären Netzwerktrainingsprozess eliminiert werden können. Zu den aktuellen Beschneidungsmethoden gehören das Beschneiden von Gewichten, das Beschneiden von Kanälen und das Beschneiden von Neuronen, jeweils mit ihren Vor- und Nachteilen.
Die Kriterien zur Bestimmung der Bedeutung der Einheit können die Genauigkeit beeinflussen. Die Verwendung von Lernmethoden für Einschränkungen kann diese verbessern, obwohl die Implementierung komplex ist. Die zufällige Suchmethode des Beschneidens ist einfach zu implementieren, aber die Leistung des Netzwerkmodells ist im Vergleich zu anderen Methoden, die es verbessern, begrenzt. Daher muss jede Methode in Verbindung mit dem tatsächlichen Anwendungsszenario ausgewählt werden. Es gibt keine einzige Methode, die Komplexität synthetisieren und Komprimierungseffizienz modellieren kann.[i]
Wärmemanagement
Für viele Produktkategorien, einschließlich Drohnen und Waffenschauplätze, ist der Stromverbrauch eine kritische Designbeschränkung. Ein hoher Verbrauch begrenzt die Betriebszeit, fügt Herausforderungen bei der Unterstützungslogistik hinzu und erhöht die Komplexität und die Kosten für das Wärmemanagement. Für einige batteriebetriebene Geräte besteht die Wahl darin, ein feldprogrammierbares Gate-Array (FPGA) oder einen anwendungsspezifischen integrierten Schaltkreisprozessor (ASIC) zu verwenden, um die Leistung auf ein absolutes Minimum zu beschränken, aber Analysen und ISP-Software von Drittanbietern sind nicht verfügbar, da diese Bibliotheken typischerweise für den Betrieb auf Advanced RISC Machine (ARM)-Prozessoren und anderen Kernen unter Verwendung von Open-Source-Komponenten und -Frameworks wie OpenCV kompiliert werden. Dies ist bei den leistungsstärksten Produkten zwar nicht der Fall, aber der Leistungsbedarf der eingebetteten Prozessoren der neuen Generation, die auf Knoten von 4 nm bis 7 nm gefertigt werden, bietet Systemdesignern viele Optionen, um hochwertige Funktionen für Produkte hinzuzufügen.
Bei einem System, das mehrere Kameras und mehrere Funktionsroutinen wie einen Objektdetektor, Zieltracker und lokale Kontrastverstärkung ausführt, erreicht der Entwickler die obere Grenze des Prozessordurchsatzes und erzeugt viel Wärme. Um dies zu verwalten, können Softwareentwickler Konfigurationsparameter erstellen, die dynamisch eingestellt oder angepasst werden können. Für viele Anwendungen ist es beispielsweise nicht erforderlich, mit Bildfrequenz zu folgern. Durch Reduzieren der Inferenzausgabe auf 10 fps oder weniger kann das Leistungsprofil des gesamten Softwarestapels so verwaltet werden, dass es dem Leistungsbudget entspricht.
6. Die schnelle Entwicklungskraft
der mobilen Prozessoren
Die Ausführung von CNN-Modellen und CI-Algorithmen ist äußerst rechnerisch anspruchsvoll. Bis vor kurzem hatten eingebettete Prozessoren nicht die Fähigkeit, KI- und CI-Workloads zu erfüllen. KI erfordert eine massive Parallelität von Multiplikationsakkumulationsfunktionen. Herkömmliche Grafikprozessoren waren in der Lage, Parallelität in ähnlicher Weise für Grafiken zu schaffen, sodass sie für KI-Anwendungen wiederverwendet wurden, insbesondere für das Modelltraining. Infolgedessen hat sich NVIDIA als dominanter Akteur im Modelltraining etabliert.
Die mobilen und eingebetteten Prozessoren von heute sind erstaunliche technische Meisterleistungen. Zum Beispiel ist der Dragonwing QCS8550 SoC von Qualcomm ein 4-nm-Design, das CPU, GPU, DSP, NPU, Computer Vision und dedizierte ISP-Ressourcen für anspruchsvolle IoT- und Edge-KI-Anwendungen bietet. Die integrierten ISP- und Computer Vision-Ressourcen unterstützen Funktionen wie Video-Denoising, Stabilisierung, Bildkorrektur, Weißabgleich, Farbverarbeitung, automatische Verstärkungskontrolle, Fokus und andere Kamerafunktionen. Diese Klasse von Chips erfordert enorme Entwicklungsinvestitionen und hängt von fortschrittlichen Gießereifähigkeiten, Software-Tools und langfristigem Ökosystem-Support ab.

Abbildung 5 – QCS 8550 Prozessorkerne
Teledyne FLIR OEM wollte eine Plattform schaffen, auf der Kunden ihre Produkte aufbauen können und die die Erstellung hochintegrierter Software-Stacks ermöglicht und Kosten, Latenz und Leistung durch den Einsatz eines einzigen Prozessors minimiert, wo dies möglich ist. Dies war das Ziel über mehrere Plattformgenerationen hinweg, einschließlich der Auswahl des Intel® Myriad™-Prozessors für das Teledyne FLIR OEM Boson® Thermoinfrarot (IR)-Kameramodul. Die Myriad-Chip-Architektur konnte die schwereren Rechenanforderungen für computergestützte Bildgebung oder CNN-basierte Objektdetektoren nicht erfüllen. Mit der Einführung von NVIDIA Xavier, NVIDIA Jetson Orin-Modulen, Qualcomm RB5/QCS5165 und Qualcomm QCS8550-class wurde es praktisch, mehrere Software-Stacks auszuführen, die über bestimmte Prozessorkerne und Beschleuniger verteilt sind.
Übersicht über System on Chip (SoC)
Die eingebetteten Prozessoren von heute nutzen die neuesten Giessereiknoten und ermöglichen so Multi-Core-Designs mit einheitlichem Speicher. Prozessorlieferanten bieten eine sehr umfassende Entwicklungsunterstützung, und Entwickler können ihren Code auf diesen Multicore-Prozessoren bereitstellen, um die Leistung zu maximieren und gleichzeitig die Strom- und thermischen Budgets zu erfüllen.
CPU
Die Kernfunktionalität der CPU besteht darin, Anweisungen aus dem Direktzugriffsspeicher (RAM) abzurufen und dann die Anweisungen zu dekodieren und auszuführen. CPUs sind generalistische Prozessoren, die für die Ausführung von Routinen entwickelt wurden, die sequenzielle Workloads verarbeiten. Viele CPUs verfügen über integrierte Vektorprozessoren, um einige Vorgänge zu beschleunigen (z. B. NEON auf ARM-basierten CPUs). Mehrere der digitalen Produktfunktionen von Teledyne FLIR OEM laufen auf CPU-Kernen, darunter Prism ISP Korrelationsvideotracker und elektronische Videostabilisierung. Angesichts der großen Anzahl an CPU-Kernen, die auf SoCs der aktuellen Generation verfügbar sind, haben Entwickler eine enorme Flexibilität, um Leistung und Leistung zu optimieren. CPUs eignen sich nicht gut für Aufgaben, die eine große Anzahl von mathematischen Operationen pro Pixel erfordern. CPUs haben Durchsatzbeschränkungen und verbrauchen pro Betrieb relativ hohe Leistung.
GPU
KI- und CI-Workloads sind enorm und fordern eine beträchtliche Bandbreite und Rechenleistung. Prozessordesigner haben leistungsstarke Chiparchitekturen entwickelt, die Speicher, Sicherheit und Echtzeit-Datenkonnektivität integrieren. Herkömmliche CPUs verfügen in der Regel nicht über die erforderliche Verarbeitungsleistung, sind aber ideal für die Durchführung sequenzieller Aufgaben. Grafikprozessoren können die Parallelität der Multiplikationsakkumulationsfunktionen von KI bewältigen und auf KI-Anwendungen angewendet werden. Tatsächlich können GPUs als KI-Beschleuniger dienen und die Leistung für neuronale Netzwerke und ähnliche Workloads verbessern. GPUs können Tausende von Rechenkernen haben und werden für viele parallele Verarbeitungsaufgaben verwendet. GPUs sind besonders nützlich für Trainingsmodelle. Grafikprozessoren verbrauchen jedoch erhebliche Leistung und haben höhere chipinterne Speicheranforderungen. Aus diesem Grund setzen moderne mobile Prozessoren dedizierte KI-Coprozessoren ein, die digitale Signalprozessoren (DSPs) verwenden, um Inferenz an der Edge auszuführen.
DSP
DSPs sind spezialisierte und energieeffiziente SoC-Subsysteme, die für mathematische Operationen optimiert sind. Sie verwenden breite Befehlswörter, um die Verarbeitung pro Taktzyklus zu maximieren. Sie sind jedoch nicht so einfach zu programmieren und erfordern Vertrautheit mit den Funktionen der DSP-Hardware, der Programmierumgebung und der Optimierung der DSP-Software, um die beste Leistung zu erzielen. Der Qualcomm Hexagon™ Tensor Processor (HTP) ist ein KI-Beschleuniger, der sich für rechenintensive KI-Workloads eignet. Um eine verbesserte Leistung zu erzielen und ein KI-Modell auf HTP auszuführen, muss ein Modell auf eine der unterstützten Präzisionen quantifiziert werden: INT4, INT8, INT16 oder FP16.
ISP
Da die digitale Fotografie die Frontlinie des Wettbewerbs in der Mobilhandset-Branche ist, integrieren Anbieter von mobilen Prozessoren dedizierte Blöcke für geistiges Silizium-Eigentum (IP), um Bildverbesserungsfunktionen wie Rauschunterdrückung, Objektivverzerrungskorrektur, Weißabgleich, automatische Belichtung, Autofokus, De-Mosaiking und Bildkomprimierung durchzuführen. Auf Systemebene ist in der Regel eine ISP-Abstimmung erforderlich, um die Parameter und verschiedene Filter für einen bestimmten Bildsensor und eine bestimmte Linse zu optimieren. Die ISP-Feinabstimmung ist für sich genommen eine Branche. Viele SoC-Lieferanten bieten ISP-Bibliotheken für beliebte Bildsensoren an, was Systementwicklern erhebliche Investitionen erspart.
Es gibt wenig Rechtfertigung für Anbieter mobiler Prozessoren, einen ISP für Wärmebildkameras zu entwerfen und herzustellen. Dennoch sind die Vorteile der Bildsignalverarbeitung wertvoll, daher hat Teledyne FLIR OEM eine umfassende Reihe von ISP-Funktionen entwickelt, einschließlich 16- bis 8-Bit-Tonmapping (automatische Verstärkungskontrolle), räumlich-zeitliche Entrauschung, Superauflösung, Turbulenzminderung und elektronische Bildstabilisierung. Die meisten dieser Algorithmen werden aufgrund der hohen Verarbeitungsanforderungen auf GPUs ausgeführt.
Speicher
Angesichts der hohen Datenraten in digitalen Videostreams und der Tatsache, dass Daten wiederholt von mehreren Algorithmen gelesen werden können, sind Speicherkapazität und Speicherbandbreite entscheidend für eine effiziente Signalverarbeitung. Durch eine Kombination aus höheren Taktgeschwindigkeiten, höherer Speicherbandbreite, dedizierter KI-Beschleunigung und verbesserter Softwareoptimierung wird das größte bestehende KI-Modell von Teledyne FLIR OEM (768 x 768 Pixel Eingangsauflösung) in 6 ms auf dem Qualcomm QCS8550 gegenüber 33 ms auf dem QRB5165 ausgeführt. Dies stellt eine mehr als 5X Erhöhung der Inferenzgeschwindigkeit dar und bietet einen sicheren Spielraum für das Erreichen von Inferenz bei Bildfrequenz für SXGA-Kameras (1280x1024) der nächsten Generation.
7. Frameworks
KI-Frameworks sind grundlegende Bausteine, die die Art und Weise prägen, wie intelligente Systeme erstellt, optimiert und bereitgestellt werden. Diese Frameworks, die mit Bibliotheken und vorgefertigten Funktionen ausgestattet sind, ermöglichen es Entwicklern, anspruchsvolle KI-Algorithmen zu erstellen, ohne jede Funktion von Grund auf neu entwerfen zu müssen. In Produktions-Edge-KI-Systemen erstreckt sich die Framework-Diskussion nun über das Modelltraining hinaus und umfasst Exportformate, Laufzeitoptimierung, Quantisierungstools, hardwarespezifische Compiler, Regressionstests, Over-the-Air-Update-Strategien und Leistungsüberwachung auf Flottenebene.
PyTorch wird aufgrund seiner Flexibilität und seines benutzerfreundlichen Ausführungsmodells weiterhin häufig für Forschung, Experimente und Modellentwicklung verwendet. Die dynamische Berechnungsgrafik ermöglicht es Entwicklern, das Verhalten von Modellen spontan zu ändern und Python-Steuerungsflussoperationen zu verwenden, wodurch sie sich gut für komplexe Modellarchitekturen, schnelle Prototypenerstellung und iterative Experimente eignet.
TensorFlow bleibt in Produktionsumgebungen und mobilen Implementierungsworkflows wichtig, insbesondere wenn TensorFlow Lite oder LiteRT bereits integriert ist. Die moderne eingebettete Bereitstellung ist jedoch selten eine einfache Wahl zwischen PyTorch und TensorFlow. Ein gängiger Produktionspfad besteht darin, in PyTorch oder TensorFlow zu trainieren, nach ONNX oder einer anderen tragbaren Darstellung zu exportieren, das Diagramm zu optimieren, das Modell zu quantifizieren, zu einer Laufzeit wie TensorRT, ONNX Runtime, OpenVINO, LiteRT/TensorFlow Lite oder Qualcomm AI Engine Direct zu kompilieren und dann Latenz, Genauigkeit, Leistung und thermisches Verhalten auf dem Zielgerät zu validieren. Das beste Framework ist daher dasjenige, das die gesamte Bereitstellungspipeline für den ausgewählten Prozessor und die ausgewählte Anwendung unterstützt, nicht nur dasjenige, das während des Trainings am bequemsten ist.
8. Videoverarbeitungs-Pipeline
In der Videoverarbeitungspipeline wird der Ansatz von Teledyne FLIR OEM am differenziertesten. Anstatt Kamera, ISP, Detektor, Tracker und eingebetteten Prozessor als unabhängige Komponenten zu behandeln, wird die Pipeline als verbundenes System entwickelt. Jede Phase wirkt sich auf die nächste aus: Denoising Changes Target Textur, Contrast Enhancement Changes Model Input Distribution, Stabilisierung verbessert die zeitliche Konsistenz, Super-Resolution kann effektive Details verbessern und Tracking wandelt Frame-für-Frame-Erkennungen in persistente Informationen um. Die Optimierung dieser Interaktionen ist für eine zuverlässige Edge-Wahrnehmung unerlässlich.
Teledyne FLIR OEM entwickelte Prism ISP, eine Sammlung von Bildverarbeitungssoftwarebibliotheken für Wärmebilder, die lokale Kontrastverstärkung (LCE), räumliche und zeitliche Rauschreduzierung, elektronische Bildstabilisierung, Turbulenzminderung, Superauflösung und mehrere Videofusionstechniken umfassen. Diese Funktionen verbessern die Bildqualität für die menschliche Interpretation und formen gleichzeitig die Informationen, die nachgeschalteten Erkennungs- und Tracking-Algorithmen präsentiert werden. Das Ziel besteht sowohl darin, das Video besser aussehen zu lassen als auch die Zuverlässigkeit, Effizienz und Einsatzfähigkeit der gesamten thermischen Wahrnehmungspipeline zu verbessern und gleichzeitig den Energiebedarf und die Kosten zu minimieren. Thermokameramodule von Teledyne FLIR OEM enthalten keine integrierten Prozessoren zur Ausführung von Prism ISP. Mit der Verfügbarkeit moderner mobiler und eingebetteter Prozessoren ist es jetzt praktisch, ein zusätzliches Elektronikmodul mit der Leistung hinzuzufügen, ISP-, Erkennungs- und Tracking-Algorithmen mit nützlichen Videobildraten auszuführen und gleichzeitig die realen Leistungs- und thermischen Einschränkungen zu erfüllen.

Abbildung 6 – Prism Videoverarbeitungspipeline
Thermische Bildgebung wird in vielen Anwendungsfällen verwendet, um Objekte zu visualisieren: in Metern Entfernung zur Inspektion und Brandbekämpfung, in mehreren Kilometern in den Bereichen Intelligenz, Überwachung und Aufklärung (ISR) und aus Luft-, Turm- und Bodenperspektive. Die Kombination aus Reichweite, Perspektive und tages-, nacht- und wetterbasierten Umgebungsbedingungen schafft reale Bildgebungsherausforderungen, die mit Prism ISP-Algorithmusfunktionen gemindert werden können.
9. Prism ISP-Funktionen
Abschwächung von Turbulenzen

Abbildung 7 - Vergleich ohne (links) und mit (rechts) Turbulenzminderung
Unter atmosphärischer Turbulenz versteht man die unregelmäßige und chaotische Bewegung von Flüssigkeit oder Luft, die durch Geschwindigkeits-, Druck- und Dichteschwankungen gekennzeichnet ist. Turbulenzen wirken sich auf die Photonenübertragung aus, da die Sonneneinstrahlung der Oberfläche dazu führt, dass sich die Atmosphäre vermischt. Es wirbelt die Luft ab und bewirkt, dass Wasserdampf, Rauch und andere Substanzen die Brechung des Infrarotsignals verändern. Fortgeschrittene Techniken entfernen die Verzerrungseffekte, während eine gute zeitliche Bildqualität beibehalten wird, was bedeutet, dass Objekte in Bewegung nicht in nicht unterscheidbare Blobs oder Streifen umgewandelt werden. Dies ist entscheidend, wenn Ziele, einschließlich Menschen und Fahrzeuge, mithilfe von KI erkannt werden.
Für die KI-Erkennung und -Nachverfolgung ist die Verminderung von Turbulenzen mehr als nur eine Bildqualitätsfunktion. Verzerrungen, Schimmer und scheinbare Bewegungen können das Vertrauen des Detektors verringern und die Spuren weniger stabil machen. Durch die Verbesserung der zeitlichen Konsistenz vor der Inferenz und Verfolgung kann die Pipeline zuverlässigere Zielinformationen liefern, ohne nur von größeren Modellen oder höheren Rechenbudgets abhängig zu sein.
Die primären Ziele von Algorithmen zur Verminderung von Turbulenzen sind die Verbesserung der Signalqualität, die Reduzierung von Rauschen und die Wiederherstellung der Klarheit und Stabilität unter turbulenten Bedingungen. Der Prism ISP-Algorithmus verwendet verschiedene mathematische und Signalverarbeitungstechniken, um die von Turbulenzen betroffenen Daten zu analysieren und zu verarbeiten.
- Datenerfassung: Der erste Schritt besteht darin, die von Turbulenzen betroffenen Daten zu erfassen. Dies wird in Form von Bild-Frames dargestellt.
- Vorverarbeitung: Die erfassten Daten werden vorverarbeitet, um Rauschen oder Artefakte zu entfernen, die nicht direkt mit Turbulenzen zusammenhängen. Dazu gehören Filter-, Geräuschreduzierungs- und Kalibrierungstechniken zur Verbesserung der Signalqualität.
- Schätzung der Turbulenzen: Es ist wichtig, die in den Daten vorhandenen Turbulenzmerkmale zu schätzen. Dazu gehört die Analyse der statistischen Eigenschaften der Schwankungen und die Identifizierung relevanter Parameter wie Turbulenzintensität, Korrelationslänge und Zeitskalen.
- Dekonvolution oder Rekonstruktion: Dekonvolutionstechniken versuchen, die durch Turbulenzen verursachten Unschärfeeffekte umzukehren. Dekonvolutionsalgorithmen verwenden häufig mathematische Turbulenzmodelle oder Erfahrungswissen, um das ursprüngliche Signal wiederherzustellen.
- Adaptive Filterung: Turbulenzbedingungen können im Laufe der Zeit und des Raums variieren, sodass viele Algorithmen zur Verminderung von Turbulenzen adaptive Filtertechniken verwenden. Diese Verfahren passen die Filterparameter dynamisch basierend auf geschätzten Turbulenzparametern an, um den Kompromiss zwischen der Rauschreduzierung und der Erhaltung wesentlicher Signalmerkmale zu optimieren.
- Nachbearbeitung: Nach den Turbulenzminderungsschritten kann eine zusätzliche Nachbearbeitung durchgeführt werden, um die Qualität weiter zu verbessern und Artefakte in der Endausgabe zu reduzieren. Abhängig von der spezifischen Anwendung kann dies Techniken wie Entstören, Schärfen, Kontrastverstärkung oder Merkmalsextraktion umfassen.
Super-Auflösung

Abbildung 8 – Vergleich ohne (links) und mit (rechts) Super Resolution
Multiframe-Superauflösung ist eine leistungsstarke Technik, die darauf abzielt, ein hochauflösendes Bild aus einem oder mehreren Bildern mit niedriger Auflösung zu rekonstruieren. Die optische Auflösung eines Systems wird durch die durch die Systemöffnung eingestellte Beugungsgrenze und die Abtastauflösung des Detektors begrenzt. Eine kleine Blende und ein Sensor mit niedriger Auflösung führen zu einem günstigeren und kleineren System, das zu schlechten Bildern mit stark aliasierten und/oder verschwommenen Kanten führt. Dies gilt insbesondere, wenn Ziele mit großer Reichweite mit einer Optik mit langer Brennweite erfasst werden, die die Auswirkungen der Beugung in Kombination mit einer begrenzten Blendengröße skaliert. Durch den Einsatz ausgeklügelter Algorithmen rekonstruiert die Superauflösung hochauflösende Bilder unter Verwendung von Daten aus den verschlechterten Eingaben. Während sich traditionelle Methoden hauptsächlich auf die Nutzung der inhärenten räumlichen Korrelationen in Bildern mit niedriger Auflösung konzentriert haben, haben jüngste Fortschritte die Wirksamkeit der Nutzung von Aliasing-Techniken gezeigt, um überlegene Ergebnisse zu erzielen.
In einer Wahrnehmungspipeline kann Superauflösung auch den Erfassungsbereich, die Klassifizierung kleiner Ziele und das Vertrauen des Bedieners beeinflussen. Der Nutzen muss auf Systemebene bewertet werden, da Schärfungs- oder Rekonstruktionsartefakte die visuelle Interpretation unterstützen können, aber auch die Eingangsverteilung eines KI-Modells verändern können. Dies verstärkt die Notwendigkeit, ISP und Detektion zusammen abzustimmen, anstatt als isolierte Funktionen.
Bildstabilisation

Abbildung 9 – Typische Anwendungen für die elektronische Stabilisierung
Kameras werden häufig auf beweglichen Plattformen wie Bodenfahrzeugen, Schiffen, Flugzeugen, Drohnen oder Türmen montiert. Plattformbewegungen werden direkt auf das Videobild übertragen, was zu Ermüdung des Betrachters und schlechter Bildqualität führen kann, was sich auf das Situationsbewusstsein und die Beweistreue auswirkt. Die elektronische Stabilisierung eliminiert die meisten bewegungsinduzierten Bildverzerrungen, insbesondere bei der Bildgebung durch eine Zoomoptik mit schmalem Sichtfeld, die für die Bildgebung mit großer Reichweite verwendet wird.
Für die automatisierte Wahrnehmung verbessert die Stabilisierung die zeitliche Konsistenz und kann die Einleitung falscher Spuren, verpasste Erkennungen und die Ermüdung des Bedieners reduzieren. Es hilft auch nachgeschalteten Algorithmen, Bewegungssignale effektiver zu verwenden, da die durch die Plattform verursachte Bildbewegung reduziert wird, bevor Erkennung und Verfolgung durchgeführt werden.
MSX – Multispektrale dynamische Bildgebung

Abbildung 10 – MSX prägt die sichtbaren Kanten auf Wärmebildern in Echtzeit
Es gibt viele verschiedene Ansätze für die Bildfusion oder die Kombination von thermischen und sichtbaren Bildern in einem einzigen fusionierten Videostream. Ziel ist es, die einzigartigen und wertvollen Informationen jedes Spektrums herauszustellen, ohne dass die Übertragung von zwei oder mehr Strömen für nachgelagerte menschliche Bediener oder Systeme zur Analyse erforderlich ist. Dies kann in der Praxis aufgrund der Notwendigkeit einer perfekten Bildregistrierung (Ausrichtung) von zwei oder mehr Kanälen und Problemen aufgrund der unterschiedlichen Integrationszeiten für jeden Sensor komplex sein.
Teledyne FLIR OEM hat eine einzigartige Technologie namens MSX (Multi-Spectral Dynamic Imaging) patentiert. Im Gegensatz zur Bildmischung (Mischung von sichtbarem Licht und Wärmebild) entfernt MSX keine thermischen Details und verringert die thermische Transparenz nicht. Stattdessen wird ein Hochfrequenzfilter angewendet, um scharfe sichtbare Details wie Symbologie, einschließlich Umrisse, Wörter, Zahlen und andere kontrastreiche Kantendetails, zu extrahieren und sie auf das Wärmebild zu überlagern. Dies hilft bei der Bilddefinition und hat sich in Bereichen wie vorausschauender Wartung, Sicherheit und Luft-ISR-Anwendungen als vorteilhaft erwiesen.
AGC – Automatische Verstärkungsregelung

Abbildung 11 – Lokale Kontrastverstärkung (Boson® 640 Quellvideo)
Im Kontext von Bildern bezieht sich Kontrast auf den Intensitätsunterschied zwischen den hellsten und dunkelsten Regionen. Es spielt eine entscheidende Rolle bei der Definition der visuellen Gesamtauswirkung eines Bildes. Die lokale Kontrastverstärkung, auch als lokale Kontrastdehnung bezeichnet, basiert auf dem Prinzip, den dynamischen Kontrastbereich innerhalb bestimmter Bereiche eines Bildes zu erweitern, anstatt den Kontrast des gesamten Bildes global zu verändern.
Lokale Kontrastverstärkung bringt aufwendige Details zur Geltung, verbessert die Texturen und akzentuiert Merkmale. Die Umwandlung von rohen 16-Bit-Monochrom-Sensordaten in die 8-Bit-Farbtiefe, die wir auf Displays sehen, beruht auf Algorithmen, um die umfangreiche Verteilung von Pixelwerten in 1 von 256 Farb- oder Grautönen abzubilden. Da die Verteilung von Pixelwerten in einem Bild selten linear ist, ist die Maximierung des Kontrasts von Szenario zu Szenario hochkomplex und dynamisch. Im Gegensatz zur globalen Kontrastverstärkung, die den Kontrast über das gesamte Bild gleichmäßig anpasst, konzentriert sich die lokale Kontrastverstärkung auf die Erhaltung lokaler Details und feiner Texturen. Es zielt auf kleinere Bereiche innerhalb des Bildes ab und verstärkt den Kontrast innerhalb dieser Bereiche unter Beibehaltung der relativen Kontrastbeziehungen zwischen benachbarten Bereichen.
Bei KI-Pipelines müssen Tonabbildung und lokale Kontrastverbesserung sorgfältig verwaltet werden, da sie die numerische Eingabe in den Detektor formen. Eine visuell ansprechende Einstellung maximiert möglicherweise nicht immer das Vertrauen des Modells, reduziert Fehlalarme oder bewahrt kleine Zieldetails. Der Ansatz des Teledyne FLIR OEM auf Pipeline-Ebene ermöglicht es, diese Bildverarbeitungsoptionen im Vergleich zu den endgültigen Systemzielen der zuverlässigen Erkennung, Verfolgung und Entscheidungsunterstützung innerhalb der verfügbaren SWaP-Hülle zu bewerten.
10. Fazit
Es gab bemerkenswerte Fortschritte bei Deep Learning, eingebetteten Prozessoren und Produktions-KI-Bereitstellungstools. Für thermische und multispektrale Systeme sind diese Fortschritte wichtig, aber sie allein reichen nicht aus. Der Markt geht über die Frage hinaus, ob KI am Rande laufen kann. Die wichtigere Frage ist, ob die gesamte Wahrnehmungspipeline so konzipiert werden kann, dass sie zuverlässige, umsetzbare Informationen vor Ort liefert und gleichzeitig anspruchsvolle SWaP-, Latenz-, Bandbreiten- und thermische Einschränkungen erfüllt.
Der Vorteil von Teledyne FLIR OEM geht über die reine Ausführung von KI auf eingebetteten Prozessoren hinaus. Es ist die Fähigkeit, die gesamte thermische Wahrnehmungspipeline von Sensordaten, Bildsignalverarbeitung, Modelldesign, Quantisierung, Laufzeitbereitstellung, Verfolgung, Speichernutzung, Energiemanagement und Umgebungsstabilität als integriertes System zu optimieren. In praktischen Anwendungen in den Bereichen Verteidigung, Autonomie, Robotik, industrielle Automatisierung, Sicherheit und Automobilsysteme wird sich diese Full-Stack-Integration von der Überschrift TOPS oder der generischen Modellauswahl allein unterscheiden.
Die nächste Generation intelligenter Wärmebildkameras wird daher dadurch definiert, wie gut die Erfassungsphysik, die rechnergestützte Bildgebung, die eingebettete KI und die Bereitstellungstechnik zusammengeführt werden. Durch die Kombination von Wärmesensor-Expertise, Prism ISP, anwendungsspezifischen Erkennungs- und Tracking-Bibliotheken und Erfahrung bei der Optimierung von Software auf modernen heterogenen Prozessoren hilft Teledyne FLIR OEM Kunden, von Edge-KI-Demonstrationen zu bereitgestellten Wahrnehmungssystemen zu wechseln, die in realen Betriebsumgebungen funktionieren.
[i] https://patentimages.storage.googleapis.com/f5/e3/05/021253fa9a6921/US20220019843A1.pdf
[ii] https://patents.google.com/patent/US20220019843A1/en?oq=17%2f374909
[iii] Eine Übersicht über künstliche Intelligenz in eingebetteten Systemen https://doi.org/10.3390/mi14050897
Zugehörige Artikel
-
 Meldungen
New Qualcomm-Built Advanced Video Processor by Teledyne FLIR Powers AI at the Edge
Bericht lesen -
 Artikel
Simplify MWIR Development with Neutrino Featuring InVeo Electronics
Weitere Informationen -
 Artikel
Comparing Sensitivity of Thermal Imaging Camera Modules
Weitere Informationen