
Au-delà de l’IA intégrée : Optimisation du pipeline de perception thermique, des données du capteur au déploiement en périphérie
RÉSUMÉ
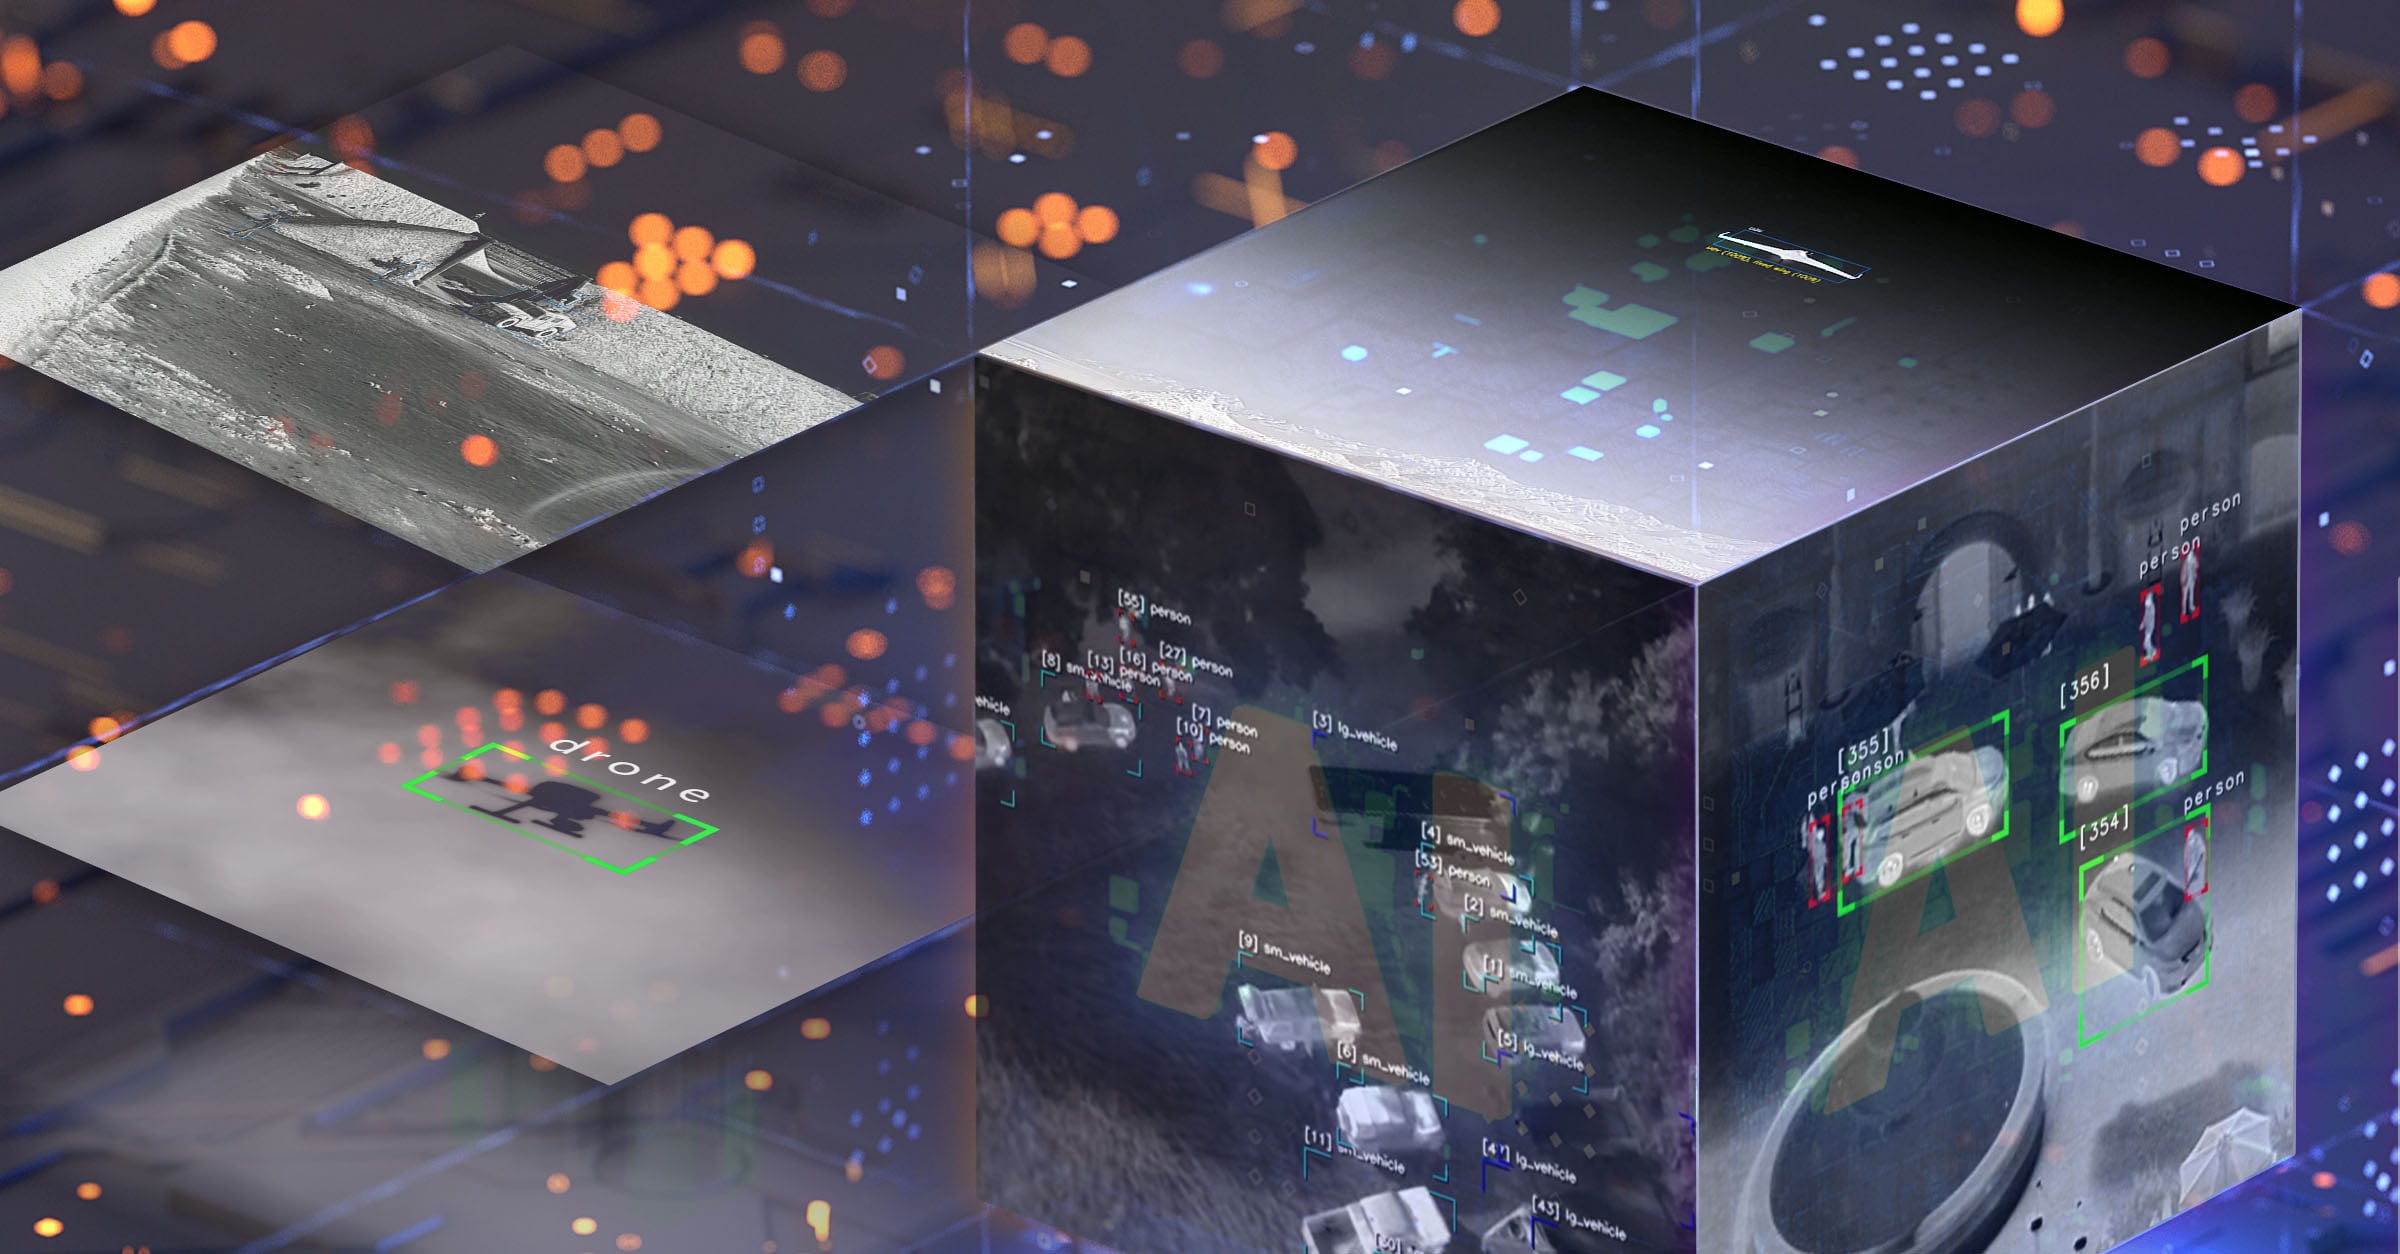
Les progrès rapides de l’apprentissage profond, de l’imagerie informatique et des processeurs intégrés ont permis d’exécuter des charges de travail de perception sophistiquées à la périphérie. Pour les systèmes thermiques et multispectraux, l’avantage concurrentiel va au-delà de la mise en place d’un modèle d’intelligence artificielle (IA) sur un processeur intégré. Le plus grand avantage réside dans l’optimisation du pipeline de perception complet, du traitement des données de capteur et du signal d’image à la détection d’objets, au suivi, à l’optimisation de l’exécution, à la gestion thermique et au déploiement sur le terrain, sous des contraintes réelles en termes de taille, de poids, de puissance, de latence, de bande passante et de conditions environnementales.
Cet article décrit la façon dont Teledyne FLIR OEM intègre le traitement des signaux d’image thermique et multispectrale Prism™, des bibliothèques de détection et de suivi spécifiques à une application et des plateformes d’IA intégrées modernes pour aider les clients à créer des systèmes d’imagerie intelligents qui fournissent des informations exploitables au point de détection.
.
TABLE DES MATIÈRES
- Acroynmes
- Introduction
- Avancées dans les modèles légers et les processeurs mobiles
- Conception d’un réseau neuronal pour les plateformes intégrées - Présentation de PeleeTM
- Optimisation
- La puissance de développement rapide des processeurs mobiles
- Cadres
- Pipeline de traitement vidéo
- Fonctions Prism ISP
- Conclusion
1. Acryonmes
| Acronyme | Définition |
|---|---|
| ADAS | Systèmes avancés d’assistance à la conduite |
| AGC | Contrôle de gain automatique |
| IA | Intelligence artificielle |
| BRAS | Architecture de processeur RISC avancée |
| ASIC | Circuit intégré spécifique à l'application |
| ATR | Reconnaissance automatique des cibles |
| EC | Imagerie numérique |
| CNN | Réseau neuronal convolutif |
| Processeur | Unité centrale |
| DSP | Processeur de signal numérique |
| FFB | Bloc de fusion des fonctionnalités |
| FPGA | Matrice de portes programmable sur site |
| GPU | Unité de traitement graphique |
| HTP | Processeur à tenseur hexagonal |
| ILSVRC | Défi de reconnaissance visuelle à grande échelle ImageNet |
| INT | Format de précision entier, comme en INT8 ou INT4 |
| IP | Propriété intellectuelle |
| IR | Infrarouge |
| ISR | Intelligence, surveillance et reconnaissance |
| FAI | Traitement du signal d’image / Processeur de signal d’image |
| LCE | Amélioration du contraste local |
| MSX | Imagerie dynamique multispectrale |
| NMS | Suppression non maximale |
| NPU | Unité de traitement neuronal |
| ONNX | Ouvrir l’échange de réseau neuronal |
| PANNEAU | Réseau pyramidal de fonctionnalités d’agrégation de chemins |
| RAM | Mémoire à accès aléatoire |
| RISC | Ordinateur avec jeu d’instructions réduit |
| SDK | Software Development kit (Kit de développement logiciel) |
| SLAM | Localisation et cartographie simultanées |
| SoC | Système sur puce |
| SoM | Système sur module |
| SSD | Détecteur monophoto |
| SWaP | Taille, poids et puissance |
| HAUTS | Des milliards d'opérations par seconde |
| YOLO | Vous ne regardez qu’une seule fois |
2. Introduction
Au cours de la dernière décennie, les progrès de l’apprentissage profond ont transformé la vision par ordinateur des systèmes construits autour de l’extraction de fonctionnalités artisanales en modèles basés sur les données, entraînés sur de grands ensembles de données et optimisés pour les tâches de perception spécialisées. Ce changement a fondamentalement changé les défis de la détection d’objets : au lieu de concevoir des fonctionnalités visuelles fixes à la main, les développeurs se concentrent désormais sur la collecte de données d’apprentissage représentatives, la sélection d’architectures de modèle appropriées et l’adaptation de réseaux neuronaux de plus en plus sophistiqués aux conditions de déploiement réelles. Comme c’est souvent le cas dans le développement technologique précoce, moins d’attention a été accordée à la puissance de calcul nécessaire pour entraîner et exécuter ces modèles.
Ce manque de préoccupation limitait la façon dont la nouvelle technologie pouvait être utilisée dans les systèmes basés sur la vision, en particulier les applications centrées sur la vidéo où la nécessité d’une classification des objets en temps réel, de la génération de métadonnées et des alertes est essentielle. Dans le même temps, une course aux armes était organisée dans l’industrie du téléphone mobile autour des performances de la caméra. Cela a conduit au développement rapide de processeurs de signal d’image (ISP) hautement avancés qui ont permis d’améliorer constamment les performances de la caméra à l’aide d’algorithmes et de ce que l’on appelle désormais l’imagerie informatique (IC). Plus récemment, l’adoption rapide de modèles linguistiques de grande envergure, de modèles de vision et d’IA multimodale a augmenté la demande de processeurs hétérogènes qui peuvent exécuter à la fois des pipelines de vision traditionnels et des charges de travail plus récentes inspirées des modèles de fondation plus proches du capteur.
Les processeurs d’aujourd’hui comportent des architectures hétérogènes avec plusieurs unités de traitement centrales (UC), des unités de traitement graphique (UC), des processeurs de signal numérique (DSP), des unités de traitement neuronal (UCN) et des blocs de calcul ISP. De plus, la communauté open source a contribué à bon nombre des éléments de base utilisés pour créer des systèmes de perception, y compris les détecteurs d’objets de la famille YOLO, les modèles de détection basés sur des transformateurs, les formats de fichiers indépendants de la plateforme tels que Open Neural Network Exchange (ONNX), les cadres de développement tels que PyTorch et TensorFlow, et les temps d’exécution de production tels que TensorRT, ONNX Runtime, OpenVINO, LiteRT/TensorFlow Lite et les kits de développement logiciel (SDK) spécifiques au matériel. Il est devenu un flux de travail courant de s’entraîner dans PyTorch ou TensorFlow, d’exporter vers ONNX, d’optimiser et de quantifier pour l’exécution cible, puis de valider la latence, l’alimentation, l’utilisation de la mémoire et la précision directement sur le matériel déployé.
Teledyne FLIR OEM se concentre sur l’intégration de la perception et de l’imagerie informatique ou du traitement du signal d’image dans des processeurs optimisés pour la taille, le poids et la puissance (SWaP) pour un large éventail d’applications. L’exploitation de nouvelles conceptions en silicone fabriquées sur les nœuds les plus avancés permet aux développeurs de systèmes d’augmenter la durée de vie de la batterie et de simplifier la gestion thermique du système.
Il s’agit du défi de conception central pour les systèmes thermiques intelligents. Les techniques d’IA à caméra visible ne peuvent pas simplement être transférées à l’imagerie thermique sans tenir compte de la physique des capteurs, du contenu de texture inférieur, de la variabilité environnementale, des effets atmosphériques, de la taille de la cible, de l’optique, de la fréquence d’images, de l’étalonnage et des étapes de traitement d’image qui façonnent ce que le détecteur voit. En pratique, les performances de détection et de suivi dépendent de l’ensemble de la chaîne : données brutes du capteur, traitement radiométrique ou non radiométrique, cartographie des tonalités, réduction du bruit, stabilisation, super résolution, architecture du modèle, quantification, cartographie de l’exécution, bande passante de la mémoire et gestion de l’alimentation. L’avantage de Teledyne FLIR OEM réside dans sa capacité à optimiser cette chaîne plutôt que de traiter l’inférence IA comme une fonction autonome.
3. Avancées dans les modèles légers
et processeurs mobiles
Une fois que l’impact de l’apprentissage profond sur la vision par ordinateur a été reconnu, le travail a commencé sur le développement de réseaux et de modèles neuronaux qui pouvaient s’exécuter en périphérie sur des processeurs mobiles à faible coût, permettant la détection d’objets pour des applications vidéo en temps réel, y compris la reconnaissance automatique de cible (ATR), l’autonomie des véhicules, les systèmes avancés d’assistance à la conduite (ADAS), la sécurité et pour les renseignements, la surveillance et la reconnaissance (ISR) terrestres et aériens. D’autres progiciels intégrés aux produits basés sur la vision comprennent la localisation et la cartographie simultanées (SLAM), l’évitement des collisions, la fusion de capteurs, le flux optique et le suivi des objets. Ces fonctionnalités informatiques exigeantes, lorsqu’elles sont compilées pour une architecture matérielle spécifique, sont cartographiées entre les sous-systèmes CPU, GPU, DSP, NPU, ISP et mémoire dans le système cible sur puce (SoC). La gestion de ces tâches à travers des processeurs hétérogènes modernes est un défi technique important, mais offre des avantages majeurs en termes d’alimentation, de latence et de gestion thermique par rapport aux architectures dépendantes du cloud. En seulement quelques générations de processeurs, les SoC avancés sont passés de nœuds de classe 10 nm à des conceptions de classe 7 nm, 5 nm et 4 nm, ce qui a permis d’améliorer considérablement les performances par watt.
Tableau 1 - Modules et processeurs d’IA Edge intégrés représentatifs
| PLATEFORME | NŒUD DE PROCESSUS | PERFORMANCES IA | PLAGE DE PUISSANCE | CAS D’UTILISATION LES MIEUX ADAPTÉS |
|---|---|---|---|---|
| Kit de développement NVIDIA Jetson Orin Nano Super | Classe 8 nm | Jusqu’à 67 HAUTS INT8 | 7 W à 25 W configurable | Prototypage, robotique, IA de vision, IA de périphérie multimodale et écosystèmes de développeurs avec prise en charge CUDA et TensorRT. |
| NVIDIA Jetson AGX Orin | Classe 8 nm | Jusqu’à 275 TOPS | 15 W à 60 W configurable | La robotique haute performance, la perception multi-caméras, les systèmes autonomes et les charges de travail d’IA de périphérie plus importantes. |
| Qualcomm Dragonwing QCS8550 | 4 nm | Jusqu’à 48 INT8 TOPS, selon la mise en œuvre du module | Dépend de l’application | Des caméras intelligentes, des drones industriels, des robots mobiles autonomes, des boîtiers d’IA de pointe et des plateformes IdO à faible consommation hautement intégrées. |
| Accélérateurs Hailo-8 / Hailo-10-class | En fonction de l’accélérateur | Des dizaines à des centaines de TOPS, en fonction de l’appareil | Classe d’accélérateurs basse puissance | Accélération de la vision dans les caméras, les passerelles, les systèmes industriels et les déploiements sensibles aux coûts ou à l’alimentation. |
Le traitement du signal d’image et les algorithmes de détection d’objets IA sont coûteux en calcul. Par exemple, les algorithmes avancés de réduction du bruit et de super résolution de Teledyne FLIR OEM effectuent jusqu’à 100 000 opérations par pixel par seconde (environ 2 billions d’opérations par seconde (TOPS) pour une résolution d’entrée de 640 x 512 à 60 images par seconde (ips)) et s’exécutent sur un cœur GPU. L’exécution de modèles de détection d’objets volumineux consomme également beaucoup de puissance de traitement et s’exécute sur le sous-système DSP (Qualcomm®) ou le GPU (NVIDIA®).
Pour les systèmes thermiques, TOPS brut est une mesure utile mais incomplète. Les performances réelles dépendent de l’efficacité avec laquelle chaque étape du pipeline est cartographiée à la ressource de calcul appropriée, du nombre de fois que les données vidéo doivent se déplacer dans la mémoire, de l’amélioration ou de la dégradation de l’amélioration de l’image, et de la capacité du système complet à maintenir les fréquences d’images requises sans dépasser les limites de puissance ou thermiques. Les conceptions d’IA intégrées les plus efficaces commencent donc par le problème de détection et l’environnement de déploiement, et non par la seule spécification du processeur.
Il existe de nombreuses variables à prendre en compte lors du développement et du déploiement d’un détecteur d’objets, notamment l’architecture du processeur, la précision souhaitée, la latence ou la fréquence d’images acceptable, la bande passante de la mémoire, l’autonomie du logiciel, la taille du modèle et le budget énergie/thermique. En réponse aux demandes d’exécution de détecteurs d’objets sur des processeurs intégrés, plusieurs réseaux neuronaux de faible puissance ont été développés, notamment You Only Look Once (YOLO) par Joseph Redmon de l’Université de Washington en 2015 et MobileNet par Google en 2017. Depuis lors, le paysage des détecteurs s’est considérablement étendu pour inclure des modèles de la famille YOLO plus récents, des détecteurs basés sur des transformateurs, des architectures sans suppression maximale (NMS) et des modèles conçus pour la perception multitâche et la détection du vocabulaire ouvert. Pour les systèmes thermiques et multispectraux intégrés, la question la plus importante n’est pas simplement de savoir quel réseau est le plus récent, mais quel modèle offre les performances de détection, la latence, la consommation d’énergie et la fiabilité d’intégration requises sur le processeur sélectionné.
YOLO a révolutionné la détection d’objets grâce à son approche en un seul passage. Contrairement aux réseaux neuronaux convolutifs basés sur la région (RCNN) impliquant plusieurs étapes telles que des propositions de région suivies d’une classification, YOLO effectue la détection et la localisation en un seul passage avant du réseau. En divisant une image d’entrée en grille et en prédisant simultanément plusieurs cadres de délimitation et probabilités de classe pour chaque cellule de grille, l’algorithme YOLO offre à la fois vitesse et précision. Les détecteurs à une étape utilisent un seul réseau d’anticipation pour prédire directement les classes et les emplacements des objets. Le détecteur à une seule image (SSD) améliore le YOLO dans plusieurs aspects, notamment en utilisant plusieurs échelles de fonctionnalités pour la prédiction et en utilisant des cases et des rapports d’aspect par défaut pour s’adapter à différentes formes d’objet. Bien que les approches en deux étapes produisent généralement une précision supérieure, les approches en une étape fonctionnent souvent à une efficacité supérieure. Les nouveaux détecteurs continuent d’améliorer cet espace commercial grâce à une meilleure agrégation des fonctionnalités, une conception compatible avec la quantification, des mécanismes d’attention inspirés des transformateurs et des architectures conviviales qui réduisent les frais généraux de post-traitement.
4. Conception d’un réseau neuronal pour les plateformes intégrées - Présentation de Pelee

Figure 1 - Architecture du détecteur d’objets (Juan R. Terven, 2023)
La conception de la détection d’objets pour les caméras thermiques nécessite un point de départ différent de celui de la sélection d’un modèle de vision polyvalent. L'imagerie thermique contient souvent moins de textures visuelles que l'imagerie visible ; les cibles peuvent n'occuper qu'un petit nombre de pixels ; et les conditions environnementales peuvent modifier le contraste, la forme apparente et l'encombrement de l'arrière-plan. Ces facteurs rendent important la co-conception du détecteur avec le capteur, l’optique, le pipeline de traitement d’images et le matériel de déploiement.
L’OEM Teledyne FLIR a étendu l’approche en un seul passage avec le développement de son réseau Pelee (brevet en attente). Les réseaux neuronaux convolutifs (CNN) se composent de trois blocs principaux : l’extracteur ou le réseau fédérateur de fonctionnalités, un agrégateur ou un cou de fonctionnalités et le détecteur de tête ou d’objet. Pelee présente une nouvelle conception de base qui est construite avec un modèle de connectivité dense pour encourager la réutilisation des fonctionnalités, et une couche dense bidirectionnelle pour obtenir différentes échelles de champs réceptifs. Pelee intègre un nouveau bloc de fusion de fonctionnalités (FFB) basé sur le réseau de pyramides de fonctionnalités d’agrégation de voies (PANet). Conçue pour la détection des petites cibles, la nouvelle FFB adopte une stratégie de fusion tardive, qui vise à garantir que chaque carte de caractéristiques de la sortie conserve les informations détaillées apprises des couches peu profondes et acquiert des caractéristiques sémantiques de haut niveau.
Tableau 2 - Ressources de base
| CADRE | ÉPINE DORSALE | COÛT INFORMATIQUE (FLOPS) | ||
|---|---|---|---|---|
| Arrière-plan | Total | Partie de la colonne vertébrale | ||
| SSD | VGG | 31,9 | 34,2 | 93,3 % |
| RaffinerDet | VGG | 31,9 | 37,38 | 85,3 % |
| YOLOv3 | DarkNet 53 | 14,51 | 19,54 | 74,2 % |
| RetinaNet | ResNet101 | 15,48 | 34,51 | 53,4 % |
Le réseau de base affecte directement la mémoire, la vitesse et les performances du détecteur d’objets. Dans SSD CNN, plus de 90 % du coût de calcul est consommé par le réseau de base. Le CNN OEM de Teledyne FLIR intègre une nouvelle conception de base qui évite d’utiliser un bloc de compression et d’excitation, sélectionne soigneusement les fonctions d’activation en fonction du matériel et ajuste la largeur et la profondeur du réseau en fonction du matériel.
Pelee doit donc être comprise comme une architecture de détecteur spécifique à une application, orientée sur le déploiement, plutôt que comme un gagnant de référence à usage général pour chaque nouvelle famille de modèles. Sa valeur réside dans l’espace commercial de l’ingénierie qui compte pour les caméras thermiques intelligentes : performances de petite cible, latence prévisible, efficacité de la mémoire, choix d’activation matérielle et capacité à s’exécuter en parallèle avec les fonctions Prism ISP, stabilisation vidéo, suivi et autres charges de travail de perception dans une enveloppe SWaP limitée.

Figure 2 - Performances du modèle basé sur la colonne vertébrale

Figure 3 – Comparaison des performances des réseaux Pelee et YOLO
5. Optimisation
Quantification
La quantification est la compression de valeurs à virgule flottante dans les paramètres du réseau neuronal pour améliorer la latence du modèle, réduire l’empreinte mémoire et réduire la consommation d’énergie lors de l’exécution de l’inférence. L’apprentissage du modèle est généralement effectué à l’aide de données à virgule flottante 32 bits sur de puissants systèmes basés sur GPU. L’inférence sur les processeurs intégrés est ensuite optimisée à l’aide de FP16, FP8, INT8, INT4 ou d’autres précisions prises en charge par l’exécution en fonction du processeur, de l’architecture du modèle, des données d’étalonnage et des compromis de précision acceptables.
Teledyne FLIR OEM utilise INT8 pour réduire l’empreinte mémoire, le temps de calcul et la consommation d’énergie, car il reste un compromis pratique entre précision et vitesse pour de nombreuses charges de travail de vision intégrées. Cependant, le déploiement dépend désormais de plus en plus de flux de travail de quantification explicites, de données d’étalonnage représentatives, d’une formation axée sur la quantification lorsque nécessaire et de la génération de moteurs spécifiques à la cible. Les développeurs doivent valider les options FP16, INT8 et de moindre précision sur le matériel réel, car les performances, la précision, l’utilisation de la mémoire et le comportement thermique peuvent varier considérablement entre les implémentations GPU, DSP, NPU et d’exécution spécifiques au fournisseur. Le rétablissement des ressources de calcul donne aux développeurs la flexibilité d’ajouter plus de capacités, y compris l’inférence en temps réel sur deux flux de caméras ou plus.
Taille
L’élagage est une méthode utilisée pour réduire les chemins de données inutilisés dans le réseau neuronal en déterminant l’importance de chaque unité et en supprimant les chemins passifs. Après la formation, de nombreux neurones du réseau ont une valeur de poids de 0, de sorte que ces neurones peuvent être éliminés par un processus d’entraînement du réseau secondaire après la quantification. Les méthodes d’élagage actuelles comprennent l’élagage du poids, l’élagage des canaux et l’élagage des neurones, chacun avec ses avantages et ses inconvénients.
Les critères permettant de déterminer l’importance de l’unité peuvent avoir un impact sur la précision. L’utilisation de méthodes d’apprentissage des contraintes peut l’améliorer, bien que la mise en œuvre soit complexe. La méthode de recherche aléatoire est simple à mettre en œuvre, mais les performances du modèle réseau sont limitées par rapport à d’autres méthodes qui l’améliorent. Par conséquent, chaque méthode doit être sélectionnée en conjonction avec le scénario d’application réel. Il n’existe pas de méthode unique capable de synthétiser la complexité et l’efficacité de la compression du modèle.[i]
Gestion thermique
Pour de nombreuses catégories de produits, y compris les drones et les viseurs d’armes, la consommation d’énergie est une contrainte de conception critique. Une consommation élevée limite le temps de fonctionnement, ajoute des défis logistiques d’assistance et ajoute de la complexité et des coûts pour la gestion thermique. Pour certains appareils fonctionnant sur batterie, le choix est d’utiliser un réseau de portes programmables sur le terrain (FPGA) ou un processeur de circuit intégré spécifique à l’application (ASIC) pour maintenir l’alimentation à un minimum absolu, mais les analyses tierces et les logiciels ISP ne sont pas disponibles, car ces bibliothèques sont généralement compilées pour s’exécuter sur des processeurs Advanced RISC Machine (ARM) et d’autres cœurs à l’aide de composants et de cadres open source comme OpenCV. Bien que ce ne soit pas le cas pour les produits les plus soumis à des contraintes de puissance, les exigences de puissance des processeurs intégrés de nouvelle génération fabriqués sur des nœuds de 4 nm à 7 nm offrent aux concepteurs de systèmes de nombreuses options pour ajouter des capacités de grande valeur aux produits.
Pour un système exécutant plusieurs caméras et plusieurs routines de fonctionnalités telles qu’un détecteur d’objet, un traceur de cible et une amélioration du contraste local, le développeur atteindra la limite supérieure du débit du processeur et générera beaucoup de chaleur. Pour aider à gérer cela, les développeurs de logiciels peuvent intégrer des paramètres de configuration qui peuvent être définis ou ajustés dynamiquement. Par exemple, pour de nombreuses applications, il n’est pas nécessaire d’effectuer une inférence à la fréquence d’images. En réduisant la sortie d’inférence à 10 i/s ou moins, le profil de puissance de l’ensemble de la pile logicielle peut être géré pour correspondre au budget énergétique.
6. La puissance de développement rapide
des processeurs mobiles
L’exécution de modèles CNN et d’algorithmes CI est extrêmement exigeante sur le plan informatique. Jusqu’à récemment, les processeurs intégrés n’avaient pas la capacité de répondre aux charges de travail d’IA et de CI. L’IA nécessite un parallélisme massif des fonctions de multi-accumulation. Les GPU traditionnels ont pu effectuer le parallélisme de la même manière pour les graphiques, de sorte qu’ils ont été réutilisés pour les applications d’IA, en particulier pour l’apprentissage des modèles. Par conséquent, NVIDIA s’est imposée comme le principal acteur de l’entraînement des modèles.
Les processeurs mobiles et intégrés d'aujourd'hui sont des prouesses d'ingénierie incroyables. Par exemple, le SoC Dragonwing QCS8550 de Qualcomm est une conception 4 nm qui comprend un processeur, un GPU, un DSP, un NPU, une vision par ordinateur et des ressources dédiées ISP pour les applications IoT et d’IA de pointe exigeantes. Les ressources intégrées de vision par ordinateur et ISP prennent en charge des fonctions telles que le bruit vidéo, la stabilisation, la correction d’image, la balance des blancs, le traitement des couleurs, le contrôle automatique du gain, la mise au point et d’autres fonctions de la caméra. Cette catégorie de puce nécessite un investissement de développement considérable et dépend de capacités de fonderie avancées, d’outils logiciels et d’une prise en charge à long terme de l’écosystème.

Figure 5 - Cœurs de processeur QCS 8550
Teledyne FLIR OEM souhaitait créer une plateforme sur laquelle les clients pouvaient construire leurs produits et permettrait la création de piles logicielles hautement intégrées et minimiser les coûts, la latence et la puissance en utilisant un seul processeur lorsque cela était possible. C’est l’objectif de plusieurs générations de plateformes, y compris la sélection du processeur Intel® Myriad™ pour le module de caméra infrarouge thermique (IR) OEM Boson® de Teledyne FLIR. L’architecture de la puce Myriad ne pouvait pas répondre aux besoins de calcul plus lourds de l’imagerie informatique ou des détecteurs d’objets basés sur CNN. Avec l’introduction des modules NVIDIA Xavier, NVIDIA Jetson de classe Orin, Qualcomm RB5/QCS5165 et Qualcomm QCS8550-class, il est devenu pratique d’exécuter plusieurs piles logicielles réparties sur des cœurs de processeur et des accélérateurs spécifiques.
Présentation du système sur puce (SoC)
Les processeurs intégrés d’aujourd’hui exploitent les derniers nœuds de fonderie, permettant des conceptions multicœurs avec une mémoire unifiée. Les fournisseurs de processeurs offrent une assistance de développement très complète, et les développeurs peuvent déployer leur code sur ces processeurs multicœurs pour maximiser les performances tout en respectant les budgets énergétiques et thermiques.
Processeur
La fonctionnalité principale de l’UC est de récupérer les instructions de la mémoire vive (RAM), puis de décoder et d’exécuter les instructions. Les processeurs sont des processeurs généralistes conçus pour exécuter des routines qui gèrent des charges de travail séquentielles. De nombreux processeurs disposent de processeurs vectoriels intégrés pour accélérer certaines opérations (par ex. NEON sur les processeurs basés sur ARM). Plusieurs des capacités de produits numériques OEM de Teledyne FLIR s’exécutent sur des cœurs de processeur, y compris le traceur vidéo de corrélation Prism ISP et la stabilisation vidéo électronique. Étant donné le grand nombre de cœurs CPU disponibles sur les SoC de la génération actuelle, les développeurs disposent d’une flexibilité considérable pour optimiser les performances et la puissance. Les processeurs ne conviennent pas aux tâches nécessitant un grand nombre d’opérations mathématiques par pixel. Les processeurs ont des limitations de débit et consomment une puissance relativement élevée par opération.
GPU
Les charges de travail d’IA et d’IC sont massives, exigeant une quantité importante de bande passante et de puissance de traitement. Les concepteurs de processeurs ont créé de puissantes architectures de puces intégrant la mémoire, la sécurité et la connectivité des données en temps réel. Les processeurs traditionnels manquent généralement des performances de traitement nécessaires, mais sont parfaits pour effectuer des tâches séquentielles. Les GPU peuvent gérer le parallélisme des fonctions d’accumulation multipliée de l’IA et peuvent être appliqués aux applications d’IA. En fait, les GPU peuvent servir d’accélérateurs d’IA, améliorant les performances des réseaux neuronaux et des charges de travail similaires. Les GPU peuvent avoir des milliers de cœurs de calcul et sont utilisés pour de nombreuses tâches de traitement parallèles. Les GPU sont particulièrement utiles pour les modèles d’entraînement. Cependant, les GPU consomment une puissance importante et ont des exigences de mémoire sur puce plus élevées. Pour cette raison, les processeurs mobiles modernes utilisent des coprocesseurs d’IA dédiés qui utilisent des processeurs de signal numérique (DSP) pour exécuter l’inférence à la périphérie.
DSP
Les DSP sont des sous-systèmes SoC spécialisés et économes en énergie optimisés pour exécuter des opérations mathématiques. Ils utilisent de larges mots d’instruction pour optimiser le traitement par cycle d’horloge. Cependant, elles ne sont pas aussi faciles à programmer et nécessitent une connaissance des fonctionnalités du matériel DSP, de l’environnement de programmation et de l’optimisation du logiciel DSP pour obtenir les meilleures performances. Le processeur Tensor (HTP) Qualcomm Hexagon™ est un accélérateur d’IA adapté à l’exécution de charges de travail d’IA intensives sur le plan informatique. Pour améliorer les performances et exécuter un modèle d’IA sur HTP, un modèle doit être quantifié selon l’une des précisions prises en charge : INT4, INT8, INT16 ou FP16.
FAI
Étant donné que la photographie numérique est la première ligne de la bataille concurrentielle dans le secteur des combinés mobiles, les fournisseurs de processeurs mobiles intègrent des blocs de propriété intellectuelle (IP) en silicium dédiés pour effectuer des fonctions d’amélioration de l’image, notamment la réduction du bruit, la correction de la distorsion de l’objectif, l’équilibrage des blancs, l’exposition automatique, la mise au point automatique, la suppression des moustiquaires et la compression d’image. Au niveau du système, le réglage ISP est généralement nécessaire pour optimiser les paramètres et divers filtres pour un capteur d’image et un objectif spécifiques. Le réglage précis des FAI est un secteur en soi. De nombreux fournisseurs de SoC offrent des bibliothèques ISP pour les capteurs d’image populaires, ce qui permet potentiellement aux développeurs de systèmes d’économiser des investissements importants.
Les fournisseurs de processeurs mobiles ne justifient que peu la conception et la fabrication d’un FAI de caméra thermique. Cependant, les avantages du traitement du signal d’image sont précieux, c’est pourquoi Teledyne FLIR OEM a développé un ensemble complet de fonctionnalités ISP, notamment la cartographie des tonalités de 16 à 8 bits (contrôle automatique du gain), la réduction du bruit spatiotemporel, la super résolution, l’atténuation des turbulences et la stabilisation électronique de l’image. La plupart de ces algorithmes s’exécutent sur des GPU en raison des exigences de traitement importantes.
Mémoire
Étant donné les débits de données élevés dans les flux vidéo numériques et le fait que les données peuvent être lues à plusieurs reprises par plusieurs algorithmes, la capacité de mémoire et la bande passante de la mémoire sont essentielles pour un traitement efficace du signal. Grâce à une combinaison de vitesses d’horloge accrues, de bande passante mémoire supérieure, d’accélération dédiée de l’IA et d’optimisation logicielle améliorée, le plus grand modèle d’IA existant de Teledyne FLIR (résolution d’entrée de 768 x 768 pixels) est exécuté en 6 ms sur le Qualcomm QCS8550 contre 33 ms sur le QRB5165. Cela représente une augmentation de plus de 5X de la vitesse d’inférence et donne une marge sûre pour obtenir une inférence à la fréquence d’images pour les caméras de résolution SXGA de nouvelle génération (1 280 x 1 024).
7. Cadres
Les cadres d’IA sont des éléments de base qui façonnent la façon dont les systèmes intelligents sont créés, optimisés et déployés. Ces cadres, équipés de bibliothèques et de fonctions prédéfinies, permettent aux développeurs de concevoir des algorithmes d’IA sophistiqués sans avoir à concevoir chaque fonction à partir de zéro. Dans les systèmes d’IA en périphérie de production, la discussion sur le cadre s’étend désormais au-delà de la formation aux modèles pour inclure les formats d’exportation, l’optimisation des temps d’exécution, les outils de quantification, les compilateurs spécifiques au matériel, les tests de régression, les stratégies de mise à jour en direct et la surveillance des performances au niveau de la flotte.
PyTorch reste largement utilisé pour la recherche, l’expérimentation et le développement de modèles en raison de sa flexibilité et de son modèle d’exécution convivial. Son graphique de calcul dynamique permet aux développeurs de modifier le comportement des modèles à la volée et d’utiliser les opérations de flux de contrôle Python, ce qui le rend bien adapté aux architectures de modèles complexes, au prototypage rapide et à l’expérimentation itérative.
TensorFlow reste important dans les environnements de production et les flux de travail de déploiement mobile, en particulier lorsque TensorFlow Lite ou LiteRT est déjà intégré. Cependant, le déploiement embarqué moderne est rarement un choix simple de PyTorch-versus-TensorFlow. Un chemin de production courant consiste à s’entraîner dans PyTorch ou TensorFlow, à exporter vers ONNX ou une autre représentation portable, à optimiser le graphique, à quantifier le modèle, à compiler vers une autonomie telle que TensorRT, ONNX Runtime, OpenVINO, LiteRT/TensorFlow Lite ou Qualcomm AI Engine Direct, puis à valider la latence, la précision, la puissance et le comportement thermique sur le dispositif cible. Le meilleur cadre est donc celui qui prend en charge le pipeline de déploiement complet pour le processeur et l’application sélectionnés, et pas seulement celui qui est le plus pratique pendant la formation.
8. Pipeline de traitement vidéo
Le pipeline de traitement vidéo est l’endroit où l’approche OEM de Teledyne FLIR se différencie le plus. Au lieu de traiter la caméra, le FAI, le détecteur, le traceur et le processeur intégré comme des composants indépendants, le pipeline est conçu comme un système connecté. Chaque étape affecte la suivante : la réduction du bruit modifie la texture de la cible, l’amélioration du contraste modifie la distribution des entrées du modèle, la stabilisation améliore la cohérence temporelle, la super résolution peut améliorer les détails efficaces et le suivi convertit les détections image par image en informations persistantes. L’optimisation de ces interactions est essentielle pour une perception fiable des contours.
Teledyne FLIR OEM a développé Prism ISP, une collection de bibliothèques de logiciels de traitement d’images pour les images thermiques qui comprennent l’amélioration du contraste local (LCE), la réduction du bruit spatial et temporel, la stabilisation d’image électronique, l’atténuation des turbulences, la super-résolution et plusieurs techniques de fusion vidéo. Ces fonctions améliorent la qualité d’image pour l’interprétation humaine tout en modelant les informations présentées aux algorithmes de détection et de suivi en aval. L’objectif est à la fois de rendre la vidéo plus belle et d’améliorer la fiabilité, l’efficacité et la déployabilité de l’ensemble du pipeline de perception thermique tout en minimisant les besoins en énergie et les coûts. Les modules de caméra thermique de Teledyne FLIR OEM n’incluent pas de processeurs intégrés pour exécuter Prism ISP. Avec la disponibilité de processeurs mobiles et intégrés modernes, il est désormais pratique d’ajouter un module électronique accessoire avec la puissance d’exécuter des algorithmes ISP, de détection et de suivi à des fréquences d’images vidéo utiles tout en répondant aux contraintes thermiques et d’alimentation réelles.

Figure 6 - Pipeline de traitement vidéo Prism
L’imagerie thermique est utilisée dans de nombreux cas d’utilisation pour visualiser les objets : à des mètres de distance pour l’inspection et la lutte contre les incendies ; à plusieurs kilomètres en intelligence, surveillance et reconnaissance (ISR) ; et depuis des perspectives aériennes, basées sur des tours et au sol. La combinaison de la portée, de la perspective et des conditions environnementales de jour, de nuit et météorologiques crée des défis d'imagerie réels qui peuvent être atténués grâce aux fonctions de l'algorithme Prism ISP.
9. Fonctions Prism ISP
Atténuation des turbulences

Figure 7 - comparaison sans (gauche) et avec (droite) atténuation des turbulences
Les turbulences atmosphériques font référence au mouvement irrégulier et chaotique du liquide ou de l’air caractérisé par des fluctuations de vitesse, de pression et de densité. Les turbulences affectent la transmission des photons, car le gain solaire de la surface provoque le mélange de l’atmosphère. Il recourbe l'air et provoque une modification de la réfraction du signal infrarouge par la vapeur d'eau, la fumée et d'autres substances. Des techniques avancées éliminent les effets de distorsion tout en conservant une bonne qualité d’élément d’image temporelle, ce qui signifie que les objets en mouvement ne sont pas transformés en blobs ou stries indifférenciables. Cela est essentiel lors de la détection de cibles, y compris les personnes et les véhicules, à l’aide de l’IA.
Pour la détection et le suivi par IA, l’atténuation des turbulences est plus qu’une fonctionnalité de qualité d’image. La distorsion, le scintillement et le mouvement apparent peuvent réduire la confiance du détecteur et rendre les pistes moins stables. En améliorant la cohérence temporelle avant l’inférence et le suivi, le pipeline peut fournir des informations cibles plus fiables sans dépendre uniquement de modèles plus importants ou de budgets de calcul plus élevés.
Les principaux objectifs des algorithmes d’atténuation des turbulences sont d’améliorer la qualité du signal, de réduire le bruit et de restaurer la clarté et la stabilité dans des conditions turbulentes. L'algorithme Prism ISP utilise diverses techniques mathématiques et de traitement des signaux pour analyser et traiter les données affectées par les turbulences.
- Acquisition de données : La première étape consiste à acquérir les données affectées par les turbulences. Elle est présentée sous la forme d’images.
- Prétraitement : Les données acquises sont prétraitées pour supprimer le bruit ou les artefacts qui ne sont pas directement liés aux turbulences. Cela implique des techniques de filtrage, de réduction du bruit et d’étalonnage pour améliorer la qualité du signal.
- Estimation des turbulences : Il est essentiel d’estimer les caractéristiques de turbulence présentes dans les données. Cela implique d’analyser les propriétés statistiques des fluctuations et d’identifier les paramètres pertinents tels que l’intensité des turbulences, la durée de corrélation et les échelles de temps.
- Déconvolution ou reconstruction : Les techniques de déconvolution tentent d’inverser les effets flous causés par les turbulences. Les algorithmes de déconvolution utilisent souvent des modèles mathématiques de turbulence ou de connaissances empiriques pour restaurer le signal original.
- Filtrage adaptatif : Les conditions de turbulence peuvent varier au fil du temps et de l’espace, de nombreux algorithmes d’atténuation des turbulences utilisent donc des techniques de filtrage adaptatives. Ces méthodes ajustent dynamiquement les paramètres de filtrage en fonction des paramètres de turbulence estimés pour optimiser le compromis entre la réduction du bruit et la préservation des caractéristiques essentielles du signal.
- Post-traitement : Après les étapes d’atténuation des turbulences, un post-traitement supplémentaire peut être effectué pour améliorer davantage la qualité et réduire les artefacts dans la sortie finale. Selon l’application spécifique, cela peut impliquer des techniques telles que le bruit, l’accentuation, l’amélioration du contraste ou l’extraction de fonctionnalités.
Super résolution

Figure 8 – comparaison sans (gauche) et avec (droite) super résolution
La super-résolution multi-images est une technique puissante qui vise à reconstruire une image haute résolution à partir d’une ou plusieurs images basse résolution. La résolution optique d’un système est limitée par la limite de diffraction définie par l’ouverture du système et la résolution d’échantillonnage du détecteur. Une petite ouverture et un capteur basse résolution se traduiront par un système moins cher et plus petit qui se traduira par des images de mauvaise qualité avec des bords fortement aliasés et/ou flous. Cela est particulièrement vrai lorsque les cibles à longue portée sont capturées à l’aide d’une optique à longue distance focale qui adapte les effets de la diffraction lorsqu’elle est combinée à une taille d’ouverture limitée. En utilisant des algorithmes sophistiqués, la super-résolution reconstruit les images haute résolution à l’aide des données des entrées dégradées. Alors que les méthodes traditionnelles se sont principalement concentrées sur l’exploitation des corrélations spatiales inhérentes aux images basse résolution, les avancées récentes ont démontré l’efficacité de l’utilisation des techniques de crénelage pour obtenir des résultats supérieurs.
Dans un pipeline de perception, la super résolution peut également affecter la portée de détection, la classification des petites cibles et la confiance de l’opérateur. L’avantage doit être évalué au niveau du système, car l’accentuation ou les artefacts de reconstruction peuvent aider à l’interprétation visuelle, mais peuvent également modifier la distribution d’entrée observée par un modèle d’IA. Cela renforce la nécessité d’ajuster le FAI et la détection ensemble plutôt que sous forme de fonctions isolées.
Stabilisation de l'image

Figure 9 - Applications typiques de la stabilisation électronique
Les caméras sont souvent montées sur des plateformes mobiles telles que les véhicules terrestres, les bateaux, les avions, les drones ou les tours. Le mouvement de la plate-forme se transfère directement sur l’image vidéo, ce qui peut entraîner une fatigue du spectateur et une mauvaise qualité d’image, ce qui a un impact sur la perception de la situation et la fidélité des preuves. La stabilisation électronique élimine la plupart des distorsions d’image induites par le mouvement, en particulier lors de l’imagerie à travers une optique de zoom à champ de vision étroit utilisée pour l’imagerie longue portée.
Pour une perception automatisée, la stabilisation améliore la cohérence temporelle et peut réduire le déclenchement de fausses pistes, les détections manquées et la fatigue de l’opérateur. Elle aide également les algorithmes en aval à utiliser plus efficacement les signaux de mouvement, car le mouvement de l’image causé par la plateforme est réduit avant que la détection et le suivi ne soient effectués.
MSX - Imagerie dynamique multispectrale

Figure 10 - Le MSX superpose les bords visibles sur les images thermiques en temps réel
Il existe de nombreuses approches différentes pour la fusion d’images ou le mélange d’images thermiques et visibles dans un seul flux vidéo fusionné. L’objectif est de faire ressortir les informations uniques et précieuses de chaque spectre sans nécessiter la transmission de deux flux ou plus pour les opérateurs ou systèmes humains en aval à analyser. Cela peut être complexe en pratique en raison du besoin d’un enregistrement parfait de l’image (alignement) de deux canaux ou plus et de problèmes en raison des différents temps d’intégration pour chaque capteur.
Teledyne FLIR OEM a breveté une technologie unique appelée MSX (imagerie dynamique multispectrale). Contrairement au mélange d’images (mélange d’une lumière visible et d’une image thermique), MSX ne supprime pas les détails thermiques et ne diminue pas la transparence thermique. Au lieu de cela, il applique un filtre haute fréquence pour extraire des détails visibles nets comme la symbologie, y compris les contours, les mots, les chiffres et d’autres détails de bord à contraste élevé, et les superpose sur l’image thermique. Cela permet de définir l’image et s’est avéré être une technologie bénéfique dans des domaines tels que la maintenance prédictive, la sécurité et les applications ISR aériennes.
AGC – Contrôle automatique du gain

Figure 11 - Amélioration du contraste local (vidéo source Boson® 640)
Dans le contexte des images, le contraste fait référence à la différence d’intensité entre les régions les plus lumineuses et les plus sombres. Elle joue un rôle crucial dans la définition de l’impact visuel global d’une image. L’amélioration du contraste local, également appelée étirement du contraste local, fonctionne selon le principe d’étendre la plage dynamique de contraste dans des régions spécifiques d’une image plutôt que de modifier globalement le contraste de l’image entière.
L’amélioration du contraste local met en évidence des détails complexes, améliore les textures et accentue les fonctionnalités. La conversion des données brutes du capteur monochrome 16 bits en profondeur de couleur 8 bits que nous voyons sur les écrans repose sur des algorithmes pour cartographier la distribution étendue des valeurs de pixels dans l’une des 256 nuances de couleur ou de gris. Étant donné que la distribution des valeurs de pixels dans une image est rarement linéaire, maximiser le contraste est très complexe et dynamique d’un scénario à l’autre. Contrairement à l’amélioration globale du contraste, qui ajuste le contraste uniformément sur toute l’image, l’amélioration locale du contraste se concentre sur la préservation des détails locaux et des textures fines. Il cible des régions plus petites de l’image et amplifie le contraste dans ces régions tout en conservant les relations de contraste relatives entre les régions voisines.
Pour les pipelines d’IA, la cartographie des tonalités et l’amélioration du contraste local doivent être gérées avec soin, car elles façonnent l’entrée numérique du détecteur. Un réglage visuellement agréable peut ne pas toujours maximiser la confiance du modèle, réduire les fausses alarmes ou préserver les détails des petites cibles. L’approche au niveau du pipeline de Teledyne FLIR OEM permet d’évaluer ces choix de traitement d’image par rapport aux objectifs finaux du système de détection, de suivi et d’aide à la décision fiables dans l’enveloppe SWaP disponible.
10. Conclusion
Des progrès remarquables ont été réalisés dans l’apprentissage profond, les processeurs intégrés et les outils de déploiement de l’IA de production. Pour les systèmes thermiques et multispectraux, ces avancées sont importantes, mais elles ne suffisent pas à elles seules. Le marché va au-delà de la question de savoir si l’IA peut fonctionner à la périphérie. La question la plus importante est de savoir si le pipeline de perception complet peut être conçu pour fournir des informations fiables et exploitables sur le terrain tout en répondant aux contraintes exigeantes de SWaP, de latence, de bande passante et de température.
L’avantage de Teledyne FLIR OEM va au-delà de la simple exécution de l’IA sur les processeurs intégrés. Il permet d’optimiser l’ensemble du pipeline de perception thermique des données des capteurs, du traitement du signal d’image, de la conception du modèle, de la quantification, du déploiement en cours d’exécution, du suivi, de l’utilisation de la mémoire, de la gestion de l’énergie et de la robustesse environnementale en tant que système intégré. Dans les applications pratiques dans les systèmes de défense, d’autonomie, de robotique, d’automatisation industrielle, de sécurité et automobiles, la différenciation découlera de cette intégration complète plutôt que de TOPS en titre ou d’une sélection de modèles génériques uniquement.
La prochaine génération de caméras thermiques intelligentes sera donc définie par la façon dont la physique de détection, l’imagerie informatique, l’IA intégrée et l’ingénierie de déploiement sont réunies. En combinant l’expertise des capteurs thermiques, Prism ISP, les bibliothèques de détection et de suivi spécifiques aux applications et l’expérience de l’optimisation logicielle sur les processeurs hétérogènes modernes, Teledyne FLIR OEM aide les clients à passer des démonstrations d’IA en périphérie aux systèmes de perception déployés qui fonctionnent dans des environnements d’exploitation réels.
[i] https://patentimages.storage.googleapis.com/f5/e3/05/021253fa9a6921/US20220019843A1.pdf
[ii] https://patents.google.com/patent/US20220019843A1/en ?oq=17 %2f374909
[iii] Un examen de l’intelligence artificielle dans les systèmes intégrés https://doi.org/10.3390/mi14050897
Articles connexes
-
 Actualités
New Qualcomm-Built Advanced Video Processor by Teledyne FLIR Powers AI at the Edge
Lire le témoignage -
 Article
Simplify MWIR Development with Neutrino Featuring InVeo Electronics
En savoir plus -
 Article
Comparing Sensitivity of Thermal Imaging Camera Modules
En savoir plus